将Hive表数据导入CSV数据库的核心在于利用Hive的INSERT OVERWRITE DIRECTORY命令将数据导出为本地或HDFS文件,再通过Sqoop或Flume等工具将文件加载至目标关系型数据库中,这一过程需重点关注数据编码一致性与字段分隔符配置。
在大数据生态系统中,Hive通常作为数据仓库的核心组件,存储着海量的结构化数据,许多业务场景需要将这部分历史数据或离线分析结果同步到传统的MySQL、PostgreSQL等关系型数据库中,以便进行实时查询或前端展示,这种跨系统的数据流转并非简单的复制粘贴,而是一场涉及性能、格式和稳定性的技术博弈,业内专家指出,数据迁移的成功率往往取决于对底层文件格式和传输协议的精准把控,而非仅仅依赖工具的自动化功能。
Hive表导出CSV文件的实操路径
要将Hive中的数据转化为CSV格式,最直接且高效的方式是使用HiveQL语句配合文件系统操作,这种方法避免了引入额外的ETL工具,适合数据量中等且对实时性要求不高的场景。
配置导出参数与执行命令
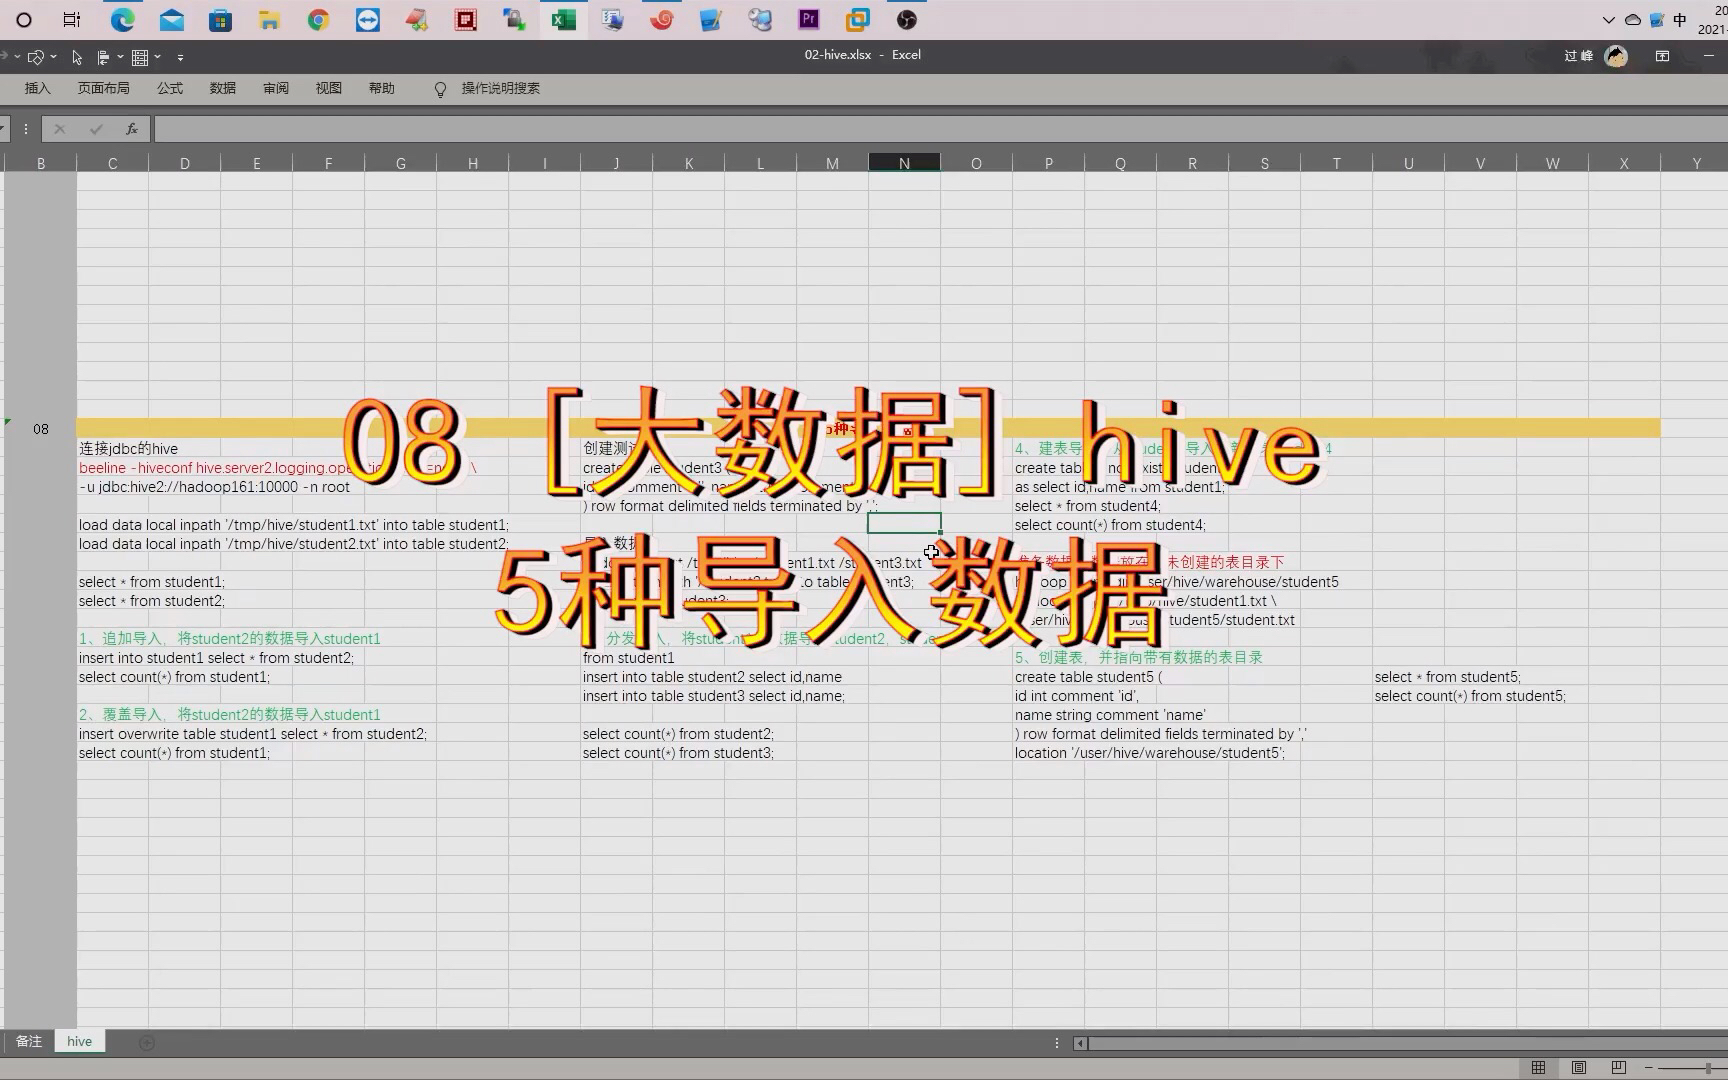
在开始之前,必须明确Hive默认的输出格式,Hive默认使用制表符(Tab)作为分隔符,而CSV标准通常使用逗号,第一步是修改会话级别的配置,确保输出符合CSV规范。
具体操作如下:
- 设置字段分隔符为逗号:
SET hive.cli.print.header=true;以及SET hive.exec.compress.output=false;。 - 执行导出语句:
INSERT OVERWRITE LOCAL DIRECTORY '/tmp/hive_to_csv_data'
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
LINES TERMINATED BY 'n'
SELECT  FROM your_hive_table;
上述命令会将查询结果直接写入本地服务器的
/tmp/hive_to_csv_data目录下,需要注意的是,如果数据量较大,Hive可能会将结果拆分为多个小文件,文件名通常包含类似000000_0的编号。
处理特殊字符与编码问题
数据导出过程中,最容易出现的陷阱是包含逗号、换行符或双引号的字段,如果原始数据中某字段内容为
"北京,上海", 直接导出会导致CSV解析错位,解决方案是在Hive查询阶段使用concat或replace函数清洗数据,或者在导入目标数据库时启用严格的CSV解析模式,务必确认Hive表的编码格式(通常为UTF-8)与目标数据库的字符集一致,否则中文数据会出现乱码,据统计,相当一部分数据迁移失败案例均源于编码不匹配导致的字段截断。
从CSV到关系型数据库的加载策略
拿到CSV文件后,如何将其高效、准确地加载到MySQL或PostgreSQL等数据库中,是决定整个流程成败的关键,这里主要对比两种主流方案:基于JDBC的直接导入和基于专用ETL工具的批量加载。
Sqoop:大数据生态的标准桥梁
对于已经部署了Hadoop集群的企业,Sqoop是首选方案,它不仅能读取HDFS上的CSV文件,还能直接对接Hive元数据,实现端到端的无缝迁移。
使用Sqoop导入CSV数据的典型命令如下:
sqoop import
--connect jdbc:mysql://localhost:3306/target_db
--username root
--password your_password
--table target_table
--fields-terminated-by ','
--lines-terminated-by 'n'
--input-null-string '\N'
--input-null-non-string '\N'
--m 1
在此场景中,--m 1参数强制使用单线程导入,这是因为CSV文件通常包含元数据头或需要保持行顺序,多线程导入可能导致数据交错或主键冲突,对于小型数据集,单线程足以保证数据完整性;若数据量达到TB级别,建议先分片再并行导入。
原生数据库工具:LOAD DATA INFILE
如果目标数据库是MySQL,且CSV文件已位于数据库服务器本地,使用原生命令往往比Sqoop更轻量、更快速。
操作步骤:
- 将CSV文件上传至MySQL服务器。
- 执行SQL语句:
LOAD DATA INFILE '/path/to/your/file.csv'
INTO TABLE target_table
FIELDS TERMINATED BY ','
ENCLOSED BY '"'
LINES TERMINATED BY 'n'
IGNORE 1 ROWS;
IGNORE 1 ROWS用于跳过CSV文件的第一行表头,这种方法的优势在于无需安装额外的Java依赖,且执行效率极高,适合频繁的小批量数据更新,它要求CSV文件必须存在于数据库主机上,限制了分布式架构下的灵活性。
常见痛点与性能优化建议
在实际生产环境中,Hive表导入CSV数据库往往面临性能瓶颈和数据一致性问题,针对这些痛点,业内共识认为,建立监控机制和优化导入策略比盲目追求速度更为重要。
小文件问题与合并策略
Hive导出时产生的大量小文件会显著降低后续导入工具的效率,每个小文件都会触发一次文件打开和关闭操作,消耗大量I/O资源,建议在Hive导出前执行MSCK REPAIR TABLE或手动合并小文件,对于Sqoop用户,可以通过调整--split-by参数合理划分数据块,避免数据倾斜。
数据一致性校验
数据迁移后,必须进行完整性校验,可以通过计算源表和目标表的记录总数、关键字段的哈希值总和来进行比对,若发现差异,应保留日志并启动重试机制,不要假设一次导入就能完美无缺,建立自动化的校验脚本是保障数据质量的必要手段。
不同场景下的方案选型对比
为了帮助读者更清晰地选择适合的技术栈,下表总结了不同数据规模和技术环境下的推荐方案。
| 数据规模 | 技术栈环境 | 推荐方案 | 优势 | 劣势 |
|---|---|---|---|---|
| 小规模 (<100MB) | 单机/轻量级 | 原生LOAD DATA | 速度快,配置简单 | 依赖本地文件,扩展性差 |
| 中等规模 (100MB-10GB) | Hadoop集群 | Sqoop单线程 | 稳定性高,易调试 | 速度受限于单核性能 |
| 大规模 (>10GB) | 大数据平台 | Sqoop多线程+分片 | 并行处理,效率高 | 配置复杂,需处理数据倾斜 |
| 实时/准实时 | 流式架构 | Flume/Kafka Connect | 低延迟,持续同步 | 架构复杂,运维成本高 |
Q&A:Hive表导入CSV数据库常见问题解答
如何避免Hive导出CSV时出现中文乱码?
乱码通常由编码不一致引起,确保Hive表创建时指定了STORED AS TEXTFILE且字符集为UTF-8,在Sqoop导入时,通过--options-file或命令行参数显式指定--driver和字符集映射,若使用原生MySQL导入,需在my.cnf中配置character-set-server=utf8mb4,并在SQL语句中显式声明CHARACTER SET utf8mb4。
Sqoop导入速度慢怎么办?
导入速度慢通常由网络带宽、磁盘I/O或Mapper数量设置不当引起,建议首先检查--m参数,对于小表,过多的Mapper反而增加开销,设为1即可;对于大表,可适当增加Mapper数量,但不宜超过集群核心数,检查源端Hive表是否经过压缩,若为Snappy或Gzip压缩,Sqoop在读取时需解压,消耗CPU资源,可考虑在导出阶段使用未压缩格式,或在目标端使用批量插入而非逐行插入。
CSV文件中包含换行符导致导入失败如何处理?
当CSV字段内容包含换行符时,简单的文本分割会导致行错位,在Hive导出阶段,应使用replace(col, 'n', ' ')函数将换行符替换为空或空格,若无法修改源数据,在Sqoop导入时,确保--lines-terminated-by参数正确设置,并在目标数据库中使用支持CSV解析的加载命令,如MySQL的LOAD DATA INFILE配合ENCLOSED BY '"'选项,它能正确识别被引号包裹的多行内容。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/451748.html