HDFS通过“分块存储+多副本机制+NameNode元数据管理”的核心架构,将海量非结构化数据分散存储在集群的多个DataNode节点上,实现高容错、高吞吐的数据读写。
想象一下,如果你要把一座图书馆的书搬到另一个地方,直接搬整本大书肯定慢且容易损坏,HDFS的处理逻辑就像把书拆成单页,复印多份,分散存放在不同的仓库里,并配有一位超级管理员记录每一页的位置,这种设计让它在面对PB级数据时依然游刃有余。

HDFS存储架构的核心逻辑解析
HDFS(Hadoop Distributed File System)并非简单的网络硬盘,它是一个为大数据场景量身定制的文件系统,其核心在于“分而治之”与“冗余备份”。
Block块划分机制
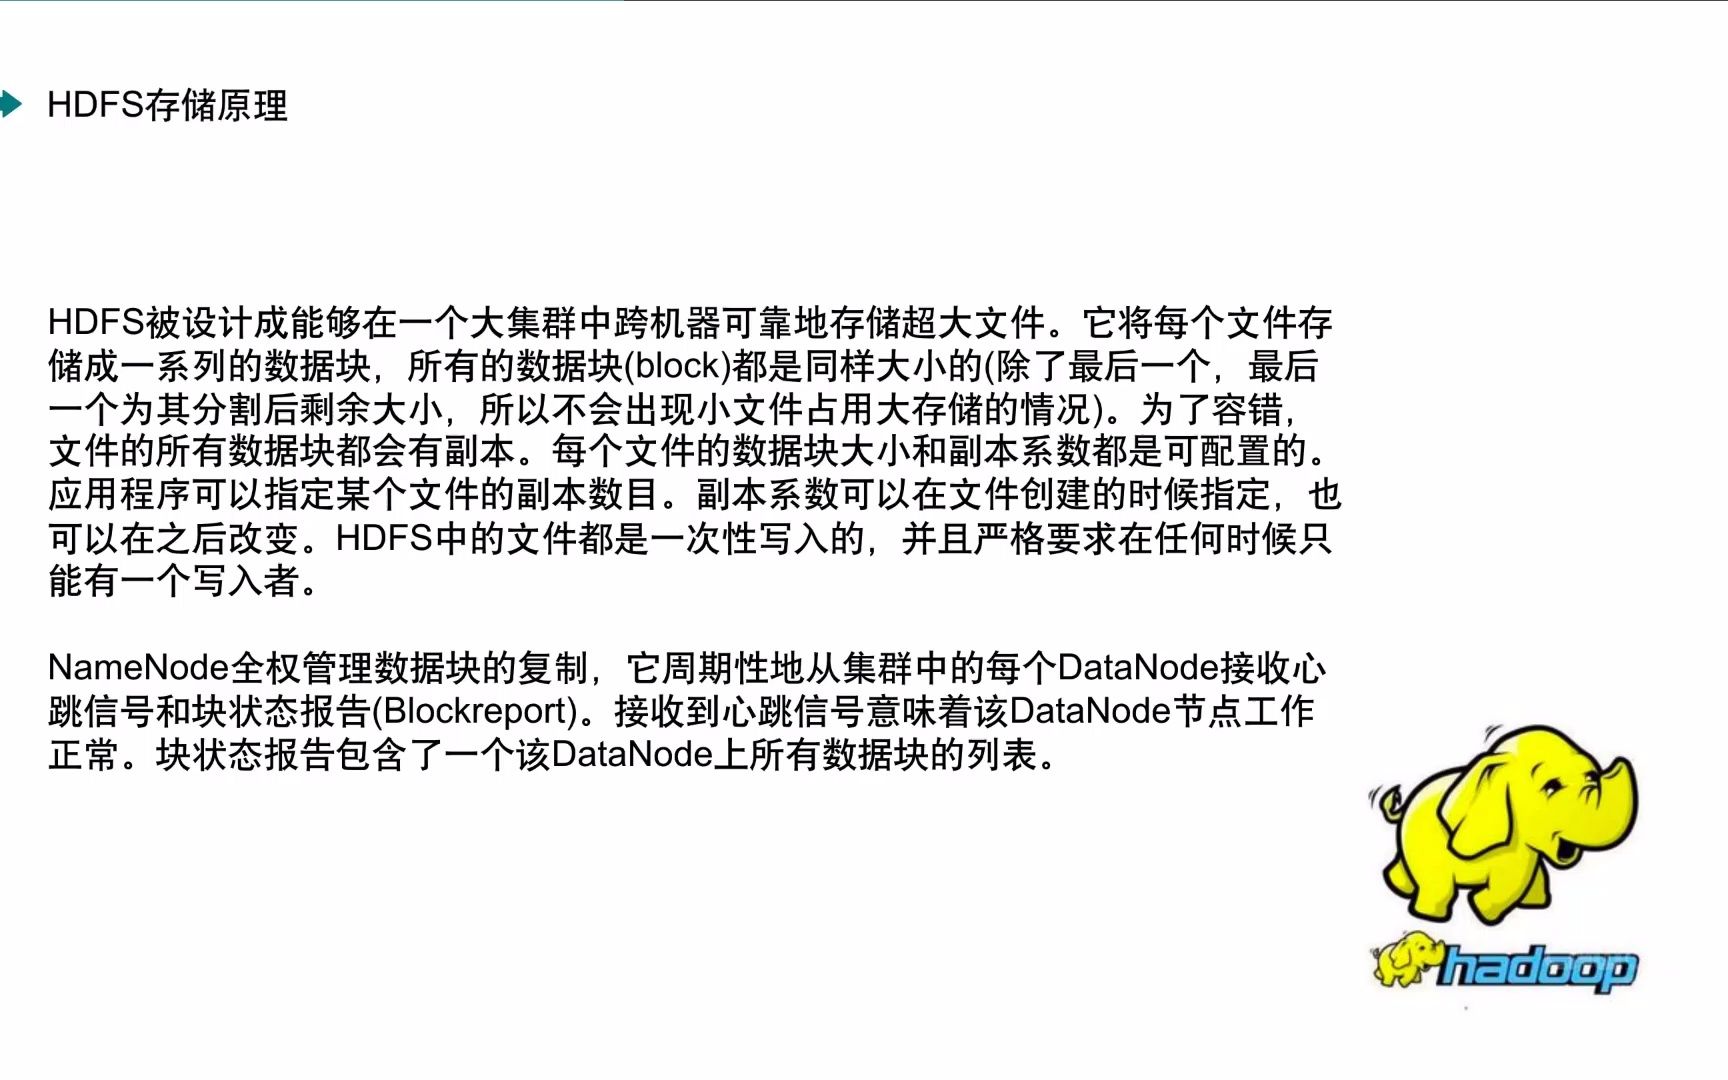
在HDFS中,文件不会以完整形式存储,而是被切割成固定大小的数据块(Block),默认情况下,Hadoop 3.x版本的Block大小已调整为128MB,而在早期版本中通常为64MB或128MB。
- 为什么需要分块? 如果文件只有几KB,却占用一个128MB的块,会造成极大的空间浪费,分块机制使得小文件能共享块资源,大文件能并行处理。
- 块的大小权衡: 块越大,寻道时间占比越低,吞吐率越高;但块过大,数据局部性(Data Locality)效果减弱,且故障恢复时间变长,业内专家指出,128MB是当前平衡计算效率与存储开销的最佳实践值。
NameNode与DataNode的角色分工
HDFS采用主从架构(Master/Slave),这是理解其存储逻辑的关键。
NameNode:大脑
NameNode负责管理文件系统的命名空间(Namespace),它不存储实际数据,只存储元数据(Metadata),包括:
文件目录树结构
每个文件对应的数据块列表
每个数据块存储在哪些DataNode上
文件的权限、修改时间等属性
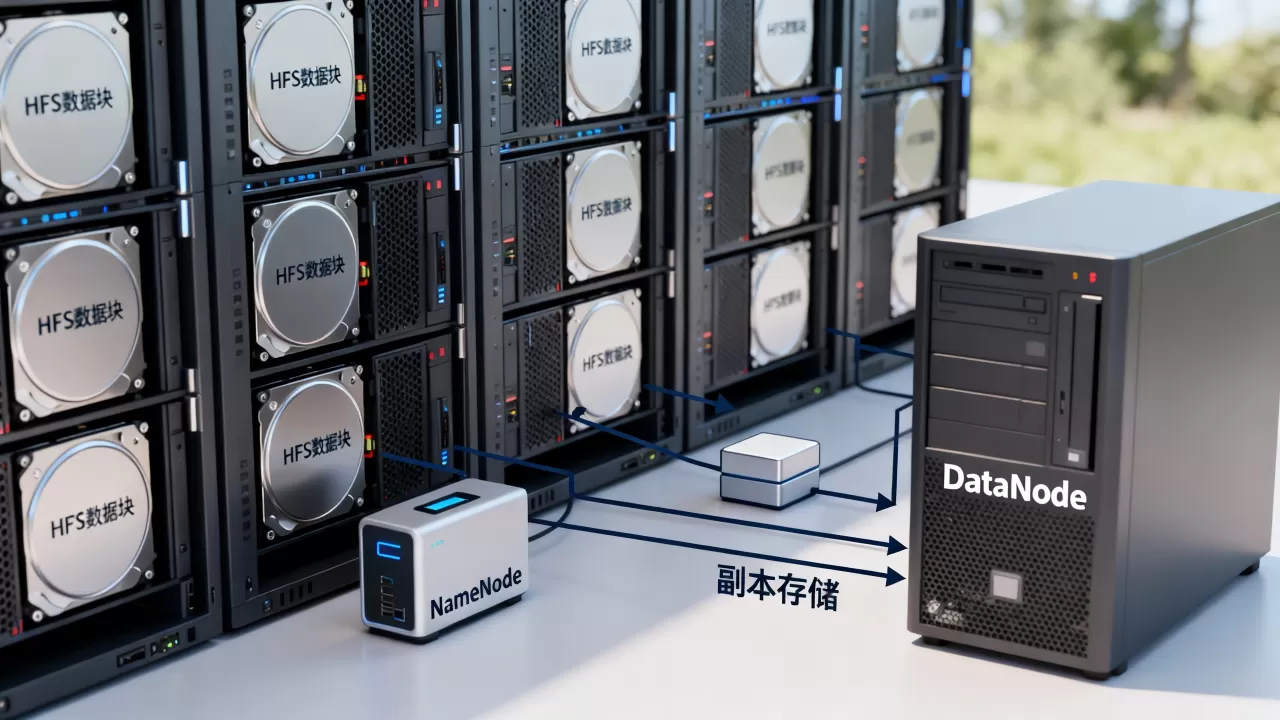
由于元数据必须常驻内存以保证高速查询,NameNode对内存要求极高,一旦NameNode宕机,整个集群将无法访问文件,除非配置了高可用(HA)方案。
DataNode:肌肉
DataNode是实际存储数据的节点,它们定期向NameNode汇报自身状态,包括:
存有哪些数据块
数据块的校验和
节点的健康状况
当客户端需要读取数据时,NameNode会告诉客户端数据块在哪些DataNode上,客户端随后直接与DataNode通信进行数据传输。
多副本策略与数据可靠性保障
数据丢失是分布式系统的大忌,HDFS通过多副本机制来解决硬件故障带来的风险。
副本放置策略
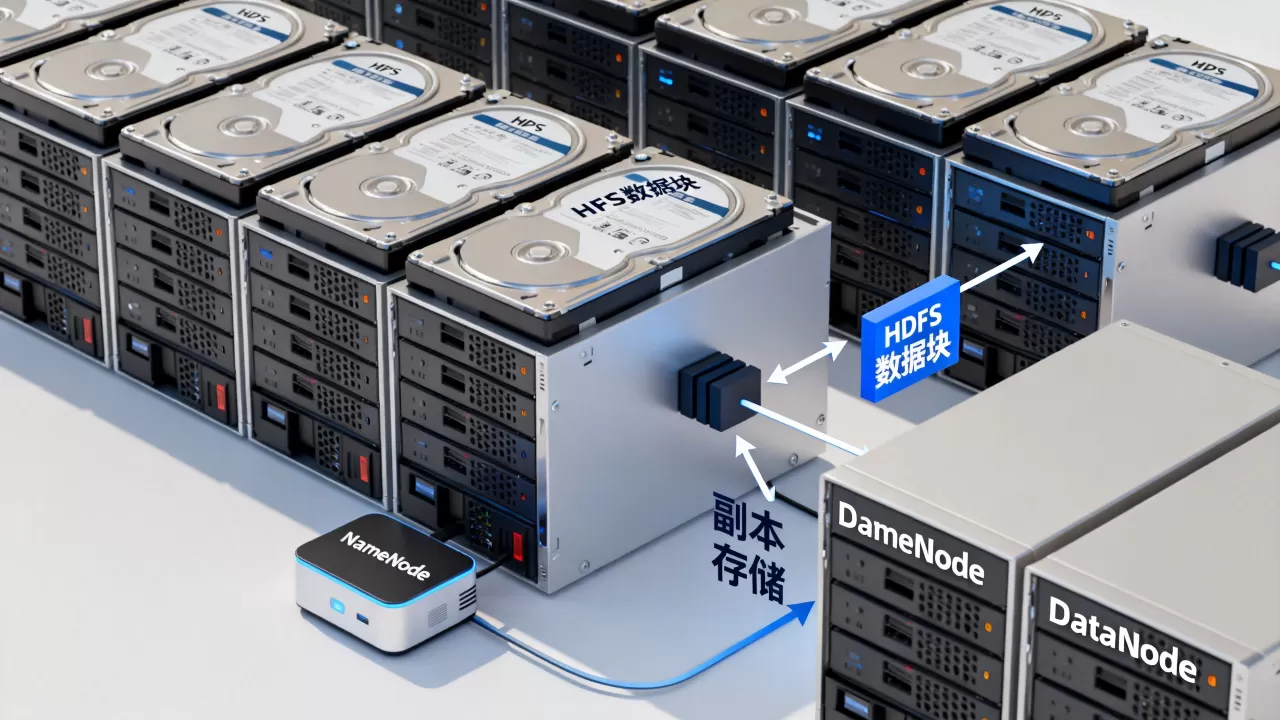
默认情况下,每个数据块保存3个副本,这并非随机放置,而是遵循严格的机架感知(Rack Awareness)策略,以平衡故障隔离与网络带宽。
- 第一个副本: 存放在上传客户端所在的节点(如果客户端在集群内),这能减少网络流量,提高写入效率。
- 第二个副本: 存放在与第一个副本不同机架的随机节点上,这是为了防范单台服务器故障。
- 第三个副本: 存放在与第二个副本同一机架但不同节点的随机节点上,这是为了在机架故障时,仍能通过同一机架内的其他节点恢复数据,利用机架内高带宽优势。
这种策略确保了:即使丢失一个机架(整个机房断电或断网),数据依然可用。
心跳机制与数据修复
DataNode每隔3秒向NameNode发送一次心跳包,如果NameNode超过一定时间(默认10分钟)未收到某个DataNode的心跳,会将其标记为死亡。
NameNode会启动数据恢复流程:
- 检查该节点上缺失副本的块。
- 从其他存活的副本中复制数据,补充到新的DataNode上,直到副本数恢复到设定值(如3个)。
- 这个过程对用户透明,写入操作不会中断。
实际应用场景与性能优化
理解HDFS如何存储,最终是为了更好地使用它,不同的业务场景对存储策略有不同要求。
高吞吐读取场景
对于大数据分析(如Spark、Hive查询),核心需求是快速读取大量数据。
- 数据本地性优化: 计算框架(如YARN)会优先将任务调度到拥有数据副本的DataNode上运行,避免跨网络传输数据,这就是“移动计算比移动数据更划算”的原则。
- 小文件问题: HDFS不适合存储大量小文件(如几KB的文件),因为每个文件、目录、块都需要在NameNode内存中占用一个条目,若小文件过多,NameNode内存会迅速耗尽。
- 解决方案: 使用HAR(Hadoop Archive)归档小文件,或将其合并为SequenceFile等二进制格式。
高并发写入场景
HDFS设计初衷是“一次写入,多次读取”(Write Once, Read Many),它不支持随机修改(Random Write)。
- 追加写入: 虽然不支持修改中间内容,但支持在文件末尾追加数据(Append),适用于日志收集系统。
- 并发限制: 同一时间只有一个客户端能写入文件,如果需要高并发写入,需使用HBase或Kafka等系统,而非直接写HDFS。
常见问题与实操建议
在实际运维中,许多问题源于对HDFS存储机制的理解偏差。
如何检查数据块状态?
使用HDFS命令行工具可以快速诊断存储问题。
# 查看文件详细信息,包括副本数、块大小、所属块
hdfs dfs -ls -R /path/to/file
# 查看特定块的分布情况
hdfs fsck /path/to/file -blocks
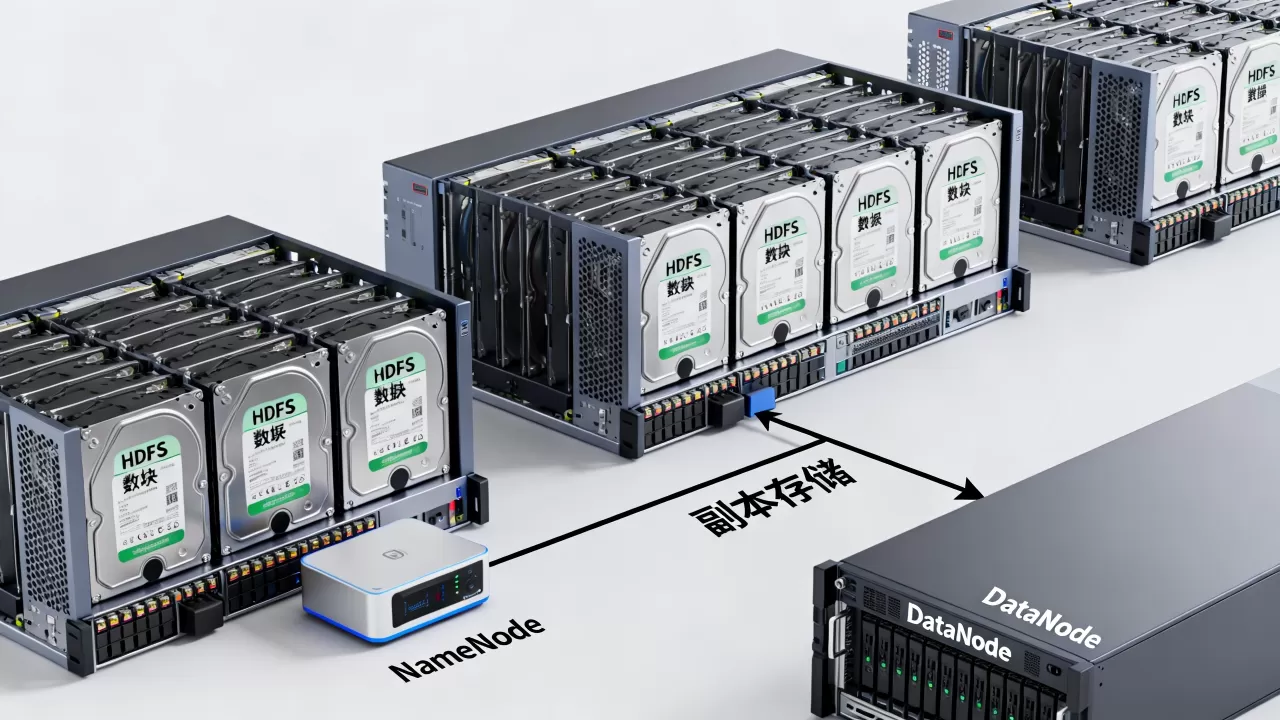
如果发现有块副本数不足(Under-replicated blocks),NameNode会自动修复,若长时间未修复,需检查DataNode节点状态。
扩容与缩容
- 扩容: 新增DataNode节点后,只需启动节点服务,并配置NameNode,HDFS会自动将部分数据块迁移到新节点,以平衡负载。
- 缩容: 使用Decommission工具将节点移出集群,数据会平滑迁移到其他节点,确保服务不中断。
Q&A:HDFS存储相关高频疑问
HDFS如何存储小文件?
HDFS本身不优化小文件存储,因为每个小文件都占用独立的元数据条目,导致NameNode内存压力巨大,业内共识认为,解决小文件问题的最佳实践是在数据入湖前进行合并,可以通过MapReduce作业将多个小文件合并为一个大的SequenceFile或Parquet文件,或者使用Hive的Concatenate操作,对于实时数据流,建议使用Kafka暂存,再批量写入HDFS。
HDFS存储数据是否加密?
默认情况下,HDFS数据在磁盘和网络传输中是明文的,若需加密,可启用HDFS透明加密(Transparent Encryption),该功能允许在文件系统层面自动加密数据块,对应用程序透明,加密密钥由Key Management Server(KMS)管理,确保只有授权用户能解密数据,据工信部相关数据安全指南建议,涉及敏感数据的存储必须启用此功能。
HDFS存储成本与硬件选择
HDFS通常部署在廉价硬件上,依靠软件冗余保证可靠性,存储节点多采用大容量机械硬盘(HDD)以降低成本,而NameNode节点则需使用高性能SSD和大量内存以加速元数据访问,对于冷数据(不常访问的数据),可使用对象存储网关(如Ceph或MinIO)对接HDFS,实现分层存储,进一步降低长期存储成本。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/449217.html