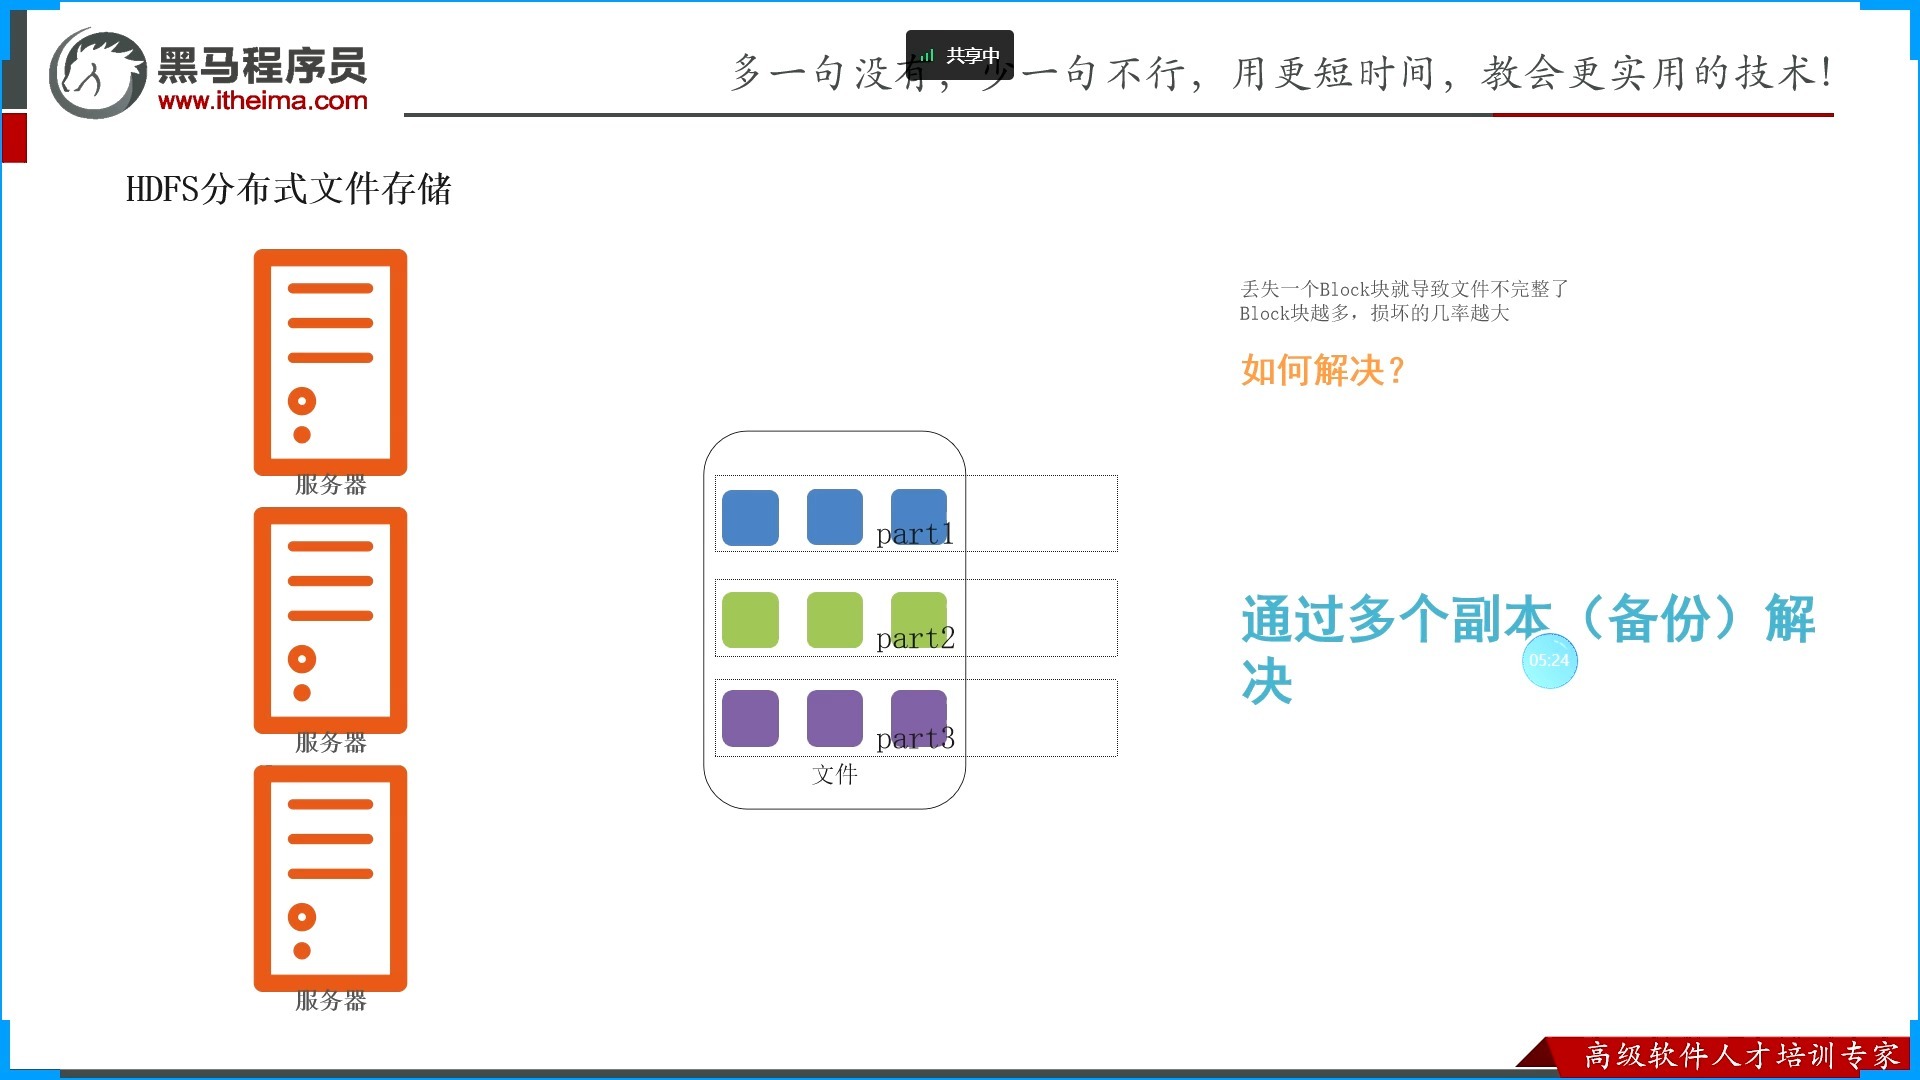
HDFS通过“分块存储”和“多副本机制”将大文件切分为固定大小的数据块,并分散存储在集群的不同节点上,以此实现高容错和高吞吐量的海量数据存储。
想象一下,你手里有一本厚达千页的书,但你的书架只能放几十页的小册子,HDFS(Hadoop Distributed File System)的处理逻辑就是这样:它不会试图把整本书硬塞进一个格子,而是把它撕成若干个小册子(数据块),然后把这些小册子复印多份,分别塞进图书馆里不同楼层、不同书架的格子里,这种设计不仅解决了存储容量的瓶颈,更确保了即使某个书架倒塌(节点故障),你依然能凭借其他副本完好无损地读取整本书。
HDFS存储架构的核心逻辑
HDFS的设计初衷是为了处理PB级别的大数据,其核心在于“分而治之”,要理解它如何存储文件,必须厘清元数据管理与实际数据存储的分离机制。
主从架构的角色分工
HDFS采用典型的主从(Master/Slave)架构,这种结构清晰界定了“管理者”与“执行者”的职责。
- NameNode(主节点):它是整个文件系统的“大脑”或“目录管理员”,NameNode不存储实际的文件数据,只存储文件的元数据(Metadata),这包括文件名、目录结构、文件权限、以及最关键的信息文件被切分成了哪些数据块,以及每个数据块具体存储在哪些DataNode上,你可以把它想象成图书馆的索引卡片柜,它知道每本书在哪里,但它自己并不存放书本。
- DataNode(从节点):它是“仓库管理员”或“实干家”,DataNode负责实际存储数据块,并处理客户端的读写请求,每个DataNode会定期向NameNode汇报自身状态和所属数据块的健康状况,如果某个DataNode宕机,NameNode会立即感知并启动数据恢复流程。
数据块的切分规则
文件在写入HDFS之前,会被强制切分为固定大小的数据块(Block),这是HDFS存储区别于传统文件系统(如Linux ext4)的最大特征。
- 默认块大小:在Hadoop 2.x及3.x版本中,默认的数据块大小为128MB,这一数值并非随意设定,而是基于网络跳数、磁盘寻道时间和故障恢复时间的综合考量,较大的块可以减少寻址开销,提高吞吐量;但块太大又会导致数据倾斜和恢复时间过长。
- 切分逻辑:如果一个文件大小为150MB,它会被切分为两个块:第一个块128MB,第二个块22MB,这22MB虽然不足一个完整块,但HDFS会将其视为一个独立的块进行存储和管理。
- 非文件对齐:数据块的大小与文件系统的块大小无关,它是HDFS特有的概念。
多副本机制与数据放置策略
分布式系统最大的挑战是硬件故障的不可避免性,HDFS通过冗余存储来解决这一问题,其核心策略是“多副本”。
为什么需要副本?
业内专家指出,在大规模集群中,硬盘故障是常态而非例外,单副本存储意味着任何一块硬盘损坏都会导致数据永久丢失,HDFS默认将每个数据块存储3个副本,这种冗余设计带来了两个直接好处:一是高可用性,任何一个副本损坏,其他副本仍可服务;二是高吞吐量,读取请求可以并行从多个副本获取数据。
副本放置的拓扑优化
副本并不是随机散布在集群中的,而是遵循严格的机架感知(Rack Awareness)策略,以平衡数据安全性与网络带宽成本。
- 第一个副本:放置在与客户端相同的节点上(如果客户端在集群内),否则随机选择一个磁盘负载较低的节点。
- 第二个副本:放置在与第一个副本不同机架的节点上,这一步至关重要,因为它确保了即使整个机架断电或网络中断,数据依然可用。
- 第三个副本:放置在与第二个副本相同机架但不同节点的磁盘上,这样既保证了副本的分散性,又利用了机架内高速交换机的带宽优势,降低了跨机架传输的网络开销。
这种“2+1”的放置策略是HDFS的行业共识,它在容错能力和网络性能之间取得了最佳平衡。
文件写入与读取流程详解
理解HDFS如何存储文件,最终要落实到具体的I/O操作中,客户端与NameNode和DataNode的交互过程,揭示了数据落盘的完整路径。
写入流程:流水线复制
当客户端向HDFS写入一个文件时,过程如下:
- 请求连接:客户端向NameNode发起写入请求,NameNode检查文件是否存在、权限是否足够,并确认是否有足够的空闲空间。
- 获取管道:NameNode返回一个DataNode列表,构成一条“写入管道”(Pipeline),对于3副本策略,管道可能包含DataNode A(机架1)、DataNode B(机架2)和DataNode C(机架1)。
- 数据流传输:客户端将数据流分成数据包(Packet,默认64KB),依次发送给DataNode A。
- 流水线转发:DataNode A收到数据包后,不仅将其写入本地磁盘,还立即转发给DataNode B;DataNode B收到后,写入本地磁盘并转发给DataNode C。
- 确认机制:DataNode C写入完成后,向B发送确认;B收到确认后,向A发送确认;A最终向客户端发送确认,只有当所有副本都确认写入成功,客户端才认为写入完成。
这种流水线机制极大地提高了写入效率,避免了客户端与每个DataNode单独建立连接的开销。
读取流程:就近原则
读取过程相对简单,但同样体现了智能调度:
- 获取位置:客户端向NameNode请求读取文件,NameNode返回文件各数据块所在的DataNode列表,并按网络距离排序。
- 就近读取:客户端优先选择距离自己最近的DataNode(通常是同一机架或同一节点)读取数据块。
- 流式读取:数据以流的形式从DataNode传输到客户端,直到整个文件读取完毕。
常见问题与场景应对
在实际生产环境中,理解HDFS的存储机制有助于解决常见的性能和安全问题。
小文件问题
HDFS擅长存储大文件,但对海量小文件(如KB级别)支持较差,因为每个文件、目录和数据块都需要在NameNode中占用约150字节的内存空间,如果集群中有数百万个小文件,NameNode的内存压力将急剧增加,甚至导致集群崩溃。
- 解决方案:使用HAR(Hadoop Archive)将小文件打包成归档文件,或使用SequenceFile等二进制格式合并小文件。
数据均衡与修复
随着节点的增加或减少,数据分布可能变得不均匀,HDFS提供了Balancer工具来重新分配数据块,确保各节点的存储利用率差异在可接受范围内(默认10%)。
当某个副本因节点故障而缺失时,NameNode会检测到副本数低于阈值,并自动触发复制任务,从其他健康副本中复制数据块到新节点,以恢复默认的3副本状态。
Q&A:HDFS存储核心疑问解答
HDFS如何存储文件与本地文件系统有何区别?
HDFS将大文件切分为固定大小的数据块(默认128MB),并在集群中分散存储多个副本,强调高吞吐量和容错性;而本地文件系统(如ext4)通常按文件连续存储,强调低延迟和随机读写性能,且通常不提供跨机器的冗余。
HDFS存储小文件会有什么后果?
HDFS存储小文件会严重消耗NameNode的内存资源,因为每个元数据对象(文件、目录、块)都占用固定内存,这会导致NameNode启动缓慢、响应延迟增加,甚至因内存溢出(OOM)而宕机,进而导致整个集群不可用。
如何验证HDFS中的文件副本是否健康?
可以通过命令行工具hdfs fsck /path/to/file来检查文件的健康状况,该命令会列出文件的所有数据块及其副本状态,标记出缺失、损坏或过多的副本,并给出修复建议。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/449057.html