规则引擎数据库设计的核心在于将“业务逻辑”与“代码执行”彻底解耦,通过标准化的元数据模型实现配置即代码,从而让非技术人员也能通过界面调整业务规则,无需重启服务或修改代码。
在数字化转型的深水区,硬编码的规则往往成为系统演进的绊脚石,当业务方频繁调整促销策略、风控阈值或审批流程时,每次改动都涉及开发、测试、上线的漫长周期,业内专家指出,构建一套高可用的规则引擎数据库架构,是解决这一痛点的关键,这不仅仅是几张表的简单堆砌,而是对业务领域模型的抽象与重构,我们需要设计出一套既能容纳复杂逻辑,又能保证查询性能,同时具备极高扩展性的数据模型。

规则引擎核心数据模型拆解
要理解规则引擎的数据结构,首先要打破“规则就是一段代码”的传统认知,在数据库中,规则被拆解为原子化的组件,这种拆解方式类似于乐高积木,通过不同的组合实现无限的业务场景。
基础元数据管理模块
所有规则运行的基石是元数据,这部分数据定义了“谁”在什么“条件”下执行什么“动作”。
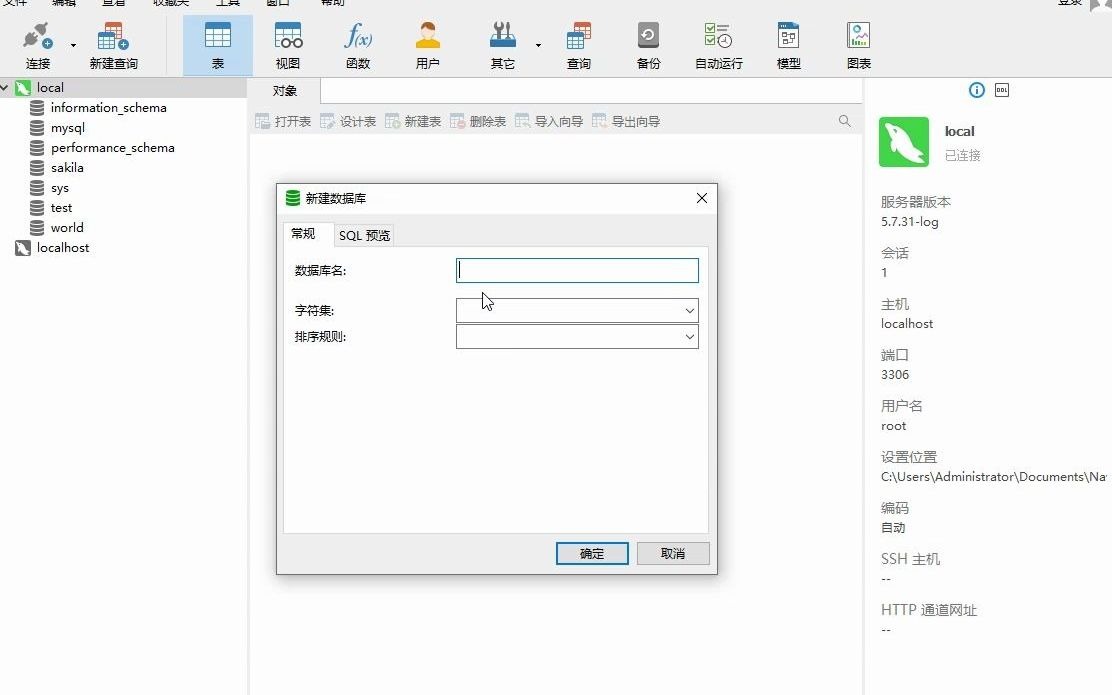
业务对象与属性映射表
业务对象(Business Object)是规则操作的主体,订单”、“用户”、“商品”,我们需要一张表来存储这些对象的定义。
object_id:唯一标识,关联具体的业务实体。
field_name:字段名,如“订单金额”、“用户等级”。
data_type:数据类型,支持字符串、数字、日期等。
operator_mapping:操作符映射,定义前端界面可选的比较符(如>=, <, IN)。
规则集与规则定义表
规则集(Rule Set)是规则的容器,通常对应一个业务场景,如“双十一促销规则集”,规则定义表则存储具体的逻辑单元。
rule_id:规则唯一标识。
rule_name:规则名称,需具备可读性。
priority:优先级,决定多条规则冲突时的执行顺序。
status:状态,启用、禁用或草稿。
逻辑表达式存储结构
这是设计中最具挑战性的部分,如何将人类可读的逻辑转化为计算机可执行的JSON或XML结构,并高效存储?
条件组与条件项表
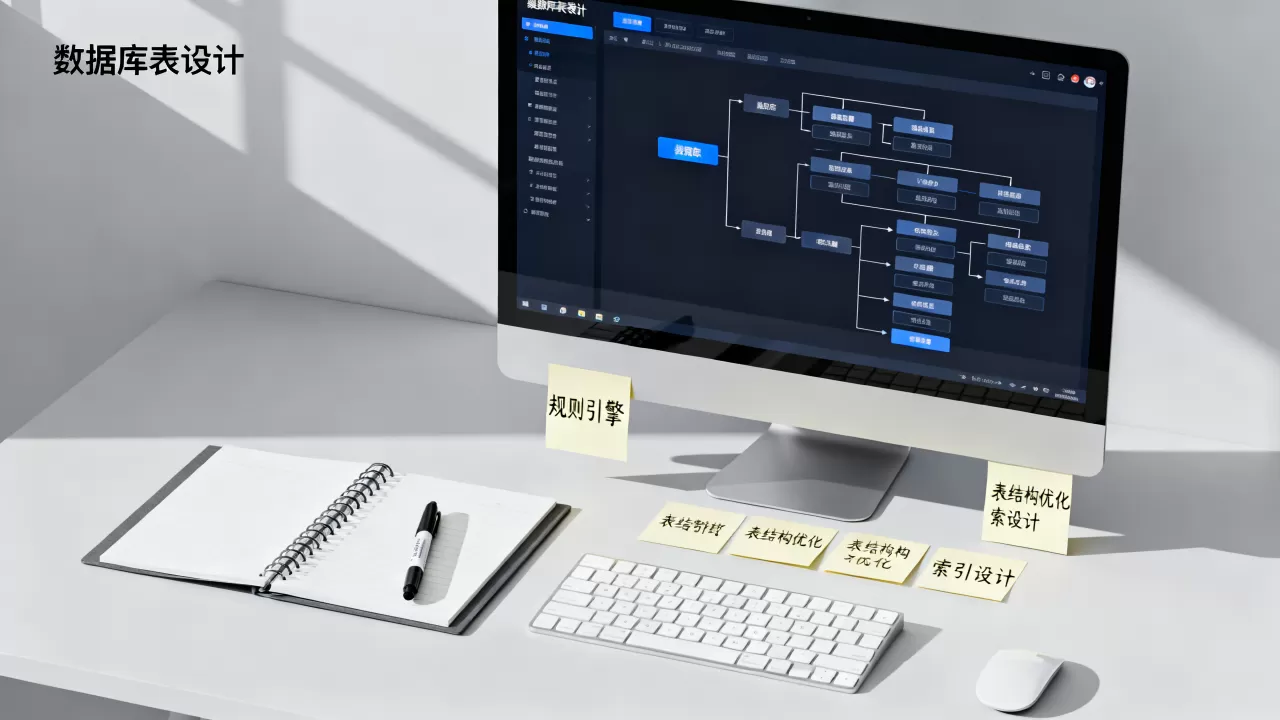
采用树状结构存储逻辑表达式。
condition_group_id:条件组ID,用于分组AND/OR逻辑。
parent_id:父节点ID,构建层级关系。
operator:逻辑运算符,AND或OR。
leaf_condition:叶子节点,存储具体的比较逻辑,如`{ “field”: “amount”, “op”: “>”, “value”: 1000 }`。
这种设计允许无限嵌套,轻松应对“用户是VIP且金额大于1000)或(用户是新客且金额大于500)”这类复杂场景。
规则引擎数据库设计实战对比
在实际项目中,不同的存储策略会导致截然不同的维护成本,许多团队在初期为了省事,直接将JSON字符串存入一个大字段,这看似简单,实则埋下了巨大的隐患。
扁平化存储 vs 规范化存储
| 特性 | 扁平化JSON存储 | 规范化关系型存储 |
|---|---|---|
| 查询性能 | 差,无法利用索引进行精确过滤 | 优,支持SQL索引和关联查询 |
| 数据一致性 | 弱,需应用层校验 | 强,依赖数据库约束 |
| 版本管理 | 困难,难以追踪具体字段变更 | 容易,通过关联表追踪历史 |
| 运维复杂度 | 低,结构简单 | 中,需维护多张关联表 |
业内共识认为,对于高频变更且逻辑复杂的规则引擎,规范化存储是更优选择,虽然查询时需要JOIN操作,但通过合理的索引设计和读写分离策略,性能损耗完全在可控范围内,更重要的是,规范化存储使得“规则版本回溯”成为可能,当线上出现规则错误时,可以快速定位到具体哪一版配置出了问题。
规则版本控制机制
规则不是静态的,它需要版本管理,建议在规则定义表中增加version字段,并建立独立的rule_version_history表。
- 操作路径:每次发布新规则时,不直接更新原记录,而是复制一份新记录,
version加1,原记录状态改为“已归档”。 - 生效策略:引擎执行时,根据
rule_id和max(version)获取最新可用规则。 - 回滚支持:若新版本出错,只需将旧版本的
status改为“启用”,即可实现秒级回滚。
规则引擎数据库性能优化策略
随着规则数量达到数万甚至百万级,数据库性能瓶颈逐渐显现,如何保证在高并发场景下,规则加载和匹配的速度依然稳定?
索引设计与查询优化
针对规则查询场景,索引策略至关重要。
- 复合索引:在规则表中,针对
(business_type, status, priority)建立复合索引,加速特定业务场景下启用规则的筛选。 - 覆盖索引:对于仅查询规则ID和优先级的场景,使用覆盖索引避免回表,提升查询速度。
- 缓存策略:规则数据具有“读多写少”的特性,建议将热点规则集加载至Redis缓存中,数据库仅作为持久化存储,缓存失效策略可采用“写扩散”,即规则更新时主动删除相关缓存Key。
动态规则加载与预热
为了避免服务启动时的数据库压力,可采用异步预热机制。
- 启动阶段:应用启动时,从数据库加载所有“启用”状态的规则集ID。
- 异步加载:后台线程根据ID批量加载规则详情,并组装成内存中的执行树。
- 动态刷新:监听数据库变更事件(如使用Canal监听MySQL binlog),实时触发缓存更新,确保规则变更在秒级内生效。
规则引擎数据库设计常见问题解答
规则引擎数据库设计如何支持多租户隔离?
多租户场景下,数据隔离是首要问题,推荐采用“共享库、共享表、tenant_id隔离”的模式,在规则表、条件表、动作表中均增加`tenant_id`字段,并在所有查询语句中强制附加`WHERE tenant_id = ?`条件,对于数据量极大且对隔离性要求极高的SaaS平台,可采用“共享库、独立Schema”或“独立数据库”方案,但会增加运维成本,多数情况下,应用层强制过滤`tenant_id`是性价比最高的选择。
规则引擎数据库设计如何处理规则冲突?
规则冲突通常表现为多条规则同时满足条件,但执行动作不一致,解决冲突的核心在于“优先级”和“冲突解决策略”,在数据库设计中,必须明确`priority`字段的数值含义,通常数值越大优先级越高,当优先级相同时,可引入`conflict_resolution_strategy`字段,定义“取第一个”、“取最后一个”或“聚合结果”等策略,引擎在执行时,先按优先级排序,再按冲突策略合并结果。
规则引擎数据库设计如何监控规则执行效果?
规则执行后的效果追踪是优化规则的重要依据,建议建立独立的`rule_execution_log`表,记录每次规则匹配的详细过程。
记录内容:触发时间、规则ID、输入参数快照、匹配结果、执行耗时。
存储优化:由于日志数据量大,建议将原始日志存入Elasticsearch或HBase,数据库仅保留聚合统计指标。
分析应用:通过查询日志,可分析哪些规则被触发最多,哪些规则从未被触发(僵尸规则),从而进行规则清理和优化。
规则引擎数据库设计并非一劳永逸的工程,而是一个随着业务演进不断迭代的过程,从最初的简单JSON存储,到后来的规范化关系模型,再到如今结合缓存与异步更新的混合架构,每一步都旨在平衡灵活性、性能与维护成本,核心始终不变:让数据服务于业务,让逻辑脱离代码束缚,只有设计出清晰、健壮且易于扩展的数据模型,规则引擎才能真正成为业务创新的加速器,而非技术债务的源头。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/448089.html