谷歌公开的大数据分析平台并非单一软件,而是以Google Cloud BigQuery、Looker Studio和Dataproc为核心的云端数据基础设施组合,它们通过无缝集成与Serverless架构,帮助企业实现从海量数据清洗到可视化决策的全链路自动化处理。
在数字化转型的深水区,企业不再满足于简单的数据存储,而是渴望即时洞察,过去,搭建一个能处理PB级数据的分析环境需要数月时间和高昂的硬件投入;依托谷歌的云端生态,这一过程被压缩至数小时,这种转变不仅降低了技术门槛,更重新定义了数据价值的获取方式。

核心组件解析:构建数据智能的三大支柱
要理解谷歌公开的大数据分析平台,必须拆解其底层逻辑,它不是孤立存在的工具,而是一个相互协作的生态系统。
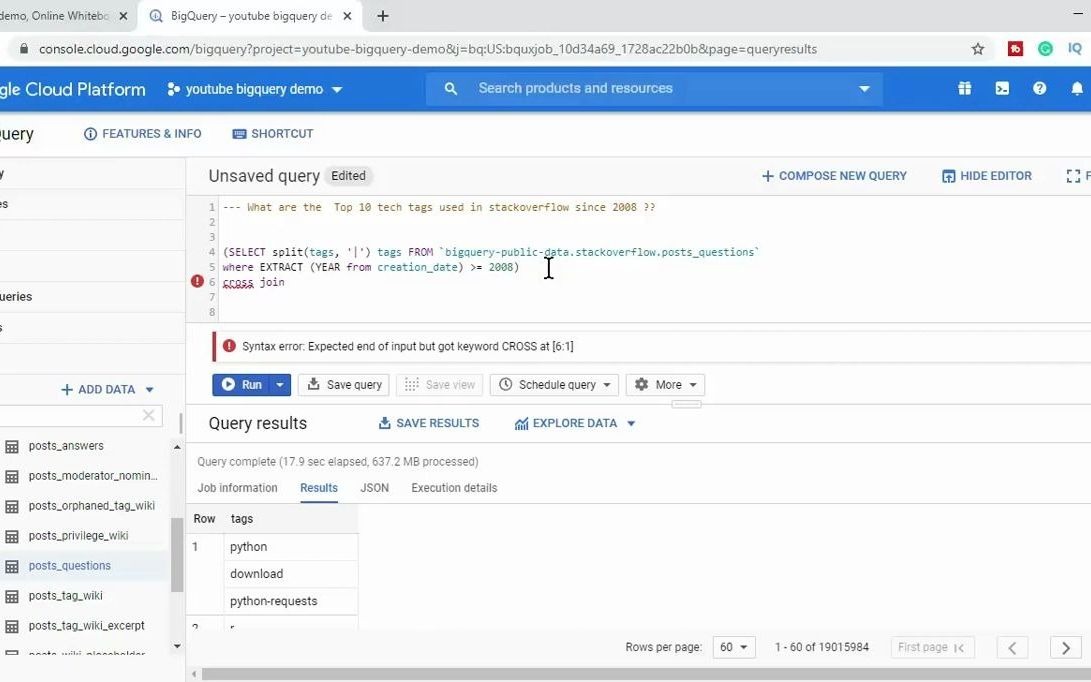
BigQuery:无服务器企业数据仓库
BigQuery是这一生态的心脏,它最大的特点是“无服务器”(Serverless),这意味着用户无需管理底层服务器、补丁或配置。
- 极速查询能力:业内专家指出,BigQuery利用Dremel技术,能在秒级时间内扫描数万亿行数据,对于需要实时决策的场景,如电商大促期间的库存监控,这种速度至关重要。
- 弹性伸缩:系统自动根据查询负载调整资源,当流量激增时,计算资源自动扩展;空闲时则自动缩减,用户只需为实际使用的存储和查询量付费。
- 内置机器学习:通过BigQuery ML,数据分析师可以直接使用SQL语句创建和运行机器学习模型,无需离开数据仓库环境,也无需掌握Python或TensorFlow等复杂编程语言。
Looker Studio:可视化与报告自动化
如果说BigQuery是引擎,Looker Studio(原Data Studio)就是仪表盘,它将枯燥的数据转化为直观的图表。
- 多源数据连接:支持连接Google Analytics、Ads、Sheets以及第三方数据库。
- 实时协作:团队可以在同一份报告中实时编辑和评论,打破了数据孤岛。
- 模板化报告:提供大量预设模板,用户只需替换数据源即可生成专业级报表,极大降低了报表制作的时间成本。
Dataproc与Dataflow:数据处理流水线
在数据进入仓库之前,需要清洗和转换,Dataproc基于Apache Spark和Hadoop,提供托管的大数据集群服务;Dataflow则用于实时和批处理数据的统一管道,这两者确保了进入BigQuery的数据是干净、结构化且高质量的。
选型对比:谷歌平台与其他方案的差异
企业在选择数据分析平台时,往往面临多种选择,了解谷歌平台的独特优势,有助于做出更精准的决策。
与自建Hadoop集群的成本对比
自建Hadoop集群曾是大数据的主流方案,但在2026年的今天,其性价比已大幅降低。
| 维度 | 自建Hadoop集群 | 谷歌BigQuery + Dataproc |
|---|---|---|
| 初始投入 | 极高(硬件采购、机房建设) | 零(按需付费) |
| 运维人力 | 需要专职DBA和运维团队 | 极少,平台自动维护 |
| 扩展灵活性 | 低,扩容需采购硬件并停机 | 高,秒级弹性伸缩 |
| 适用场景 | 数据合规要求极高且预算充足的大型国企 | 绝大多数互联网及传统企业 |
据工信部数据,近年来采用云端数据仓库的企业中,超过半数认为运维成本的下降是其选择云服务的核心原因,自建集群的隐性成本,如电力、冷却、硬件折旧和人员薪资,往往被低估。
与Snowflake等竞品的技术差异
Snowflake是另一款流行的云数据仓库,虽然两者在核心功能上相似,但谷歌平台的优势在于其生态集成度。
- AI集成深度:谷歌将Vertex AI等机器学习平台与BigQuery深度绑定,使得数据科学家的模型部署路径更短。
- 全球基础设施:谷歌拥有遍布全球的边缘节点,对于跨国企业而言,数据延迟更低,合规性更容易满足GDPR等国际标准。
- 查询语言兼容性:BigQuery完全兼容标准SQL,对于熟悉SQL的数据分析师而言,学习曲线几乎为零。
实操指南:如何快速启动数据分析项目
对于技术团队而言,理解架构只是第一步,落地执行才是关键,以下是一套经过验证的实操路径,帮助团队在两周内搭建起基础数据分析能力。
第一步:数据接入与清洗
- 确定数据源:列出所有需要分析的数据源,如MySQL数据库、日志文件或API接口。
- 配置Dataflow管道:使用Apache Beam SDK编写简单的ETL(抽取、转换、加载)代码,将JSON格式的日志解析为结构化的CSV格式。
- 加载至BigQuery:通过Dataflow将清洗后的数据批量加载到BigQuery表中,建议按日期分区,以提高查询效率并降低存储成本。
第二步:建立数据模型
- 创建视图:在BigQuery中创建SQL视图,将多张原始表关联起来,形成业务视角下的“宽表”。
- 定义指标:明确关键绩效指标(KPI),如日活跃用户数(DAU)、转化率、客单价等,并在视图中预计算这些指标。
- 权限管理:使用IAM(身份和访问管理)设置细粒度的权限,确保只有授权人员才能访问敏感数据。
第三步:可视化与分发
- 连接Looker Studio:在Looker Studio中创建新项目,选择BigQuery作为数据源。
- 拖拽式图表构建:选择相应的指标和维度,生成柱状图、折线图或地理分布图。
- 设置自动刷新:配置报表每15分钟或每小时自动刷新,确保管理层看到的是最新数据。
- 分享与嵌入:生成只读链接,嵌入到公司内部门户或定期通过邮件发送给决策者。
常见误区与避坑指南
尽管平台强大,但许多企业在实施过程中仍会遭遇挫折,以下建议基于行业共识认为的常见痛点总结而成。
避免“全量导入”陷阱
不要试图将所有历史数据一次性导入BigQuery,这不仅成本高昂,而且查询性能会因数据量过大而下降,建议采用增量加载策略,仅保留最近3-5年的热数据在BigQuery中,冷数据归档至Cloud Storage。
忽视查询优化
即使使用Serverless架构,低效的SQL查询仍会导致费用激增,务必遵循以下最佳实践:
- 使用分区表和聚类表:在查询时利用
WHERE子句过滤分区键,可大幅减少扫描的数据量。 - 避免SELECT :只选择需要的列,减少数据传输和处理开销。
- 定期审查账单:利用BigQuery的配额和预算警报功能,防止意外的高额账单。
数据治理缺失
数据质量是分析准确性的基石,建议在数据进入仓库前,通过Dataform或dbt等工具建立数据测试规则,自动检测缺失值、异常值和重复记录。
Q&A:关于谷歌大数据平台的常见疑问
谷歌公开的大数据分析平台适合中小企业吗?
非常适合,BigQuery采用按查询数据量和存储量计费的模式,中小企业无需承担高昂的固定硬件成本,对于数据量较小的企业,每月费用可能仅需几十美元,Looker Studio提供免费版本,足以满足基本的可视化需求,随着业务增长,平台可无缝扩展,无需迁移数据或重构架构。
数据安全性如何保障?
谷歌在数据安全方面投入巨大,所有传输中的数据均通过TLS加密,静态数据默认使用AES-256加密,企业还可使用Customer-Managed Encryption Keys(CMEK)自行管理密钥,确保即使谷歌员工也无法访问明文数据,平台符合SOC 1/2/3、ISO 27001、GDPR等多项国际安全合规标准,为跨国业务提供法律保障。
迁移现有数据到谷歌平台难度大吗?
难度中等,取决于源数据系统的复杂度,谷歌提供了官方迁移工具Migrate for Compute Engine和Database Migration Service,支持从Oracle、MySQL、PostgreSQL等主流数据库平滑迁移,对于非结构化数据,可使用Cloud Storage Transfer Service,多数情况下,经过充分测试的迁移过程可在数天内完成,且能保证数据一致性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/446707.html