Google MapReduce 是一种用于大规模数据集并行处理的编程模型,其核心在于将复杂任务自动分解为“Map”和“Reduce”两个阶段,从而在集群中高效完成计算。
在2026年的今天,尽管云原生架构和Serverless计算已成为主流,但理解MapReduce的设计哲学依然是掌握分布式系统基石的关键,它不仅仅是一个过时的技术名词,更是现代大数据生态(如Hadoop、Spark底层逻辑)的源头活水,对于正在寻找大数据处理框架对比的技术人员来说,厘清其工作原理能帮你更好地选择适合当前业务场景的计算引擎。
MapReduce的核心运作机制
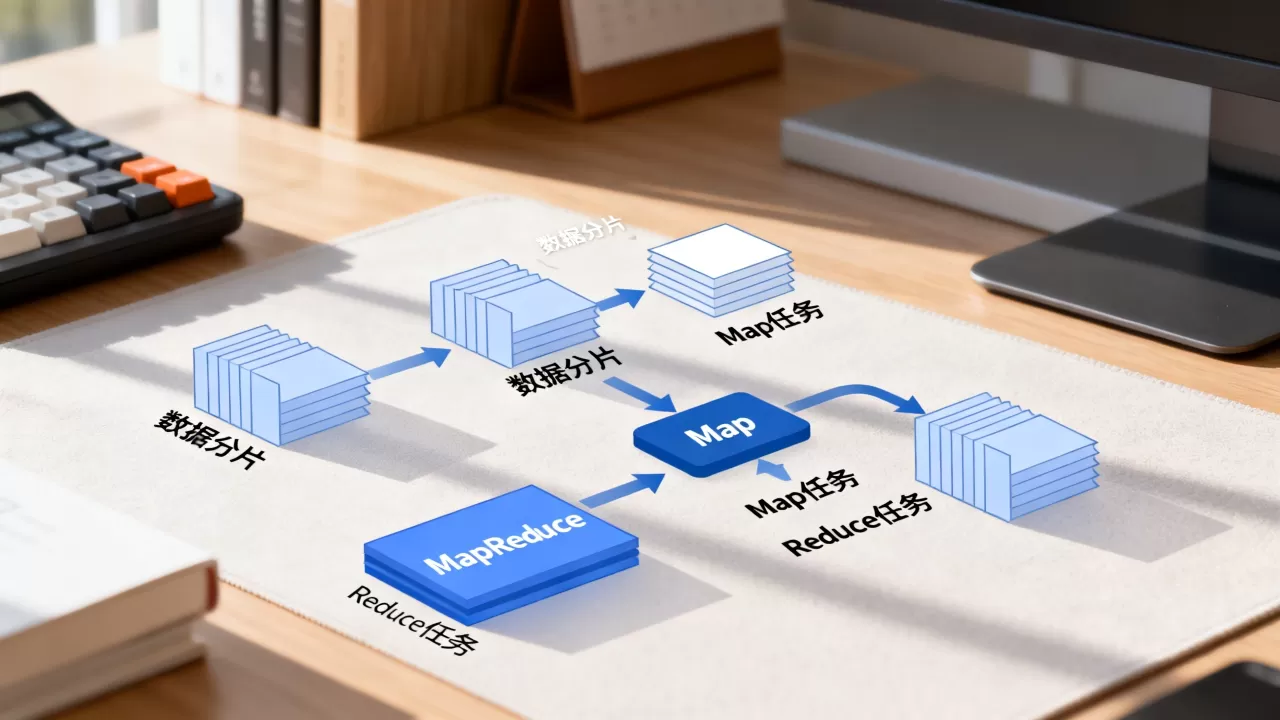
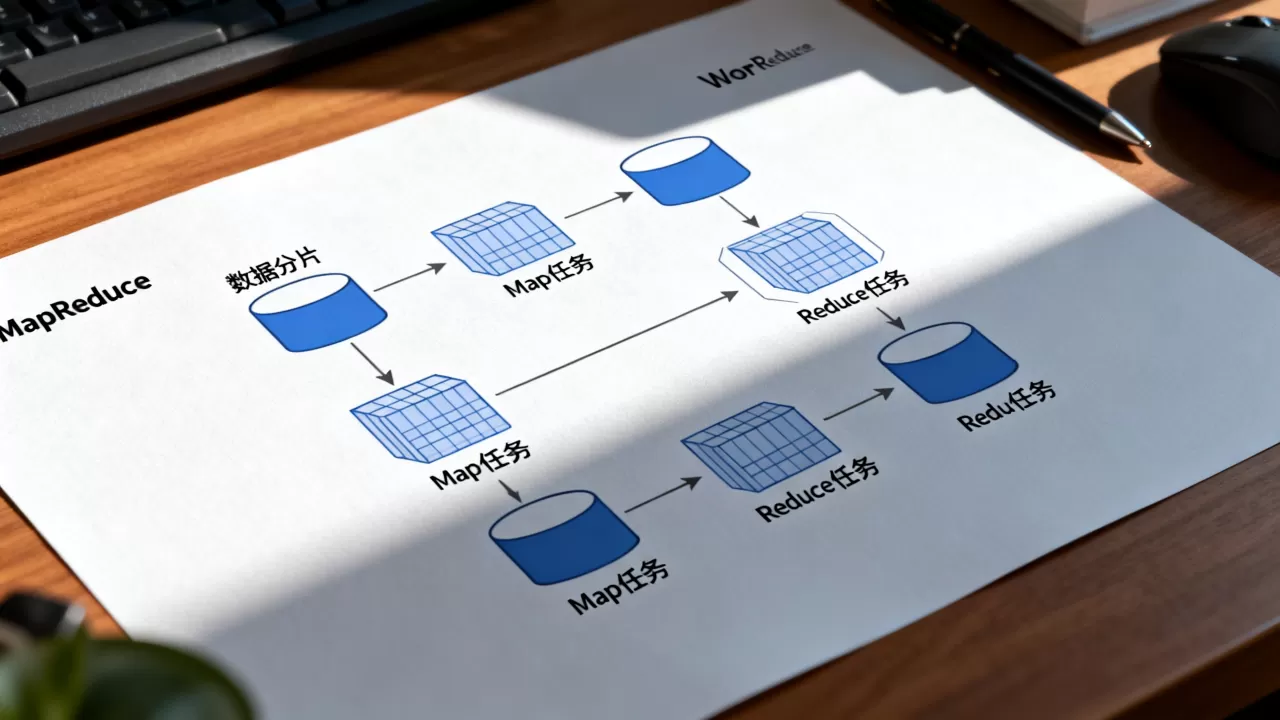
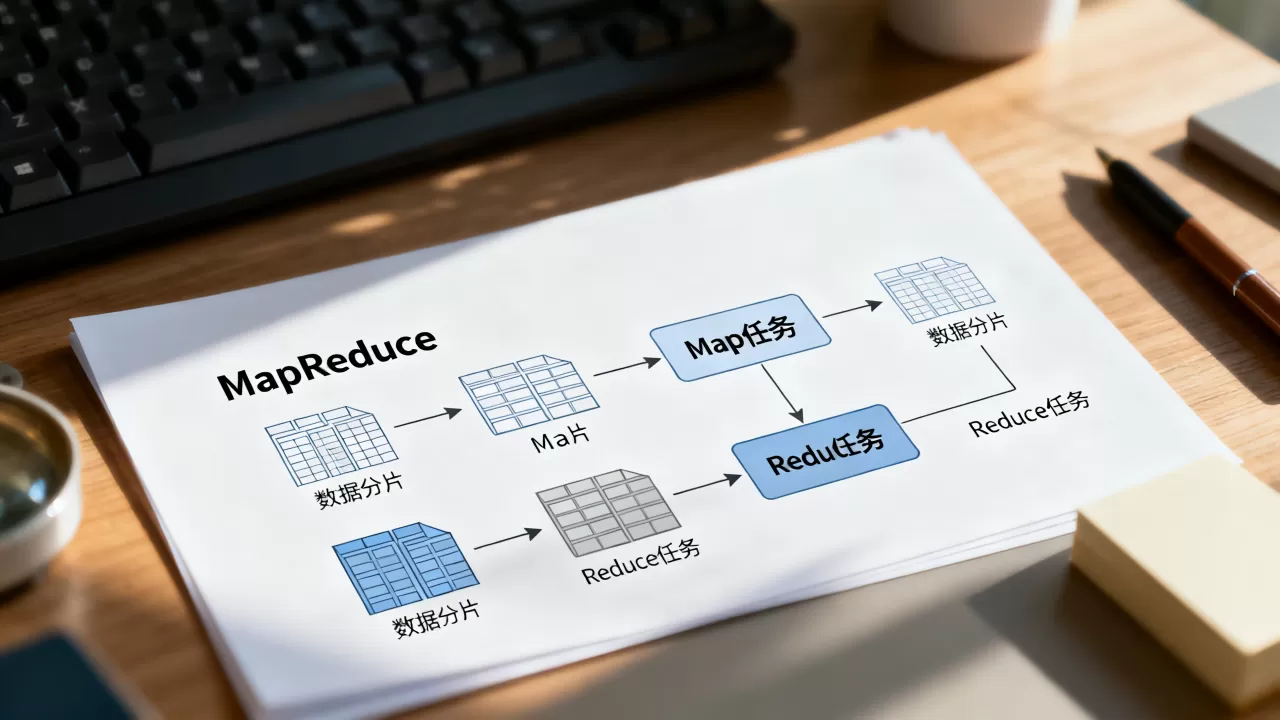
MapReduce并非单一的软件,而是一种编程模型,它的设计初衷是为了解决单机无法处理的PB级数据,整个流程可以想象成一个高度自动化的工厂流水线,数据是原材料,Map是分拣员,Reduce是组装工。
Map阶段:数据拆分与预处理
Map阶段负责处理输入数据,系统会将大文件切割成多个“Split”,每个Split由一个Map任务处理。
- 输入格式:通常是键值对(Key-Value Pair),在日志分析中,Key可能是行号,Value是整行文本。
- 映射逻辑:开发者编写
map()函数,对每个输入键值对进行处理,输出一组中间键值对。 - 局部聚合:在某些优化版本中,Map端会进行Combiner操作,先在本地减少数据量,降低网络传输压力。
Shuffle阶段:数据混洗与排序
这是MapReduce最复杂也最关键的部分,也是性能瓶颈所在,Shuffle负责将Map输出的中间结果,按照Key重新分发到不同的Reduce节点。
- 分区:根据Key的哈希值或范围,决定哪个Reduce处理哪些Key。
- 排序:相同Key的数据会被聚集在一起,确保Reduce接收到的输入是有序的。
- 合并:在内存和磁盘之间进行溢写(Spill)和归并排序,确保数据有序到达Reduce端。
Reduce阶段:汇总与输出
Reduce阶段接收Shuffle过来的数据,对相同Key的值列表进行聚合计算。
- 迭代处理:
reduce()函数遍历所有相同Key的值,执行求和、计数、平均等逻辑。 - 最终输出:将处理结果写入分布式文件系统(如HDFS),完成整个作业。
为什么企业仍关注MapReduce架构?
虽然Spark等内存计算框架在速度上更具优势,但MapReduce在特定场景下仍有不可替代的价值,业内专家指出,在处理离线批处理任务时,MapReduce的容错机制和稳定性依然受到推崇。
高容错性与稳定性
MapReduce的设计哲学是“假设硬件随时会故障”。
- 任务重试:如果某个Map或Reduce任务失败,系统会自动在其他节点重新调度该任务。
- 数据本地性:计算尽量靠近数据存放位置,减少网络IO,同时通过副本机制保证数据不丢失。
- 适合场景:对于对实时性要求不高,但对数据准确性要求极高的金融报表、历史数据归档等场景,MapReduce的稳健性使其成为可靠选择。
生态兼容性
许多传统大数据组件都基于MapReduce构建。
- Hive与HBase:早期的Hive查询引擎底层依赖MapReduce,理解MapReduce有助于优化SQL性能。
- 数据清洗:在进行复杂的数据ETL(抽取、转换、加载)流程时,MapReduce提供了细粒度的控制能力,适合处理非结构化数据的清洗逻辑。
实战:如何编写一个简单的MapReduce程序?
在2026年,虽然Python和Scala更受欢迎,但Java仍是MapReduce的标准语言,以下是一个WordCount(词频统计)的简化逻辑演示,这是入门分布式计算的“Hello World”。
定义Mapper类
Mapper需要继承Mapper类,并重写map方法。
public class WordCountMapper extends Mapper<LongWritable, Text, Text, IntWritable> {
    private final static IntWritable one = new IntWritable(1);
    private Text word = new Text();
    public void map(LongWritable key, Text value, Context context)
            throws IOException, InterruptedException {
        String line = value.toString();
        StringTokenizer tokenizer = new StringTokenizer(line);
        while (tokenizer.hasMoreTokens()) {
            word.set(tokenizer.nextToken());
            context.write(word, one);
        }
    }
}
在这个阶段,每一行文本被拆分成单词,每个单词输出为(word, 1)。
定义Reducer类
Reducer继承Reducer类,重写reduce方法。
public class WordCountReducer extends Reducer<Text, IntWritable, Text, IntWritable> {
    private IntWritable result = new IntWritable();
    public void reduce(Text key, Iterable<IntWritable> values, Context context)
            throws IOException, InterruptedException {
        int sum = 0;
        for (IntWritable val : values) {
            sum += val.get();
        }
        result.set(sum);
        context.write(key, result);
    }
}
Reducer接收所有相同单词的1,将它们相加,输出最终频次。
配置并提交作业
在main函数中配置Job,指定Mapper、Reducer、输入输出路径。
Job job = Job.getInstance(conf, "word count");
job.setJarByClass(WordCount.class);
job.setMapperClass(WordCountMapper.class);
job.setReducerClass(WordCountReducer.class);
job.setOutputKeyClass(Text.class);
job.setOutputValueClass(IntWritable.class);
FileInputFormat.addInputPath(job, new Path(args[0]));
FileOutputFormat.setOutputPath(job, new Path(args[1]));
System.exit(job.waitForCompletion(true) ? 0 : 1);
MapReduce与其他计算模型的对比
选择技术栈时,需要明确不同模型的适用边界,许多用户在寻找大数据处理方案选型时,容易混淆MapReduce、Spark和Flink的区别。
| 特性 | MapReduce | Spark | Flink |
|---|---|---|---|
| 计算模式 | 磁盘读写为主 | 内存计算为主 |
流式计算为主 |
| 延迟性 | 高(分钟/小时级) | 低(秒级) | 极低(毫秒级) |
| 容错机制 | 基于日志重算 | 基于RDD血缘关系 | 基于Chandy-Lamport算法 |
| 适用场景 | 离线批处理 | 迭代计算、交互式查询 | 实时流处理、事件驱动 |
| 资源开销 | 较大(频繁IO) | 中等 | 较小(持续运行) |
据工信部数据显示,近年来企业在构建数据中台时,往往采用混合架构:使用MapReduce处理T+1的离线报表,使用Spark进行即席查询,使用Flink处理实时风控,这种组合拳策略能最大化各组件的优势。
常见问题解答
MapReduce在2026年是否已经淘汰?
MapReduce并未完全淘汰,而是退居幕后,在纯离线批处理场景,尤其是数据量极大且对内存资源敏感的环境中,MapReduce因其低内存占用和高稳定性,仍被部分大型互联网公司保留使用,但在大多数新项目中,Spark和Flink已占据主导地位。
如何优化MapReduce的性能?
优化MapReduce主要关注减少数据倾斜和IO开销,可以通过调整Map和Reduce的任务数量,启用Combiner进行本地聚合,以及使用压缩格式(如Snappy)存储中间数据来提升效率,合理设置HDFS块大小也能显著影响读取性能。
MapReduce适合实时数据分析吗?
不适合,MapReduce的设计本质是批处理,每次作业启动和关闭都有较大的开销,延迟通常在分钟级以上,对于需要秒级甚至毫秒级响应的实时数据分析场景,应选择Flink或Spark Streaming等流式计算框架。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/442739.html