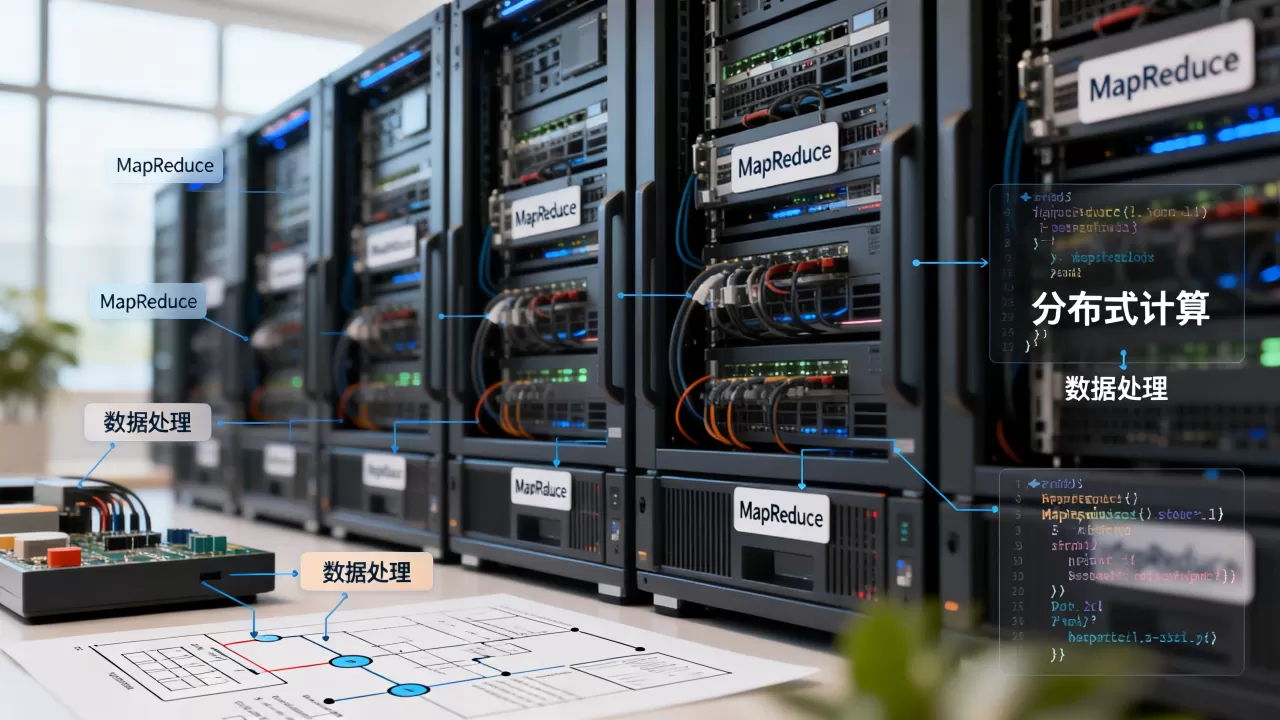
MapReduce是谷歌提出的分布式计算框架,核心逻辑是将大规模数据处理任务拆解为“Map(映射)”和“Reduce(归约)”两个阶段,通过分布式存储与并行计算实现海量数据的高效处理。
在大数据时代,面对TB甚至PB级别的数据,传统单机处理显得力不从心,谷歌在2004年发表的论文中首次提出了MapReduce编程模型,这一概念彻底改变了行业处理数据的方式,它不仅仅是一个技术名词,更是一套解决分布式系统复杂性问题的工程哲学,对于从事数据分析、后端开发或架构设计的从业者来说,理解其底层原理比单纯调用API更为重要。
MapReduce核心机制深度解析
要真正掌握这项技术,必须深入其内部运作流程,MapReduce并非黑盒,其设计初衷是为了简化分布式程序的编写,让开发者无需关心底层网络通信、故障恢复等复杂细节。
从输入到输出的完整链路
整个处理过程可以清晰地划分为三个主要阶段:输入分片、Map阶段处理、Reduce阶段汇总。
Input Splitting:数据分片策略
当海量数据进入系统时,系统首先会根据文件大小和集群节点分布,将数据切分成多个独立的“分片”(Split),每个分片通常对应一个Map任务,业内专家指出,合理的分片大小直接影响并行效率,一般建议设置为HDFS块大小的1-2倍,以避免任务过多导致的调度开销,同时保证负载均衡。
Mapping:并行映射处理
这是数据处理的第一站,每个Map任务读取一个分片数据,将其解析为键值对(Key-Value Pair),开发者需要编写自定义的Map函数,对每条记录进行清洗、过滤或初步转换,在日志分析场景中,Map阶段可能负责提取IP地址、时间戳和请求状态码,这一阶段完全并行执行,互不干扰,充分利用集群中所有节点的CPU资源。
Shuffling:数据洗牌与排序
这是MapReduce中最复杂且最耗时的环节,Map任务完成后,输出结果需要被分发到对应的Reduce任务中,系统会根据Key的哈希值,将具有相同Key的数据发送到同一个Reduce节点,这个过程涉及大量的网络传输和磁盘I/O,因此被称为“Shuffle”,在此期间,数据会按照Key进行排序,确保Reduce阶段能够高效地聚合相同键的数据。
Reducing:归约与汇总
Reduce任务接收来自多个Map任务的中间结果,由于数据已经按Key排序,Reduce函数只需遍历列表,将相同Key的值进行聚合操作,如求和、计数或取最大值,Reduce将结果写入分布式文件系统(如HDFS),完成整个计算流程。
MapReduce vs 现代计算引擎对比
随着技术演进,MapReduce虽然经典,但在实际应用中已逐渐被更高效的引擎取代,了解其局限性,有助于在2026年的技术选型中做出更明智的决定。
性能瓶颈与架构差异
MapReduce基于磁盘I/O,每个阶段结束后都需要将中间结果写入磁盘,这导致了高昂的I/O开销,相比之下,Spark等内存计算引擎将中间数据保留在内存中,使得迭代计算速度提升10倍以上。
适用场景对比分析
| 特性 | MapReduce | Spark | Flink |
|---|---|---|---|
| 计算模式 | 批处理 | 内存批流一体 | 流处理优先 |
| 延迟性 | 高(分钟至小时级) | 中(秒至分钟级) | 低(毫秒至秒级) |
| 容错机制 | 基于日志重算 | 基于RDD血统 | 基于Chandy-Lamport算法 |
| 数据规模 | 适合离线海量数据 | 适合中等规模迭代计算 | 适合实时数据流 |
对于需要实时性要求的场景,如电商交易监控或金融风控,MapReduce显然不是最佳选择,但在某些特定的离线ETL(提取、转换、加载)任务中,由于其稳定性和对磁盘友好的特性,MapReduce依然有一席之地。
实际应用场景与落地指南
尽管新技术层出不穷,MapReduce的思想依然渗透在许多大数据组件中,理解其应用场景,能帮助团队更好地优化现有架构。
日志分析与统计
这是MapReduce最经典的应用,假设你需要统计某大型网站过去一年的PV(页面浏览量)和UV(独立访客数)。
具体操作步骤
- 数据准备:将Web服务器日志文件上传至分布式文件系统。
- 编写Map函数:读取每一行日志,解析出URL作为Key,Value设为1。
- 编写Reduce函数:接收相同URL的所有Value,进行求和计算,得到该URL的总PV。
- 执行作业:提交任务到集群,监控进度直至完成。
这种场景下,数据量巨大但逻辑简单,MapReduce的线性扩展能力优势明显。
倒排索引构建
搜索引擎的核心是倒排索引,MapReduce可以高效地将文档集合转换为“词项-文档ID列表”的映射关系。
实现逻辑
Map阶段读取每个文档,将文档中的每个词提取出来,生成<词, 文档ID>对,Reduce阶段收集所有相同词的文档ID,去重后生成最终的索引条目,这一过程展示了MapReduce在处理非结构化数据转换方面的强大能力。
常见问题与解决方案
MapReduce是什么技术
MapReduce是一种分布式计算编程模型,由谷歌提出,旨在简化大规模数据集的并行处理,它将复杂任务分解为Map和Reduce两个阶段,通过分布式存储和计算资源实现高效数据处理。
MapReduce和Hadoop有什么关系
Hadoop是一个开源的大数据生态系统,其中HDFS负责存储,MapReduce负责计算,MapReduce是Hadoop的核心组件之一,但Hadoop还包括YARN(资源调度)、Hive(数据仓库)等其他组件,可以说,MapReduce是Hadoop的计算引擎,而Hadoop是承载MapReduce运行的平台。
MapReduce适合实时数据处理吗
不适合,MapReduce设计初衷是面向离线批处理,其高延迟特性源于频繁的磁盘I/O操作,对于需要毫秒级响应的实时场景,应选择Flink、Storm或Spark Streaming等流式计算框架。
MapReduce作为大数据领域的奠基者,其“分而治之”的思想至今仍具有深远影响,虽然在实际生产环境中,它可能不再是最前沿的选择,但深入理解其原理,有助于掌握分布式系统的核心逻辑,对于希望深入大数据领域的开发者而言,掌握MapReduce是通往更高级计算框架的必经之路。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/442535.html