Hive数据仓库的计算引擎核心答案是:底层依赖MapReduce进行离线批处理,中期演进为基于内存计算的Tez,而当前主流且高效的选择则是基于LLAP架构的Hive on Spark或基于向量化执行的Hive on Tez,具体选型需根据数据规模、延迟要求及集群资源综合评估。
在构建企业级数据仓库时,选择正确的计算引擎直接决定了查询响应速度和资源利用率,Hive本身并非传统意义上的数据库,而是一个将SQL转换为分布式计算任务的翻译器,它背后的“大脑”才是决定性能的关键,过去,MapReduce是绝对主力,但随着数据量爆炸式增长,其磁盘IO瓶颈日益凸显,业内专家指出,基于内存计算和向量化技术的引擎已成为提升Hive性能的主流方向。

Hive计算引擎的演进与核心对比
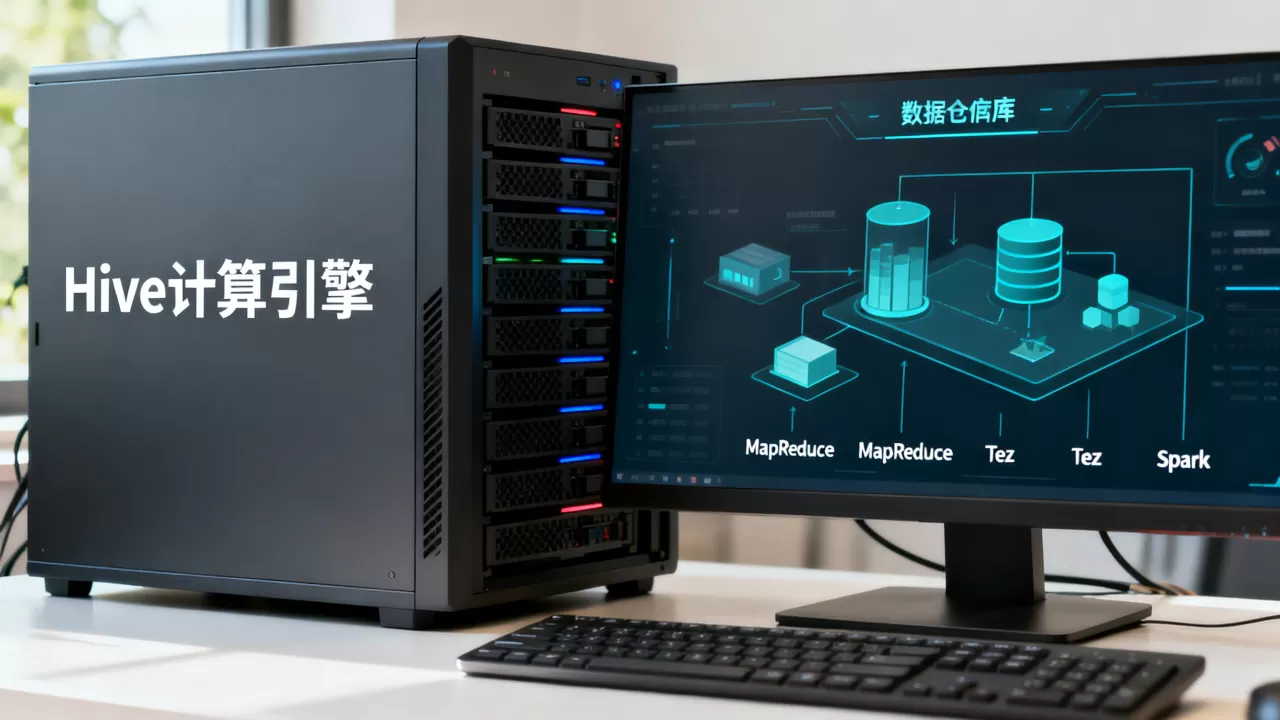
理解Hive计算引擎,首先要看清其发展脉络,从最初的MapReduce到后来的Tez,再到如今的Spark,每一次迭代都旨在解决前者的痛点。
MapReduce:经典但缓慢的基石
MapReduce是Hive最早支持的执行引擎,它的逻辑非常直观:将SQL拆解为Map阶段(处理数据)和Reduce阶段(汇总数据)。
- 优势:稳定性极高,生态兼容性好,几乎所有Hadoop集群都默认支持。
- 劣势:磁盘IO开销巨大,每个Map和Reduce任务结束后,中间结果必须写入磁盘,导致大量I/O等待,对于复杂的多表Join或嵌套查询,任务数量呈指数级增长,作业运行时间往往以小时甚至天计。
- 适用场景:仅适用于对时效性要求极低、数据量适中且集群资源紧张的离线报表场景。
Tez: DAG执行引擎的革新
Tez(The Efficient Execution Engine for Hadoop)的出现,旨在解决MapReduce中不必要的磁盘写入问题,它引入了有向无环图(DAG)的概念,允许将多个MapReduce作业合并为一个逻辑任务。
- 核心改进:中间数据保留在内存中,无需频繁落盘,通过DAG调度,减少了任务启动和上下文切换的开销。
- 性能提升:在相同数据量下,Tez的执行速度通常比MapReduce快3到10倍,具体取决于查询复杂度。
- 兼容性:Tez对Hive SQL的兼容性极好,大多数情况下无需修改SQL即可享受性能红利。
Spark:内存计算的强力竞争者
Spark on Hive(通常指Spark SQL读取Hive元数据)代表了另一种技术路径,Spark基于RDD(弹性分布式数据集),所有计算主要在内存中进行。
- 极致速度:得益于内存计算,Spark在处理迭代算法和复杂ETL流程时,速度远超MapReduce,甚至优于Tez。
- 资源管理:Spark拥有独立的资源管理器(YARN Client/Cluster模式),与Hive共享YARN资源,但调度策略有所不同。
- 挑战:Spark的内存消耗较大,若配置不当,容易引发OOM(内存溢出),Spark与Hive的整合需要额外的配置,如Hive Metastore的连接和序列化兼容性问题。
如何根据业务场景选择最佳引擎
没有绝对的“最好”,只有“最合适”,选择引擎时,需综合考虑数据规模、查询延迟和运维成本。
离线批处理场景
对于T+1的日报、月报生成,数据量通常在TB到PB级别。
- 推荐方案:Hive on Tez 或 Hive on Spark。
- 理由:Tez在资源利用率和稳定性之间取得了良好平衡,适合大多数传统数仓场景,如果团队已有成熟的Spark生态,且查询逻辑复杂(如大量UDF、迭代计算),Spark是更优选择,据行业共识认为,Spark在复杂ETL链路中的执行效率显著高于Tez。
交互式查询与即席分析
当数据分析师需要快速探索数据,要求秒级或分钟级响应时,传统引擎显得力不从心。
- 推荐方案:LLAP(Live Long and Process)架构的Hive on Tez,或结合Presto/Trino。
- LLAP优势:LLAP引入了常驻进程机制,元数据缓存和中间结果缓存常驻内存,避免了每次查询的任务启动开销,对于高频、小数据量的即席查询,LLAP能提供接近数据库的体验。
- 注意:LLAP对集群内存要求较高,需预留充足资源。
实时数据仓库场景
虽然Hive本身是离线引擎,但在某些实时数仓架构中,也会用到Hive进行历史数据回溯。
- 推荐方案:通常不建议直接使用Hive处理实时流数据,建议结合Kafka和Spark Streaming/Flink进行实时计算,结果写入Hive分区表供后续分析。
优化Hive计算性能的关键实操步骤
选定引擎只是第一步,合理的配置优化才能释放最大潜能,以下是经过验证的实操建议。
开启向量化执行
向量化执行(Vectorized Execution)是Hive性能优化的利器,它允许CPU以SIMD(单指令多数据流)方式批量处理数据行,而非逐行处理。
- 操作:在Hive配置中设置
set hive.vectorized.execution.enabled=true;。 - 效果:对于简单的聚合、过滤操作,性能可提升2到5倍,建议所有新集群默认开启。
调整并行度与内存参数
默认配置往往过于保守,需根据集群规模调整。
- Map/Reduce任务数:通过
hive.exec.reducers.bytes.per.reducer控制Reduce数量,默认1GB,若数据倾斜严重,可适当调小以增加并行度。 - 内存分配:对于Spark引擎,调整
spark.executor.memory和spark.executor.cores,对于Tez,调整tez.task.scale.memory.factor,确保每个任务有足够的内存,避免频繁GC(垃圾回收)。
数据倾斜处理
数据倾斜是导致任务卡顿的主要原因。
- 识别:观察YARN UI,若某个Task运行时间远超其他Task,且数据量大,可能存在倾斜。
- 解决:
- 加盐:在Join键上添加随机前缀,打散热点Key,二次聚合时去除前缀。
- 广播小表:使用
set hive.auto.convert.join=true;让Hive自动将小表广播到内存,避免Shuffle。 - 空值过滤:过滤Join键为NULL的数据,或赋予随机值避免集中。
文件格式与存储优化
存储格式直接影响IO效率。
- 推荐格式:ORC或Parquet,这两种格式支持列式存储,仅读取所需列,大幅减少IO。
- 压缩:使用Snappy或ZSTD压缩,Snappy速度快,CPU开销低;ZSTD压缩率高,节省存储但CPU开销略高,业内普遍认为,在存储成本敏感的场景下,ZSTD是更好的选择。
常见问题解答(FAQ)
Hive on Spark和Hive on Tez哪个更省钱?
成本取决于集群资源利用率,Spark内存消耗大,若集群内存充足且查询复杂,Spark的高吞吐量可降低作业运行时间,从而节省YARN资源占用费,Tez资源占用更平稳,适合资源受限或查询简单的场景,总体而言,Spark在大规模复杂计算中单位数据成本更低,但Tez在运维稳定性和中小规模场景下更具性价比。
为什么我的Hive查询很慢,即使换了Spark引擎?
引擎替换并非万能药,常见原因包括:未开启向量化执行、数据未采用列式存储(如仍使用TextFile)、数据倾斜严重、或集群资源争抢,建议首先检查SQL逻辑,使用EXPLAIN查看执行计划,确认是否存在全表扫描或笛卡尔积,确保ORC/Parquet格式和Snappy/ZSTD压缩已启用,监控YARN资源队列,确保查询有足够的CPU和内存配额。
LLAP架构适合所有企业吗?
LLAP适合对交互式查询响应时间有严格要求的场景,如BI报表、即席分析,但它需要额外的常驻进程,占用固定内存,对集群资源有一定要求,若企业主要进行离线批处理,且无高频交互需求,LLAP的额外开销可能得不偿失,对于大多数传统数仓,优化后的Hive on Tez已能平衡性能与成本。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/441612.html