Hive与MySQL并非直接兼容的数据库,而是通过Hive JDBC驱动或Sqoop等ETL工具进行数据交互,Hive负责海量离线分析,MySQL负责事务性业务存储,两者通过数据同步机制实现协同工作。
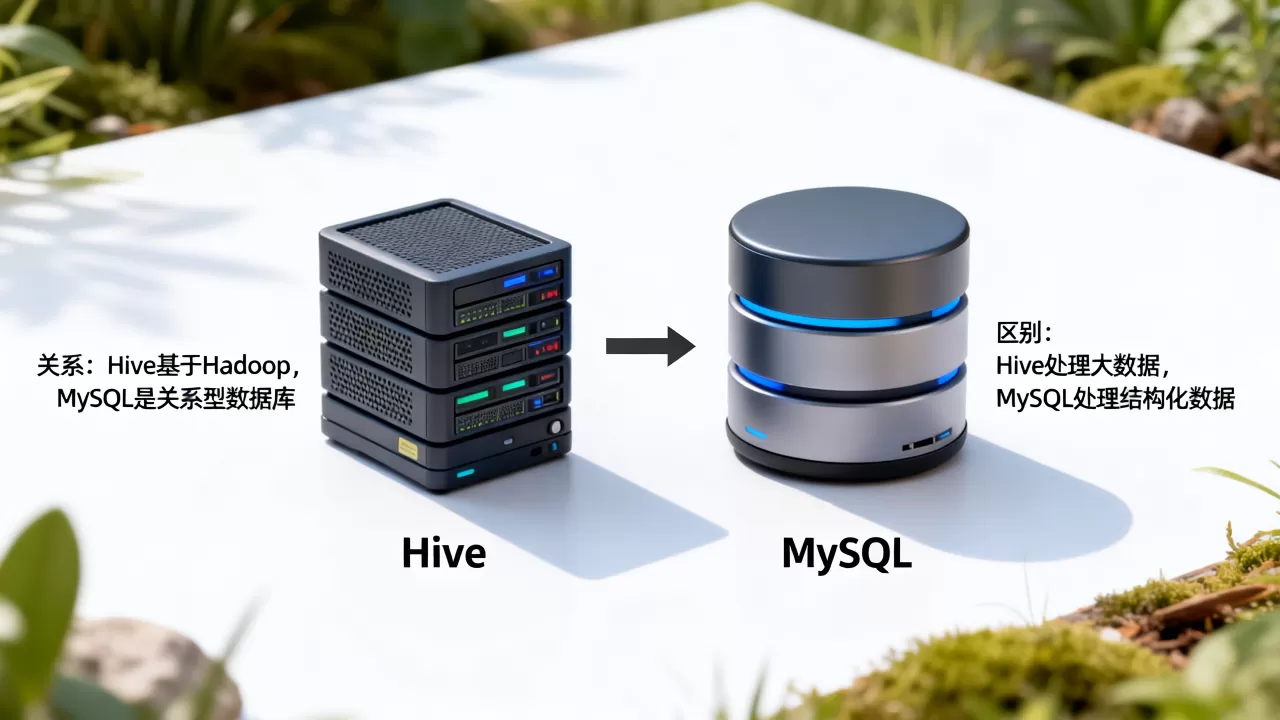
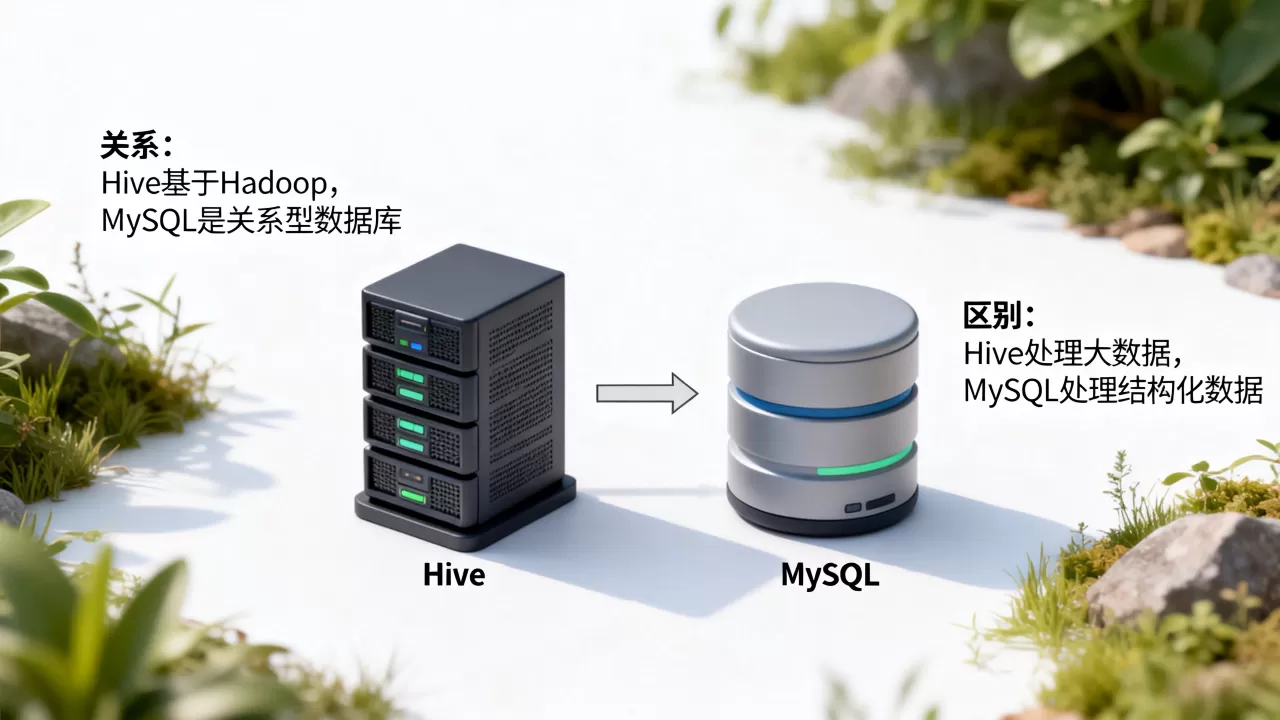
在大数据架构的演进中,Hive和MySQL经常出现在同一个技术栈里,但它们扮演着完全不同的角色,很多初学者容易混淆这两者的关系,甚至试图用MySQL去替代Hive做海量数据存储,或者用Hive去处理高并发的在线交易,这种认知偏差往往导致系统性能瓶颈,理解它们的关系,关键在于理解“离线分析”与“在线事务”的本质区别,Hive基于Hadoop生态系统,设计初衷是处理PB级别的结构化数据,其底层依赖HDFS存储,执行引擎可以是MapReduce、Tez或Spark,而MySQL是传统的关系型数据库(RDBMS),基于磁盘和内存混合存储,擅长处理ACID事务和高并发读写。
Hive与MySQL的核心差异对比
要厘清两者的关系,首先必须明确它们在技术架构上的根本不同,业内专家指出,这种差异决定了它们各自适用的场景,Hive的设计哲学是“写一次,读多次”,强调吞吐量而非延迟;MySQL的设计哲学是“快速读写”,强调低延迟和高一致性。
存储引擎与底层架构
Hive本身并不存储数据,它是一个数据仓库工具,底层数据存储在HDFS(Hadoop Distributed File System)上,HDFS的特点是高容错、高吞吐,但随机读写性能极差,这意味着Hive不适合做单条记录的快速查询或更新,相比之下,MySQL使用InnoDB或MyISAM等存储引擎,数据直接存储在操作系统的文件系统中,支持B+树索引,能够高效地处理随机读写请求。
查询语言与执行模式
两者都支持SQL语法,但语义和执行方式截然不同,Hive使用HiveQL,这是一种类SQL语言,最终会被编译成MapReduce、Tez或Spark作业,这种批处理模式适合全表扫描和聚合计算,但延迟通常在分钟级甚至小时级,MySQL使用标准的SQL,查询直接在数据库引擎中执行,利用索引快速定位数据,延迟通常在毫秒级。
具体场景下的性能表现
- 全表聚合
:如果需要对10亿条订单数据进行按天统计,Hive可以在分布式集群上并行处理,效率远高于MySQL。
- 单条查询:如果需要根据用户ID查询某条订单详情,MySQL利用主键索引可以在几毫秒内返回结果,而Hive启动一个MapReduce作业可能需要几分钟。
- 数据更新:MySQL支持频繁的INSERT、UPDATE、DELETE操作,保持数据强一致性,Hive最初设计为只追加(Append-only),虽然新版支持ACID事务,但在高并发更新场景下性能依然不佳,通常建议通过全量替换或增量追加的方式处理数据变更。
如何实现Hive与MySQL的数据交互
既然两者架构不同,如何让它们协同工作?核心在于数据同步和接口调用,在实际的企业级应用中,通常通过以下几种方式建立连接和传输数据。
使用JDBC驱动进行直连查询
Hive提供了标准的JDBC驱动,允许外部应用程序像连接MySQL一样连接HiveServer2,这种方式适用于需要实时查询Hive中数据并展示在Web应用中的场景。
- 配置HiveServer2:确保HiveServer2服务正常运行,并配置好监听端口(默认10000)。
- 引入依赖:在Java项目中引入hive-jdbc依赖包。
- 建立连接:使用JDBC URL连接Hive,`jdbc:hive2://hostname:10000/default`。
- 执行查询:通过Statement或PreparedStatement执行HiveQL语句。
这种方式适合轻量级的数据检索,但不适合高频次的批量数据交换,因为每次查询都会启动Hive的计算引擎,开销较大。
使用Sqoop进行批量数据同步
Sqoop是Hadoop生态中专门用于在关系型数据库和Hive/HDFS之间传输数据的工具,它是实现Hive与MySQL数据交互最主流的方案。
MySQL到Hive的数据导入
当业务数据在MySQL中积累到一定规模,需要进入数据仓库进行离线分析时,通常使用Sqoop将数据从MySQL抽取到Hive。
- 命令示例:
sqoop import --connect jdbc:mysql://host/db --username user --password pass --table orders --hive-import --hive-table dw_orders --m 4 - 关键参数解析:
--m 4表示使用4个Map任务并行导入,提高速度;--hive-import表示导入后自动在Hive中创建表并加载数据。 - 注意事项:Sqoop默认通过主键拆分数据分片,如果表没有主键,需要指定
--split-by字段,对于大表同步,建议先导入HDFS,再加载到Hive,以避免内存溢出。
Hive到MySQL的数据导出
经过Hive清洗、聚合后的结果数据,如果需要回写到MySQL供前端应用展示,可以使用Sqoop export。
- 操作路径:先将Hive中的结果表数据导出到HDFS指定目录,然后执行
sqoop export --connect ... --table result_table --export-dir /path/to/data。 - 性能优化:导出时建议调整
--batch-size参数,利用JDBC批量插入功能,显著提升写入MySQL的速度。
使用Kettle或DataX进行复杂ETL
对于需要复杂转换逻辑的数据同步任务,Sqoop可能显得不够灵活,Kettle(Pentaho Data Integration)或阿里开源的DataX是更好的选择。
- DataX优势:DataX是异构数据源离线同步工具,支持MySQL、Hive、HDFS等多种源和目标,它采用Framework + Plugin架构,插件化设计使得扩展容易。
- 配置流程:编写JSON配置文件,定义Reader(如MySQLReader)和Writer(如HiveWriter)插件,指定同步字段、并发数和传输通道,这种方式适合定时任务调度,稳定性高。
常见误区与最佳实践
在实际项目中,许多团队在Hive和MySQL的使用上存在误区,导致资源浪费或数据不一致。
用Hive替代MySQL做在线业务
Hive的高延迟特性决定了它无法支撑在线交易系统的实时性要求,如果试图用Hive存储用户实时行为日志并供前端实时查询,会导致用户体验极差,正确的做法是:在线业务使用MySQL或Redis,离线分析使用Hive。
频繁的小数据量同步
Sqoop或DataX等批量同步工具不适合小数据量的频繁同步(如每秒几条),这种场景下,同步工具的启动开销可能远大于数据传输时间,建议采用消息队列(如Kafka)作为缓冲层,MySQL写入Kafka,Hive消费Kafka数据,实现准实时同步。
最佳实践:分层架构设计
- ODS层(原始数据层):直接从MySQL同步到Hive/HDFS,保持数据原貌。
- DWD层(明细数据层):在Hive中进行数据清洗、标准化。
- DWS层(汇总数据层):在Hive中进行轻度或高度汇总,生成宽表。
- ADS层(应用数据层):将汇总结果导出到MySQL或ClickHouse,供前端查询。
这种分层架构既利用了Hive的大数据处理能力,又发挥了MySQL的在线查询优势,是业界公认的最佳实践。
Q&A:Hive与MySQL关系常见疑问
Hive可以直接查询MySQL表吗?
Hive本身不支持直接查询MySQL表,Hive的数据必须存在于HDFS或兼容HDFS的文件系统中,如果需要在Hive中查询MySQL数据,必须先通过Sqoop、DataX等工具将MySQL数据导入Hive,或者使用Hive的External Table指向HDFS上的数据文件,部分第三方工具或插件(如Hive MySQL Storage Handler)可能提供直接访问能力,但稳定性和性能通常不如标准ETL流程,不建议在生产环境使用。
MySQL和Hive的数据类型如何映射?
在数据同步过程中,类型映射至关重要,MySQL的INT对应Hive的INT,VARCHAR对应STRING,DATE对应DATE,TIMESTAMP对应TIMESTAMP或STRING,需要注意的是,MySQL的DECIMAL类型在Hive中通常映射为DOUBLE或STRING,以避免精度丢失,对于复杂的JSON或TEXT类型,建议统一映射为STRING,在Hive中通过UDF函数进行解析。
如何保证MySQL和Hive数据的一致性?
数据一致性主要通过同步策略和校验机制保证,使用Sqoop或DataX的增量同步功能,基于时间戳或自增ID同步数据,避免全量同步带来的性能压力,建立数据校验流程,定期比对MySQL和Hive中的关键指标(如总记录数、金额总和),采用“先写Hive,后写MySQL”或“先写MySQL,异步同步Hive”的策略,明确数据的主源和从源,避免双向同步导致的数据冲突。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/440459.html