目前主流GPU服务器单台最大硬盘空间通常在几十TB到上百TB之间,具体取决于存储架构是本地直连还是分布式集群,高端AI训练集群普遍采用PB级总容量,但单节点有效可用空间受限于RAID冗余和NVMe接口数量。参考2
在构建高性能计算环境时,存储容量往往是比算力更让人头疼的瓶颈,很多技术人员在采购或配置GPU服务器时,容易陷入一个误区,认为只要显卡够强,数据处理就无压力,当面对海量非结构化数据或大规模模型训练任务时,存储空间的扩展性和读写速度直接决定了整个系统的效率,业内专家指出,存储架构的设计必须与GPU的算力峰值相匹配,否则会出现“算力等待数据”的空转现象,造成巨大的资源浪费。
单机物理极限:本地存储的上限在哪里
对于大多数企业而言,首先考虑的是单机GPU服务器的存储能力,这里需要区分“总物理容量”和“有效可用容量”。
标准机架式服务器的配置边界
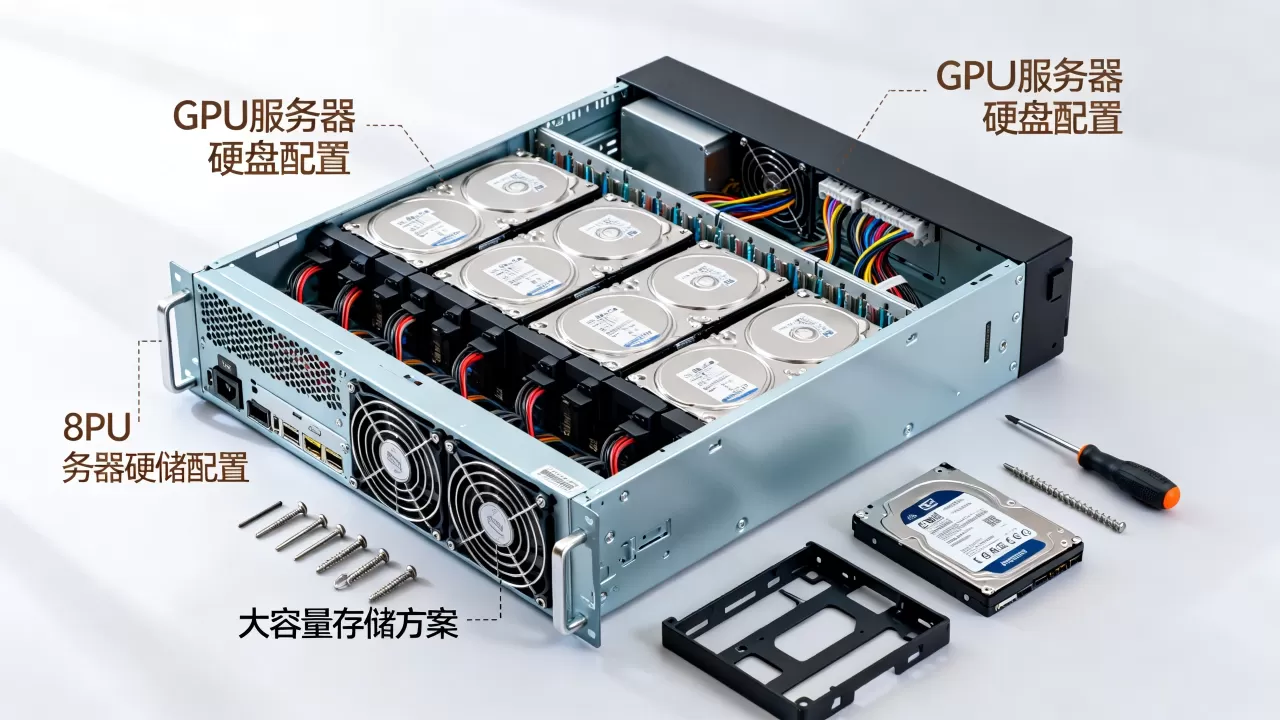
目前主流的双路或四路GPU服务器,其内部通常预留了多个U.2或M.2插槽用于安装高速固态硬盘。
- NVMe SSD主流规格:目前单块企业级NVMe SSD容量普遍达到3.84TB、7.68TB甚至15.36TB。
- 插槽数量限制:一台标准2U或4U服务器,通常能容纳8到16块U.2 NVMe硬盘。
- 计算逻辑:如果一台服务器装满16块15.36TB的硬盘,物理总容量约为245TB。
这仅仅是物理硬盘的总和,在实际部署中,为了数据安全和性能平衡,我们不会将所有空间用于单一用途。
RAID冗余带来的空间损耗
在AI训练场景中,数据一致性至关重要,多数情况下会采用RAID 5或RAID 6阵列,甚至更高级别的RAID 10。
- RAID 5:允许一块硬盘故障,空间利用率约为 (N-1)/N。
- RAID 6:允许两块硬盘故障,空间利用率约为 (N-2)/N。
- 实际可用空间:以16块硬盘组建RAID 6为例,实际可用空间仅为物理容量的87.5%左右,这意味着,即便你购买了245TB的物理空间,系统层面真正可用的数据卷可能只有215TB左右。
操作系统、日志分区以及缓存层还需要预留一部分空间,通常建议预留5%-10%的缓冲空间,以防止因元数据激增导致的磁盘满报错。
分布式存储:突破单机瓶颈的终极方案
当单机存储无法满足PB级数据需求时,分布式存储架构成为必然选择,这也是为什么在询问“gpu服务器最大硬盘空间多大”时,答案往往指向集群总容量而非单台机器。
对象存储与并行文件系统的对比
在深度学习场景中,数据读取模式通常是大块顺序读取或小文件随机读取,这对存储后端提出了不同要求。
| 存储类型 | 典型代表 | 适用场景 | 扩展性 |
|---|---|---|---|
| 并行文件系统 | Lustre, GPFS, BeeGFS | 大规模模型训练,高并发小文件读取 | 极强,可扩展至EB级 |
| 对象存储 | Ceph, MinIO, AWS S3 | 数据归档,静态数据集管理 | 极强,几乎无限扩展 |
| 分布式块存储 | Ceph RBD, GlusterFS |
虚拟机磁盘,数据库存储 | 强,适合中等规模集群 |
业内共识认为,对于千卡以上的GPU集群,并行文件系统(如Lustre)是首选,因为它能提供更低的延迟和更高的IOPS,而对象存储则更适合存放训练好的模型权重或历史数据集,通过高速网络挂载到计算节点。参考2
网络带宽成为新的瓶颈
在分布式存储中,硬盘空间不再是唯一限制,网络带宽往往成为制约因素。
- InfiniBand网络:目前主流AI集群多采用IB网络,单节点带宽可达400Gbps甚至800Gbps。
- 以太网升级:部分场景开始使用200Gbps或400Gbps以太网,成本更低但延迟略高。
- 数据吞吐计算:如果存储系统总吞吐量无法喂饱GPU集群的数据需求,即使硬盘空间再大,GPU也会处于等待状态,存储扩容必须与网络升级同步进行。
选型建议:如何确定你的最大需求
确定“最大硬盘空间”并非越大越好,而是需要匹配业务场景,不同行业对存储的需求差异巨大。
计算机视觉与NLP场景差异
- 计算机视觉(CV):图像数据通常较大,但预处理后可压缩,对于4K视频训练,单帧数据量可达几十MB,一个数据集轻松达到TB级别,建议采用本地NVMe SSD作为缓存层,后端连接大容量对象存储。
- 自然语言处理(NLP):文本数据相对较小,但Token化后的数据集可能非常庞大,万亿Token级别的语言模型训练,需要极高的IOPS来读取随机访问的文本块,高速并行文件系统的性能比单纯的空间大小更重要。
成本与性能的平衡策略
在预算有限的情况下,建议采用分层存储架构:
- 热数据层
:使用少量高性能NVMe SSD,存放当前正在训练的数据集和模型检查点。
- 温数据层:使用SAS SSD或大容量HDD,存放近期使用的历史数据。
- 冷数据层:使用磁带库或低成本对象存储,存放归档数据。
据工信部相关数据显示,近年来企业级存储成本逐年下降,但高性能NVMe SSD的价格依然较高,合理分配各层级存储比例,是控制总拥有成本(TCO)的关键。
常见问题解答
GPU服务器最大硬盘空间受什么限制?
主要受限于物理插槽数量、背板带宽、RAID卡缓存容量以及电源和散热设计,操作系统对单卷大小的支持也是软件层面的限制因素。
分布式存储比单机存储好在哪里?
分布式存储提供了横向扩展能力,可以随着业务增长不断添加节点,而单机存储受限于物理尺寸,分布式存储具备更高的数据冗余性和可用性,单点故障不会影响整体服务。
如何监控GPU服务器的存储使用情况?
可以使用df -h命令查看整体磁盘使用情况,使用iostat -x 1监控磁盘I/O性能,使用nfsstat或smbstatus检查网络存储连接状态,对于并行文件系统,还需使用专用的管理工具监控元数据服务器状态。
未来存储技术会如何改变GPU服务器?
随着CXL(Compute Express Link)技术的普及,内存和存储之间的界限将逐渐模糊,GPU可能直接访问大容量持久性内存,从而减少对传统硬盘的依赖,实现更快的数据加载速度。
GPU服务器的最大硬盘空间并非一个固定数值,而是一个根据架构、业务需求和预算动态变化的变量,对于大多数企业,建议从单机20-50TB的有效空间起步,逐步向分布式架构演进,以确保数据处理的灵活性和高效性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/417969.html