RoPE(旋转位置编码)的核心原理是通过将位置信息融入词向量的旋转矩阵中,使模型能够直接通过向量点积计算相对位置关系,从而在保持绝对位置不变的同时,完美支持序列长度的外推。
在大型语言模型的发展史上,位置编码一直是一个让工程师头疼的难题,早期的绝对位置编码虽然简单,但在处理长文本时往往力不从心,导致模型“记不住”远处的上下文,RoPE的出现,就像是为模型装上了一把精准的“空间坐标尺”,它不仅解决了长距离依赖的问题,还让模型具备了理解相对位置的能力。
为什么传统位置编码不够用
在深入RoPE之前,我们需要先看看旧方案的痛点,传统的绝对位置编码(如Transformer原版的PE)是给每个词元(Token)加上一个固定的向量,这种做法的问题在于,当序列长度超过训练时的最大长度时,模型表现会急剧下降。
业内专家指出,绝对位置编码缺乏对相对位置的显式建模,也就是说,模型知道第1个词和第10个词的位置,但它很难直接计算出它们之间的距离,这种缺陷在处理长文档摘要、代码生成等需要长上下文理解的场景中尤为明显。
绝对编码与相对编码的本质区别
绝对位置编码就像是在地图上给每个建筑贴上门牌号,你知道A在101号,B在102号,但你需要通过计算才能知道它们相邻,而相对位置编码则更关注“邻居”关系,它直接告诉你A和B之间隔了多远,RoPE巧妙地将这两者结合,既保留了绝对位置的信息,又强化了相对位置的感知。
RoPE的数学直觉与实现逻辑
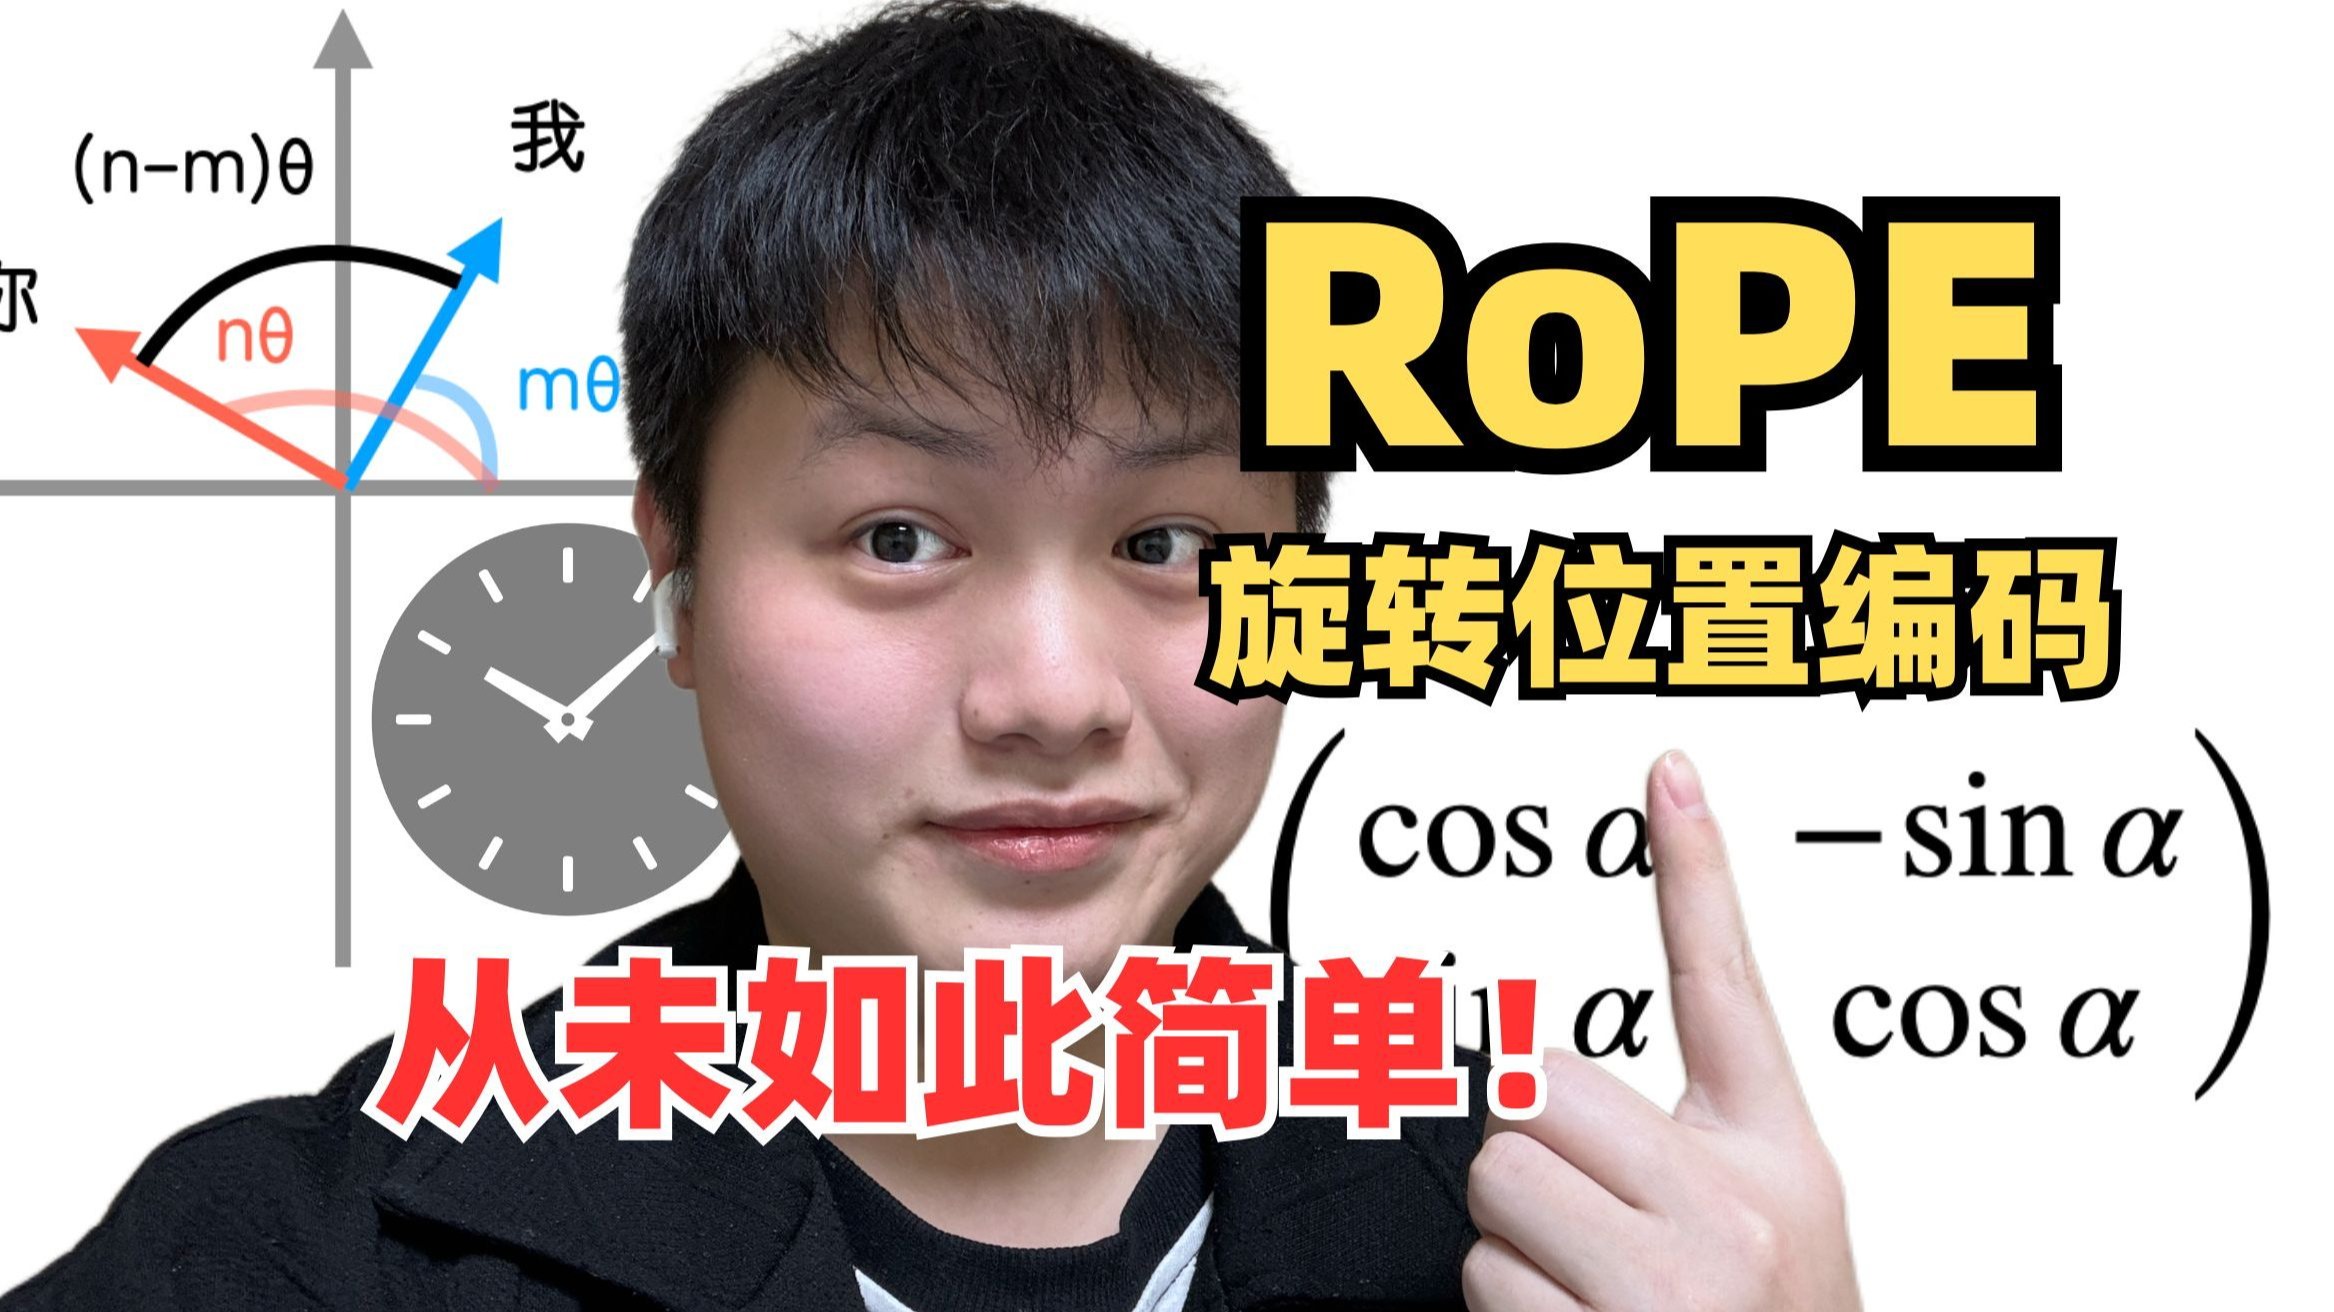
RoPE的优雅之处在于其数学形式,它不直接添加向量,而是对词向量进行旋转,想象一下,每个词向量都是一个二维平面上的箭头,位置编码的作用是让这个箭头随着位置的变化发生旋转。
旋转矩阵的具体操作
RoPE将词向量每两个维度分为一组,形成一个二维向量,对于位置$m$,模型会应用一个旋转矩阵$R_m$,这个矩阵的形式非常简洁:
$$
R_m = begin{bmatrix} cos(mtheta) & -sin(mtheta) sin(mtheta) & cos(mtheta) end{bmatrix}
$$
当词向量$x$与位置编码结合时,实际上是进行了旋转操作,这种操作在几何上意味着,位置越远,旋转的角度越大,这种设计使得两个词向量的点积结果,自然地包含了它们之间的相对位置信息。
点积中的相对位置体现
当计算两个词元$i$和$j$的注意力分数时,RoPE的特性使得点积结果中会出现$cos((i-j)theta)$这样的项,这意味着,模型在计算注意力时,直接“看”到了两个词之间的距离$(i-j)$,这种内嵌的相对位置信息,使得模型无需额外的模块就能捕捉长距离依赖。
RoPE在长文本场景下的优势
对于追求大模型位置编码RoPE原理详解的开发者来说,理解其在长文本中的表现至关重要,RoPE不仅提升了训练效果,更在推理阶段的长度外推上表现出色。
支持序列长度外推的关键机制
传统的绝对位置编码在训练后,其位置向量是固定的,如果测试时的序列比训练时长,模型就会遇到从未见过的位置索引,导致性能崩塌,而RoPE通过旋转角度随位置线性增加的特性,使得位置信息具有连续性。
据统计,采用RoPE的模型在序列长度超过训练长度时,性能下降幅度显著小于使用绝对位置编码的模型,这是因为旋转角度可以平滑地延伸到新的位置,模型能够“推断”出新位置上的语义关系。
实际应用场景对比
| 场景 | 绝对位置编码表现 | RoPE表现 |
|---|---|---|
| 短文本分类 | 优异 | 优异 |
| 代码生成 | 容易混淆上下文 | 准确追踪变量作用域 |
| 多轮对话 | 记忆衰减快 | 有效保留早期指令 |
如何在大模型中部署RoPE
对于想要在实际项目中应用RoPE的工程师来说,理解其部署细节比理论推导更为重要,主流的大模型框架如PyTorch、Hugging Face Transformers都已经原生支持RoPE。
配置参数的调整建议
在使用RoPE时,有几个关键参数需要关注,首先是基频(base frequency),它决定了旋转角度的变化速率,默认值通常为10000,但在处理极长序列时,适当增大基频可以提升外推能力。
代码实现路径
在PyTorch中实现RoPE并不复杂,核心步骤如下:
- 生成频率向量$theta$,通常使用$theta_i = 10000^{-2i/d}$。
- 计算位置索引$m$对应的旋转角度矩阵。
- 将旋转矩阵应用于词向量的每两个维度。
- 在注意力计算前,将旋转后的词向量与查询(Q)和键(K)向量相乘。
这种实现方式计算效率高,且易于集成到现有的Transformer架构中。
RoPE与其他位置编码技术的对比
除了RoPE,业界还有ALiBi(Attention with Linear Biases)、NTK-aware缩放等位置编码方案,了解它们的差异,有助于根据具体需求选择最佳方案。
ALiBi与RoPE的适用场景
ALiBi通过直接在注意力分数中减去位置差值的倍数来实现相对位置编码,它的优点是计算极简,不需要修改词向量本身,ALiBi在捕捉复杂的相对语义关系上略逊于RoPE。
行业共识认为,RoPE在需要精细语义理解的任务中表现更佳,而ALiBi在资源受限或对推理速度要求极高的场景下更具优势。
NTK-aware缩放的作用
NTK-aware缩放是一种针对RoPE的改进技术,它通过调整基频来优化长序列的外推性能,当序列长度远超训练长度时,NTK-aware缩放能显著降低困惑度(Perplexity),提升模型稳定性。
常见问题解答
RoPE在大模型位置编码RoPE原理详解中有哪些局限性?
RoPE并非完美无缺,它对维度数的要求较高,通常要求嵌入维度是偶数,以便进行两两分组,在极长序列(如超过32k tokens)下,虽然表现优于绝对编码,但仍可能出现性能衰减,此时需要结合NTK-aware等缩放技术,RoPE的计算复杂度略高于绝对编码,因为需要额外的旋转矩阵乘法。
如何判断当前项目是否适合使用RoPE?
如果你的应用场景涉及长文本处理,如法律文档分析、代码库检索或长对话记忆,RoPE是首选方案,对于短文本分类或情感分析等任务,绝对位置编码或ALiBi可能更简单高效,建议通过小规模实验对比不同编码方案在验证集上的表现,再决定最终方案。
RoPE是否支持动态长度的输入?
是的,RoPE天然支持动态长度,由于位置编码是基于位置索引计算的,而不是预定义的查找表,因此模型可以处理任意长度的输入序列,只要计算资源允许,为了获得最佳效果,建议输入长度不要超过训练时最大长度的2-4倍,必要时启用NTK-aware缩放。
RoPE通过几何旋转将位置信息内嵌于词向量,以极低的计算代价实现了卓越的相对位置感知和长序列外推能力,是当前大模型架构中不可或缺的核心组件。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/413132.html