KV Cache是LLM推理时的“短期记忆”机制,它通过缓存历史计算的键值对,避免重复计算,从而将生成速度提升数倍并显著降低显存占用。
想象一下,当你和朋友聊天时,你不需要每次说话都重新回忆对方上一句说了什么,而是直接基于当下的语境继续对话,大语言模型(LLM)也是如此,如果没有KV Cache,模型每生成一个新词,都要把之前所有的输入重新算一遍,这就像每次考试都要重新做一遍前面的所有题目,效率极低,KV Cache的存在,就是为了记住“过去”,让模型能够轻装上阵,专注于“和“。
KV Cache的核心原理与工作机制
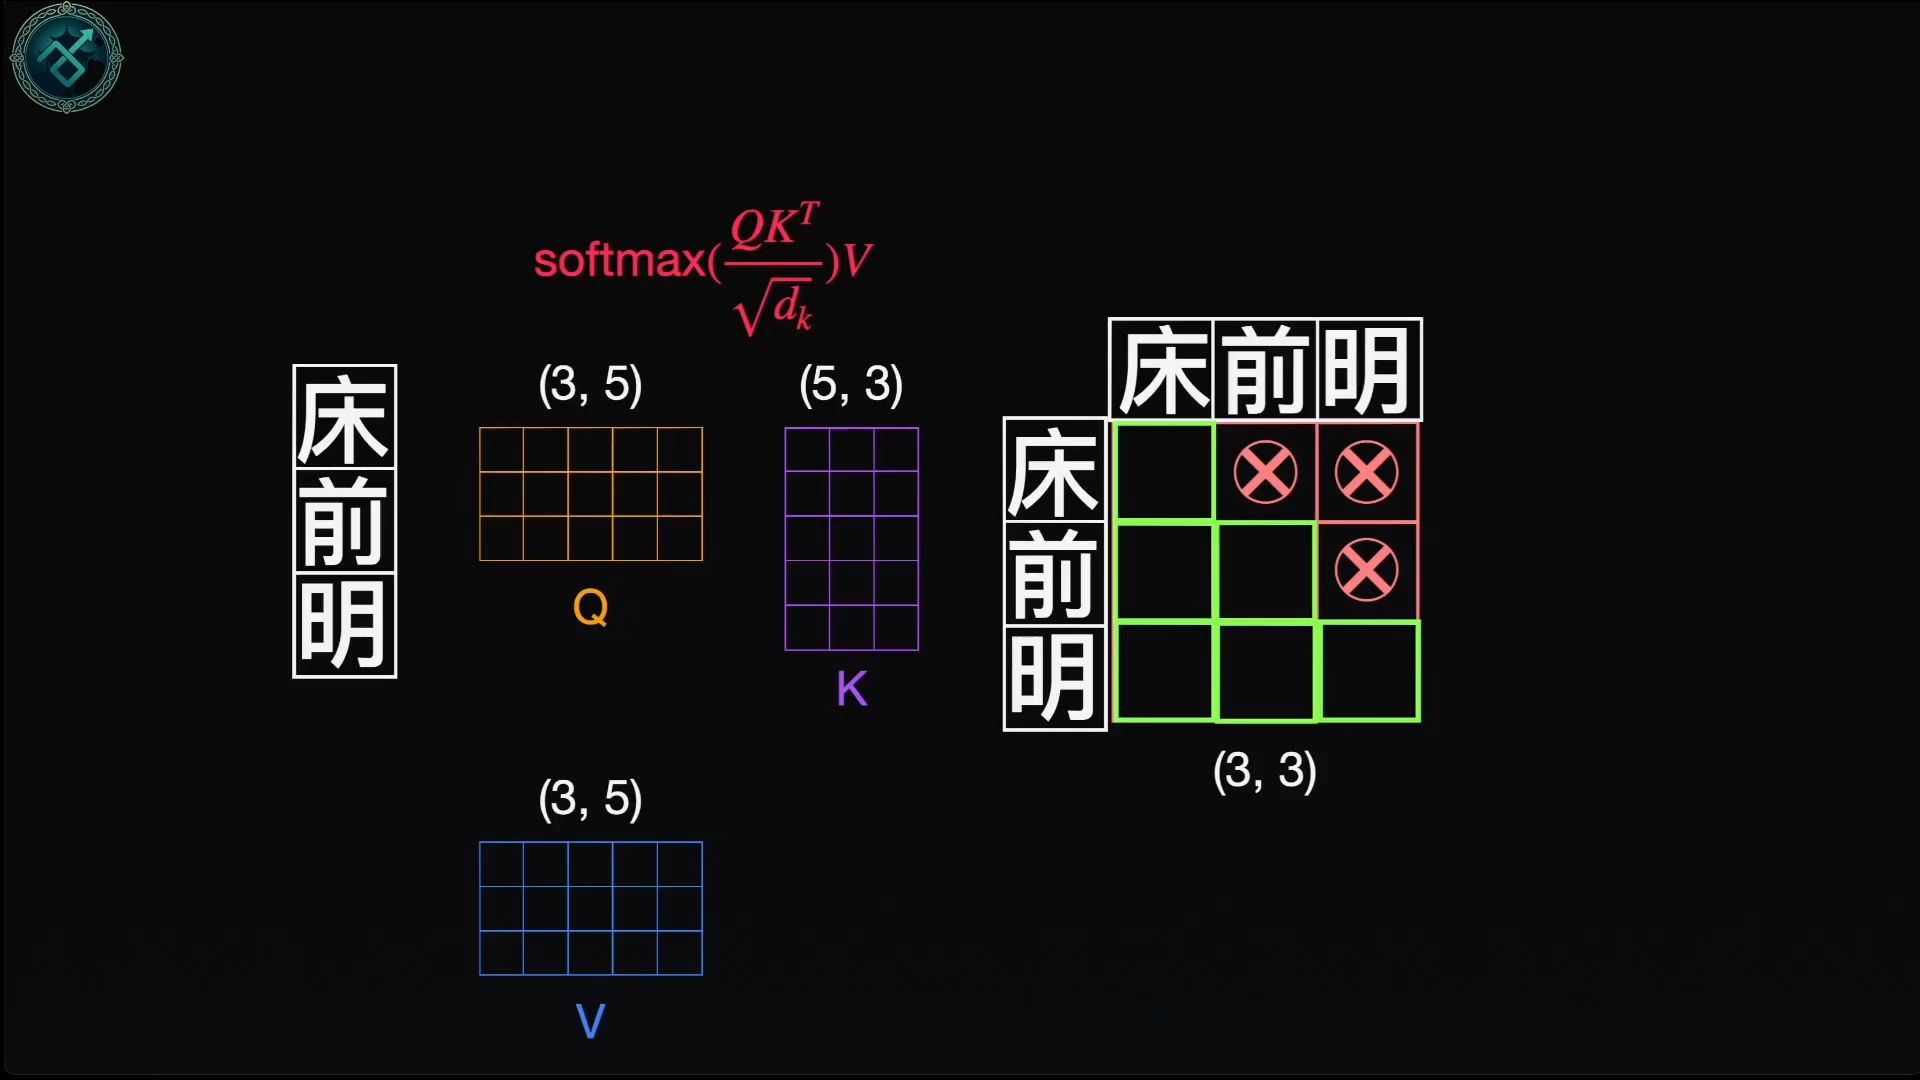
要理解KV Cache,首先得拆解Transformer架构中的注意力机制,在自回归生成过程中,模型每次只预测下一个token,为了计算当前token与之前所有token的注意力权重,模型需要访问之前的Key(K)和Value(V)矩阵。
为什么需要缓存?
在传统的推理流程中,假设一个序列长度为N,生成第N个词时,模型需要计算当前词与前面N-1个词的注意力,如果不缓存,这意味着每次生成都要进行O(N^2)复杂度的矩阵乘法,随着对话长度增加,这种重复计算会迅速耗尽算力资源。
业内专家指出,KV Cache通过空间换时间的策略,将每次生成的计算复杂度从O(N^2)降低到O(N),模型在第一次处理输入时,会将所有token的K和V值计算出来并存储在显存中,后续生成新token时,只需将新的K和V追加到缓存末尾,即可直接进行计算。
具体操作流程
- 预填充阶段(Prefill):处理用户输入的完整Prompt,计算所有token的K和V,存入KV Cache。
- 解码阶段(Decode):每次生成一个新token,计算该token的K和V,追加到KV Cache中。
- 注意力计算:使用完整的KV Cache(历史+当前)计算注意力分数,生成下一个token。
这种机制使得生成速度不再随序列长度线性增长,而是保持相对恒定,除非显存成为瓶颈。
KV Cache对性能的影响与显存管理
虽然KV Cache极大提升了推理速度,但它也是显存占用的主要来源之一,在长文本场景下,KV Cache的大小可能超过模型参数本身的大小。
显存占用的量化分析
KV Cache的内存占用与序列长度、批次大小、模型层数及隐藏层维度成正比,对于一个大模型,假设隐藏层维度为4096,FP16精度下每个K或V值占2字节。
| 参数 | 影响 | 优化方向 |
|---|---|---|
| 序列长度 | 线性增长 | 截断长文本、使用滑动窗口 |
| 批次大小 | 线性增长 | 动态批处理、请求排队 |
| 模型层数 | 线性增长 | 量化压缩、层选择性卸载 |
据统计,在100K长上下文场景下,KV Cache可能占用数百GB显存,远超模型权重本身,如何高效管理KV Cache成为部署大模型的关键挑战。
常见优化技术对比
针对显存压力,业界发展出多种优化方案,各有优劣:
- PagedAttention:借鉴操作系统虚拟内存思想,将KV Cache分散存储在非连续的内存页中,支持动态分配,解决碎片化问题,vLLM框架广泛采用此技术,显著提升吞吐量。
- 量化KV Cache:将FP16精度的K/V值压缩为INT8或FP8,减少50%显存占用,同时保持较高精度损失可控。
- 滑动窗口注意力:仅保留最近N个token的KV Cache,丢弃更早的历史信息,适用于对长期依赖不敏感的场景,如实时翻译。
- 键值对压缩:通过聚类或近似方法,合并相似的KV向量,减少存储量。
行业共识认为,PagedAttention在通用场景下平衡了性能与显存效率,是目前生产环境的首选方案。
实际应用场景中的KV Cache策略
不同应用场景对KV Cache的需求差异巨大,理解这些差异,有助于选择合适的推理引擎和优化策略。
长文档分析与问答
在RAG(检索增强生成)场景中,用户可能上传数百页的PDF文档,KV Cache的大小成为瓶颈。
实操建议
- 文档切片:将长文档切分为小块,分别计算Embedding和KV Cache,避免单次加载过大上下文。
- 缓存复用:对于相同文档的不同查询,复用已计算的KV Cache,避免重复计算。
- 选择性加载:仅加载与查询相关的文档片段,减少无效KV Cache占用。
实时对话与聊天机器人
对话场景具有上下文动态增长的特点,用户可能进行多轮交互。
实操建议
- 会话状态管理:为每个用户会话维护独立的KV Cache,支持快速切换和恢复。
- 过期清理:定期清理长时间未活动的会话缓存,释放显存资源。
- 优先级调度:对高优先级用户(如VIP客户)分配更多KV Cache资源,保障响应速度。
代码生成与辅助编程
代码生成需要理解大量上下文,包括函数定义、类结构等。
实操建议
- 语法树辅助:结合AST(抽象语法树)信息,智能裁剪无关代码片段,优化KV Cache利用率。
- 增量更新:仅对修改的代码部分重新计算KV Cache,避免全量重算。
未来趋势与关键技术演进
随着模型规模扩大和上下文窗口延长,KV Cache管理技术将持续演进。
异构计算与卸载
KV Cache可能不再完全驻留GPU显存,而是采用CPU内存或磁盘存储的混合架构。
技术路径
- GPU-CPU卸载:将不常用的KV Cache块卸载到CPU内存,按需加载回GPU。
- GPU-磁盘卸载:对于极长上下文,将历史KV Cache持久化到高速SSD,进一步降低显存压力。
这种架构虽增加I/O延迟,但能支持百万级token的上下文,适用于法律、医疗等专业领域。
算法级优化
除了系统级优化,算法层面也在探索更高效的状态表示。
- 状态空间模型(SSM):如Mamba架构,以线性复杂度处理长序列,天然避免KV Cache爆炸问题。
- 压缩注意力机制:通过低秩分解或稀疏化,减少KV矩阵维度。
业内专家指出,混合架构(Transformer+SSM)可能是平衡性能与效率的长期解决方案。
FAQ:关于KV Cache的常见疑问
KV Cache到底占多少显存?
KV Cache显存占用取决于序列长度、批次大小和模型维度,以7B模型、FP16精度、序列长度10K为例,单请求KV Cache约占1-2GB显存,若批次大小为32,总占用可达30-60GB,实际占用需根据具体配置计算,建议使用vLLM等工具进行 profiling。
如何判断是否需要优化KV Cache?
当出现以下情况时,建议优化:
- 显存利用率持续高于85%,导致OOM(内存溢出)。
- 长文本场景下,推理延迟随序列长度显著增加。
- 多用户并发时,吞吐量无法满足SLA要求。
可通过监控工具观察KV Cache占用比例,若超过模型权重的50%,即需优化。
KV Cache与模型量化有什么区别?
模型量化压缩的是权重参数,影响模型精度;KV Cache优化的是推理过程中的中间状态,主要影响显存和速度,两者可结合使用,如量化权重+PagedAttention,实现显存和速度的双重优化。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/412921.html