在Ubuntu 20.04系统中,通过内置的Python 3标准库csv模块或第三方库pandas,可以高效、稳定地完成CSV文件的读取与写入操作,其中pandas适合处理大规模数据,而csv模块则更轻量且无需额外安装。
Ubuntu 20.04作为企业级服务器和个人开发者的主流选择,其预装的Python环境为数据处理提供了坚实基础,许多开发者在初次接触Linux环境下的文件操作时,往往纠结于Ubuntu 20.04 python读取csv乱码怎么解决,这通常是因为编码格式未统一所致,本文将通过实操步骤,带你掌握最稳妥的数据处理方案。
环境准备与基础配置
在开始编写代码之前,确保你的Ubuntu 20.04系统已经安装了Python 3,Ubuntu 20.04默认携带Python 3.8,这足以满足绝大多数CSV处理需求。
验证Python环境
打开终端,输入以下命令检查Python版本:
python3 --version
如果输出显示Python 3.8.x,则说明环境就绪,若未安装,可通过以下命令快速部署:
sudo apt update
sudo apt install python3 python3-pip
选择工具库:标准库vs第三方库
业内专家指出,对于简单的CSV读写任务,内置csv模块是最佳选择,因为它零依赖、启动快,当涉及Ubuntu 20.04 python pandas读取csv性能对比时,pandas库凭借向量化操作,在处理百万级行数据时优势明显。
csv
pandas库:适合大数据分析、复杂清洗,需通过pip install pandas安装。
使用标准库csv模块读写文件
csv模块是Python标准库的一部分,无需额外安装,非常适合轻量级任务。
读取CSV文件
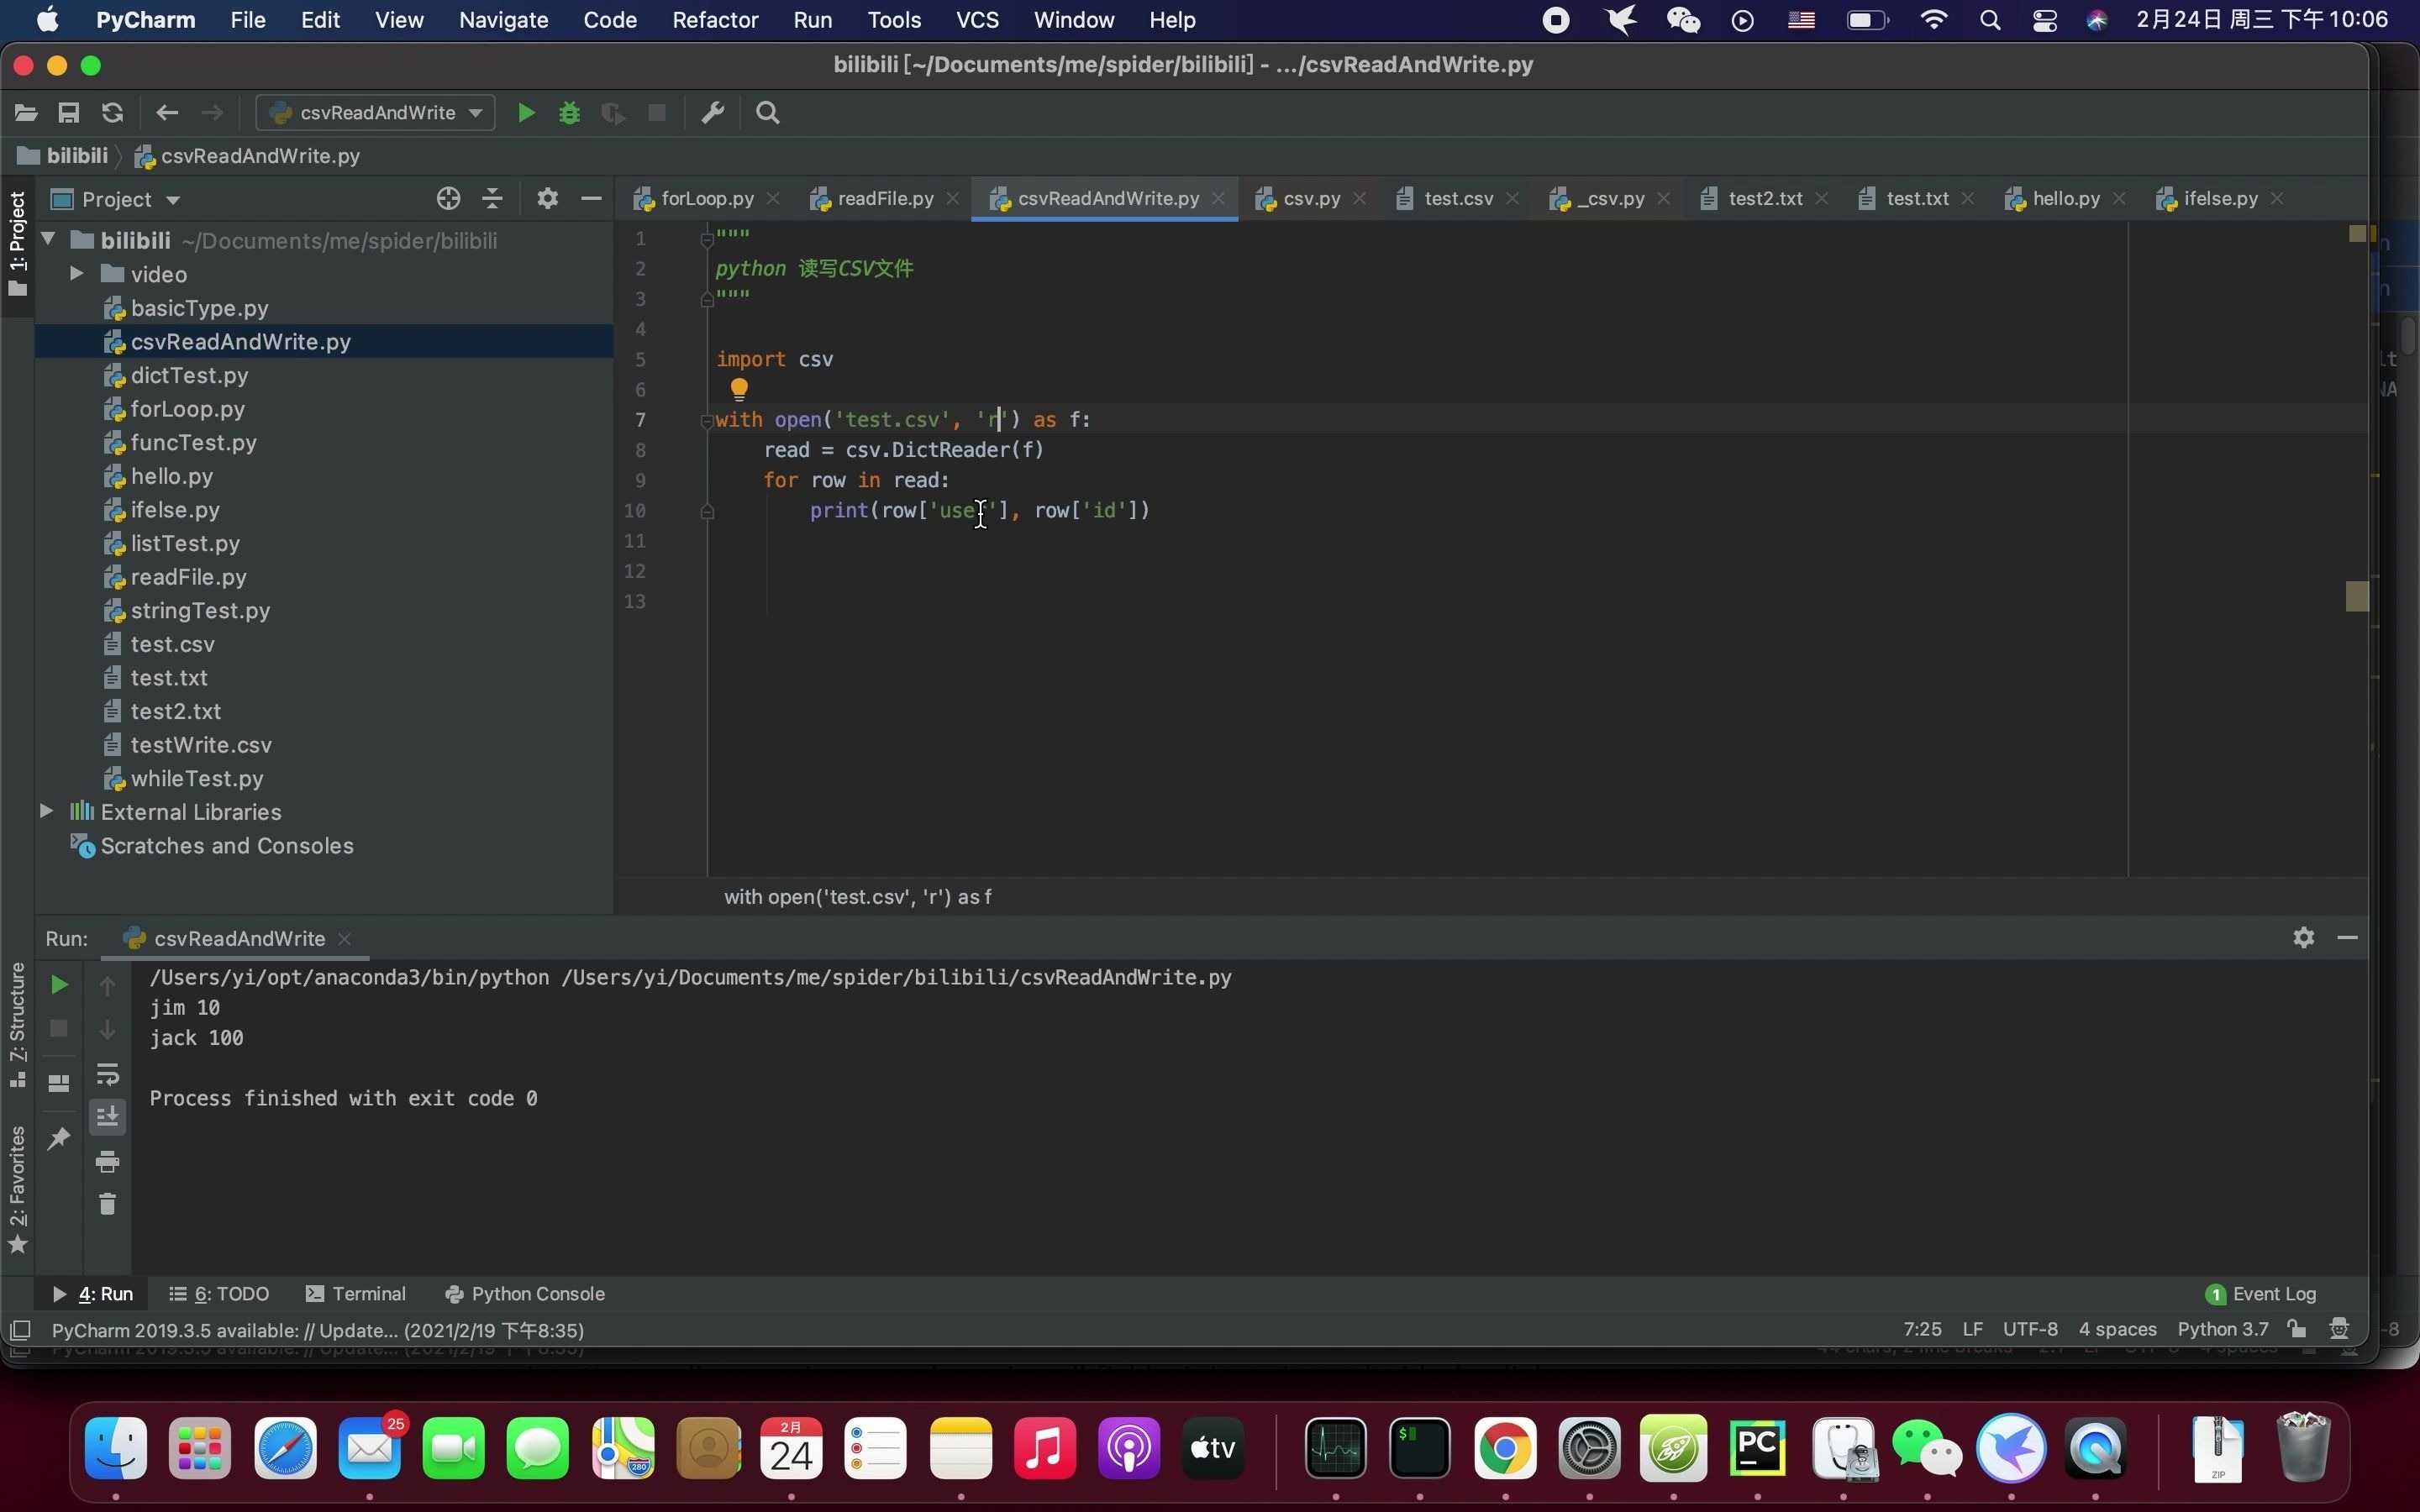
读取操作的核心在于处理文件句柄和迭代器,以下代码展示了如何安全地读取CSV内容:
import csv
# 使用utf-8编码打开文件,避免中文乱码
with open('data.csv', mode='r', encoding='utf-8') as file:
    csv_reader = csv.reader(file)
    # 遍历每一行
    for row in csv_reader:
        print(row)
这里的关键点是encoding='utf-8',在Ubuntu环境下,许多中文CSV文件可能保存为gbk编码,若读取时出现乱码,需将编码参数改为encoding='gbk'。
写入CSV文件
写入操作需要指定模式为'w',并处理表头,注意,newline=''参数在Python 3中至关重要,用于防止在Windows风格换行符下产生空行,虽然在Linux中影响较小,但保持习惯有助于跨平台兼容性。
import csv
data = [
    ['Name', 'Age', 'City'],
    ['Alice', 30, 'Beijing'],
    ['Bob', 25, 'Shanghai']
]
with open('output.csv', mode='w', newline='', encoding='utf-8') as file:
    writer = csv.writer(file)
    writer.writerows(data)
使用Pandas库进行高效数据处理
对于需要复杂分析的场景,pandas提供了更高级的数据结构DataFrame。
安装与导入
在终端执行:
pip3 install pandas
在代码中导入:
import pandas as pd
读取与写入操作
pandas的read_csv和to_csv函数极其简洁,且自动处理许多边缘情况。
# 读取CSV
df = pd.read_csv('data.csv', encoding='utf-8')
# 查看前几行
print(df.head())
# 写入CSV,index=False表示不保存行索引
df.to_csv('output_pandas.csv', index=False, encoding='utf-8')
处理缺失值与数据类型
pandas允许在读取时直接指定列类型,避免后续转换麻烦。
df = pd.read_csv('data.csv', dtype={'Age': int, 'City': str})
常见错误排查与优化技巧
在实际操作中,开发者常遇到编码错误、分隔符不匹配等问题。
编码问题解决方案
若读取中文CSV出现UnicodeDecodeError,请尝试以下编码:
utf-8:国际标准,首选。gbk:常见于国内Windows生成的Excel导出文件。latin-1:兼容性强,可读取任何字节流。
分隔符识别
CSV并非总是以逗号分隔,若文件使用制表符或分号,需在读取时指定
sep参数:
# 读取制表符分隔的文件
df = pd.read_csv('data.tsv', sep='t')
大文件内存优化
对于超过内存限制的大文件,pandas支持分块读取:
chunk_size = 10000
for chunk in pd.read_csv('large_file.csv', chunksize=chunk_size):
    process(chunk)
Q&A:Ubuntu 20.04 Python CSV读写常见问题
Ubuntu 20.04 python读取csv乱码怎么解决
乱码通常由编码格式不匹配引起,首先确认CSV文件的实际编码,可使用file -i filename.csv命令查看,若文件为GBK编码,请在open()或pd.read_csv()中显式指定encoding='gbk',若不确定,可尝试encoding='utf-8-sig'以处理带有BOM头的UTF-8文件。
Ubuntu 20.04 python pandas读取csv性能对比
csv模块逐行读取,内存占用极低,但处理速度慢;pandas一次性加载数据到内存,利用C底层优化,速度极快,但内存消耗大,对于小于100MB的文件,两者差异不明显;对于GB级文件,pandas的分块读取或csv模块的迭代器是更优选择。
如何在Ubuntu 20.04中安装pandas库
确保已安装Python3和pip3,执行sudo apt install python3-pandas或通过pip3 install pandas安装,建议创建虚拟环境python3 -m venv myenv以避免依赖冲突,激活后再次执行pip安装命令。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/412240.html