

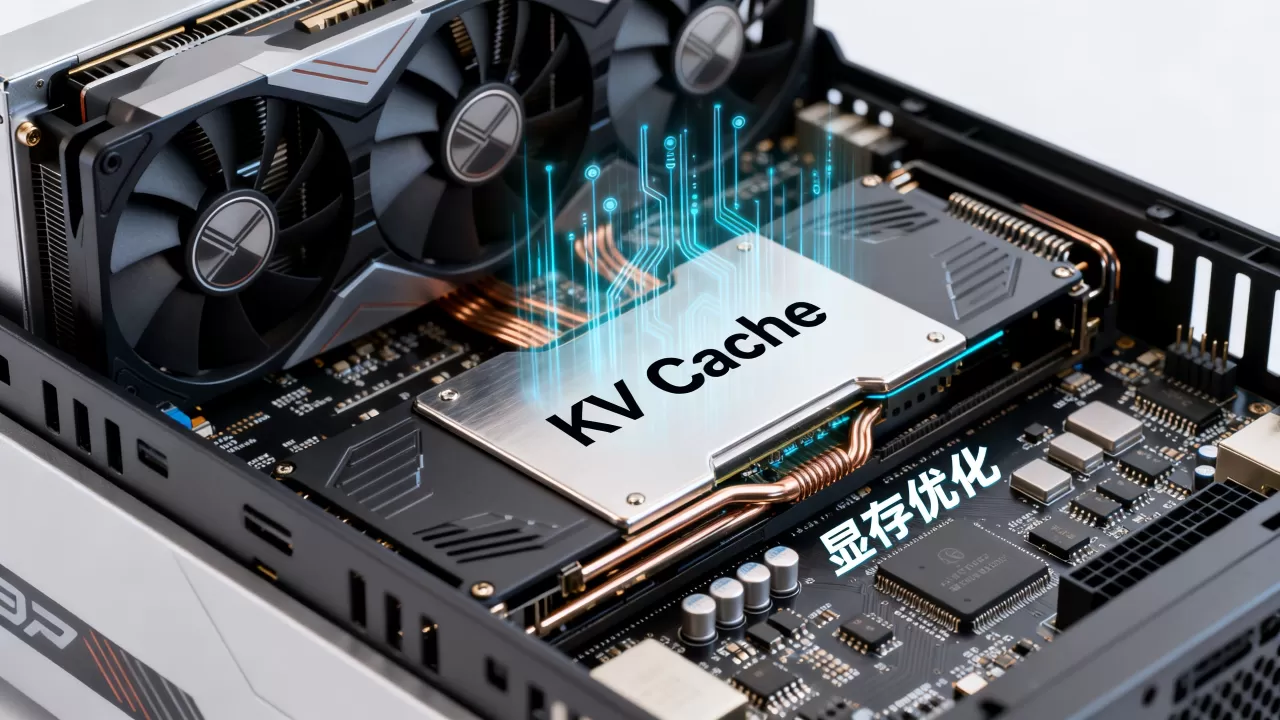
大模型KV Cache占用大量显存的核心原因在于其存储了所有历史Token的中间计算状态,随着对话长度线性甚至二次方增长,这部分静态数据的体积迅速膨胀,最终挤占了模型权重和激活值的计算空间。
理解这个问题,不需要深奥的数学推导,只需要把大模型的推理过程想象成一场漫长的“记忆接力”,在生成第一个字时,模型只需要处理输入;但在生成第二个字时,它需要回顾第一个字;生成第一百个字时,它必须瞬间“回忆”起前九十九个字的所有细节,KV Cache就是这种“回忆”的载体。
为什么KV Cache是显存杀手?
业内专家指出,显存(VRAM)是大模型运行的血液,而KV Cache往往是导致血液枯竭的隐形吸血鬼,要理解这一点,我们需要拆解Transformer架构中注意力机制的工作原理。
注意力机制的“记忆包袱”
在Transformer模型中,Self-Attention(自注意力)机制负责捕捉文本中的长距离依赖关系,为了高效计算,模型会将输入序列转化为Query(查询)、Key(键)和Value(值)三个矩阵。
- Query (Q):代表当前正在生成的Token,它在寻找相关信息。
- Key (K):代表历史Token的特征索引,用于匹配。
- Value (V):代表历史Token的实际语义内容。
当模型生成新Token时,它需要计算当前Q与所有历史K的点积,从而得到注意力权重,再与V相乘得到输出,如果每次都重新计算所有历史Token的K和V,计算量将是天文数字,工程上采用了一种优化策略:缓存(Cache)已经计算好的K和V。
这就是KV Cache的本质,它不是临时变量,而是永久记录,每生成一个新Token,KV Cache的大小就会增加。
显存占用的数学逻辑
KV Cache的显存占用并非线性增长,而是与序列长度、批次大小和模型层数紧密相关,其计算公式大致如下:
$$ text{显存占用} approx text{Batch Size} times text{Seq Len} times text{Num Layers} times text{Hidden Dim} times text{DataType Size} $$
让我们看一个具体场景,假设我们运行一个7B参数量的模型,使用FP16(半精度浮点数)格式,隐藏层维度为4096,模型有32层。
- 单Token占用:每增加一个Token,KV Cache需要存储Key和Value,对于单层,Key和Value各占 $4096 times 2$ 字节(FP16)。
- 全模型占用:乘以32层,每个Token在KV Cache中约占 $32 times 4096 times 2 times 2 approx 524KB$。
- 长对话场景:如果用户进行一场5000 Token的对话,且Batch Size为1,仅KV Cache就占用约 $2.6GB$ 显存,如果Batch Size增加到8,显存占用直接飙升至 $20GB$ 以上。
相比之下,7B模型的权重本身在FP16下仅占用约14GB,这意味着,在长对话场景下,KV Cache的显存开销甚至可能超过模型权重本身。
不同场景下的KV Cache表现差异
在实际应用中,KV Cache对显存的压迫感因场景而异,了解这些差异,有助于优化资源分配。
短文本生成 vs 长文本对话
生成、翻译等短文本任务,序列长度通常在几百Token以内,KV Cache的开销微乎其微,主要显存压力来自模型权重。
在代码生成、长篇小说创作或复杂逻辑推理场景中,序列长度轻松突破万Token,KV Cache呈指数级膨胀,据统计,当序列长度超过8K时,KV Cache的显存占比往往超过50%。
并发请求的压力
在服务器端,为了最大化吞吐量,通常会同时处理多个请求(Batching),KV Cache的占用与Batch Size成正比。
| 场景 | Batch Size | 序列长度 | KV Cache显存估算 (7B模型) | 主要瓶颈 |
|---|---|---|---|---|
| 单用户聊天 | 1 | 1K | ~1GB | 模型权重 |
| 高并发API | 32 | 1K | ~32GB | KV Cache |
| 长文档分析 | 1 | 32K | ~32GB | KV Cache |
| 混合负载 | 16 | 8K | ~128GB | KV Cache |
如上表所示,在高并发或长序列场景下,KV Cache成为显存瓶颈的首要原因。
优化KV Cache显存占用的实操策略
面对显存压力,业内共识认为,单纯增加硬件不是长久之计,软件层面的优化更为关键,以下是几种经过验证的优化路径。
量化KV Cache
模型权重通常使用FP16或INT8,但KV Cache为了保持精度,常使用FP16,将KV Cache量化为INT8或FP8,可以减半其显存占用。
- 操作步骤:在推理引擎(如vLLM或TGI)中启用KV Cache量化选项。
- 效果:显存占用降低约50%,对生成质量的损失通常小于1%,在多数场景下可忽略不计。
使用PagedAttention技术
传统方法中,KV Cache需要连续分配显存块,容易导致内存碎片化,PagedAttention借鉴了操作系统的虚拟内存管理思想,将KV Cache分页存储。
- 核心优势:支持非连续显存分配,消除碎片,允许更灵活的内存复用。
- 适用场景:高并发、动态长度的请求场景,vLLM等主流推理框架已默认支持此技术,显著提升了显存利用率。
滑动窗口注意力(Sliding Window Attention)
对于超长文本,并非所有历史Token都同等重要,滑动窗口机制只保留最近N个Token的KV Cache,丢弃更早的部分。
- 配置示例:设置窗口大小为4096。
- 权衡:虽然显存占用恒定,但可能丢失长距离依赖信息,适用于对上下文窗口长度要求极高,但对全局逻辑一致性要求稍低的场景,如实时聊天机器人。
混合精度与卸载(Offloading)
当显存不足时,可以将部分KV Cache卸载到CPU内存或磁盘,使用时再加载。
- 操作路径:使用支持CPU Offloading的推理框架,配置
--cpu-offload参数。 - 代价:速度显著下降,因为PCIe带宽远低于显存带宽,仅作为应急方案,不推荐用于实时交互场景。
常见问题解答(KV Cache显存优化)
如何判断我的显存是否被KV Cache占满?
可以通过监控显存使用曲线来判断,如果模型权重加载完成后,显存占用稳定,但随着对话进行,显存占用持续线性增长,且无法通过重启服务释放,则极可能是KV Cache积累所致,使用nvidia-smi或专用监控工具观察显存随时间变化的斜率,若斜率恒定,即为KV Cache正常增长;若斜率突然增大,可能是出现了内存泄漏。
KV Cache量化会影响生成质量吗?
在大多数自然语言处理任务中,INT8量化KV Cache对生成质量的影响微乎其微,研究表明,对于指令遵循和常识问答,量化前后的BLEU分数差异通常小于0.5%,在需要极高精度的数学推理或代码生成场景中,建议保留FP16或采用更精细的FP8量化,以避免细微的数值误差累积导致逻辑错误。
为什么有些框架不支持动态Batch Size?
部分传统推理框架要求预分配固定大小的KV Cache缓冲区,以简化内存管理,这种静态分配方式在Batch Size波动时效率低下,要么浪费显存,要么导致OOM(显存溢出),现代框架如vLLM通过PagedAttention实现了动态内存管理,允许Batch Size在运行时灵活调整,从而更高效地利用显存资源,适应多变的业务负载。
大模型推理是一场资源与效率的博弈,KV Cache虽为性能优化而生,却成了显存的负担,通过量化、分页和窗口机制等工程手段,我们能在不牺牲太多精度的前提下,榨干每一MB显存的潜力,让大模型在有限的硬件上跑得更快、更远。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/412100.html

评论列表(1条)
这篇文章说到点子上了,尤其是关于使用那段,我直接截图存了。话说回来有些地方还可以再深入,不过整体已经很顶了,赞一个。