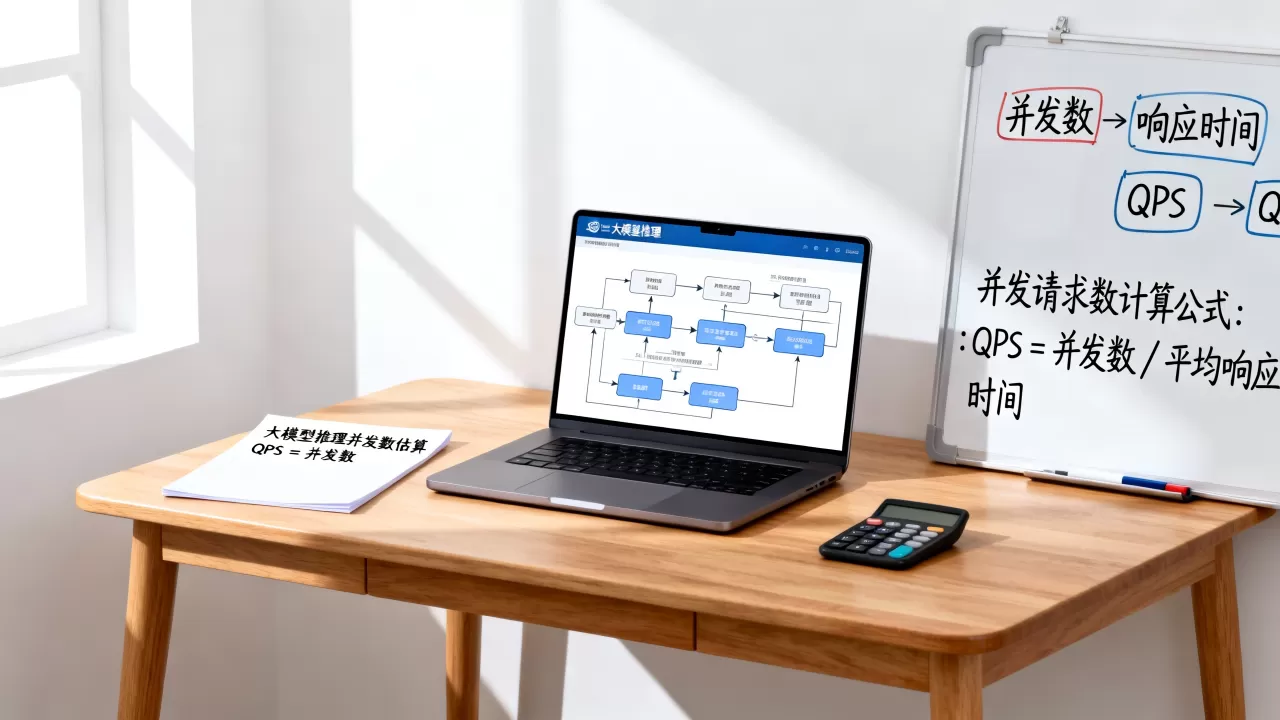
大模型推理并发数如何估算?大模型并发请求数计算公式

大模型推理并发数的估算核心在于平衡显存容量、推理延迟要求与硬件吞吐量,通常建议从单卡最大理论并发数出发,结合业务容忍的P99延迟进行动态下调。

在实际生产环境中,很多团队容易陷入“配置越高越好”的误区,却忽略了并发数并非固定值,而是随请求长度、模型大小和量化精度剧烈波动的变量,估算并发数,本质上是寻找系统资源利用率与用户体验之间的最佳平衡点。
如何测试大模型的并发能力?
加载中
如何测试大模型的并发能力?

大模型推理并发数怎么估算

要准确回答这个问题,我们需要拆解影响并发的三个关键维度:显存瓶颈、计算瓶颈以及KV Cache(键值缓存)的管理。

显存容量决定并发上限

显存是限制大模型推理并发数最直接的物理瓶颈,模型权重、KV Cache以及激活值都会占用显存。

模型权重占用

这是固定开销,以FP16精度为例,70亿参数的模型大约占用14GB显存,如果采用INT8量化,显存占用减半至7GB左右,这意味着,在同等硬件条件下,量化后的模型能支撑更高的并发基数。

KV Cache的动态消耗

KV Cache用于缓存历史对话的键值对,以加速自回归生成过程,它的大小与并发请求数、平均输入长度和平均输出长度成正比。

  • 输入阶段:每个token占用显存与模型维度相关。
  • 输出阶段:随着生成token增加,KV Cache持续膨胀。

业内专家指出,KV Cache往往是导致OOM(显存溢出)的主要原因,尤其是在长文本场景下,估算并发时,必须预留足够的显存给KV Cache,而非仅计算模型权重。
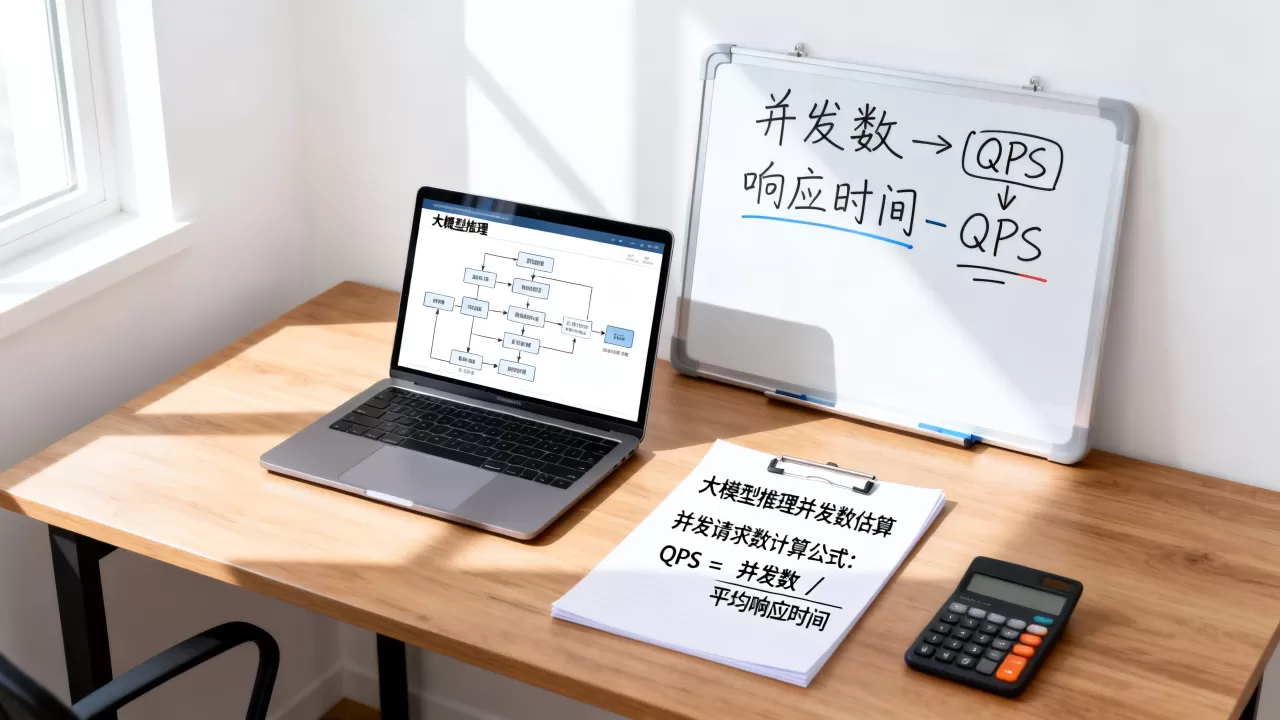
大模型推理并发数如何估算?大模型并发请求数计算公式

计算资源决定吞吐量

即使显存充足,GPU的计算核心(CUDA Cores)也是瓶颈,如果并发过高,GPU利用率达到100%,后续请求排队等待,导致延迟飙升。

吞吐量与延迟的权衡

  • 高并发模式:适合批处理任务,如批量摘要生成,此时追求最大吞吐量,容忍较高延迟。
  • 低延迟模式:适合实时对话,此时需限制并发数,确保每个请求能快速得到响应。

不同场景下的并发估算策略

不同的业务场景对并发数的需求截然不同,不能一概而论。

实时对话场景

在聊天机器人场景中,用户期望首字延迟(TTFT)低于1秒。

  • 估算逻辑:优先保证TTFT。
  • 操作建议:限制最大并发数,确保每个请求都能获得足够的计算资源。
  • 典型数值:单张A100 80G显卡,在INT4量化下,并发数通常控制在10-20之间,具体取决于平均对话长度。

批量处理场景

代码生成等场景中,用户不关心单个请求的即时性,只关心整体完成时间。

  • 估算逻辑:优先保证吞吐量。
  • 操作建议:使用动态批处理(Dynamic Batching),尽可能填满GPU计算单元。
  • 大模型推理并发数如何估算?大模型并发请求数计算公式

    典型数值:并发数可提升至50-100,甚至更高,取决于显存是否溢出。

具体操作步骤与工具推荐

理论估算不够精准,需要通过压测验证,以下是标准化的操作流程。

第一步:基准测试

使用开源工具如vLLM或TGI进行基准测试。

  • 工具选择:vLLM支持PagedAttention技术,能更高效地管理KV Cache,适合高并发场景。
  • 测试命令:使用locust或wrk生成模拟流量。
  • 监控指标:关注GPU利用率、显存占用、请求排队时间。

第二步:调整并发参数

根据测试结果,调整以下参数:

  1. Max Num Sequences:最大序列数,直接限制并发请求数。
  2. Max Num Batched Tokens:最大批次token数,限制单次计算的数据量。
  3. GPU Memory Utilization:GPU显存利用率上限,预留空间给KV Cache。

第三步:动态调优

生产环境流量具有潮汐效应,建议部署自动扩缩容机制。

  • 低峰期:减少实例数量,降低并发上限,节省成本。
  • 高峰期:增加实例数量,提升总并发能力。

常见误区与避坑指南

在估算并发数时,团队常犯以下错误。

只看模型大小,忽略上下文长度

许多开发者认为模型参数越小,并发越高,长上下文会迅速耗尽KV Cache显存,128K上下文的模型,即使参数较小,其并发能力也可能远低于32K上下文的较大模型。
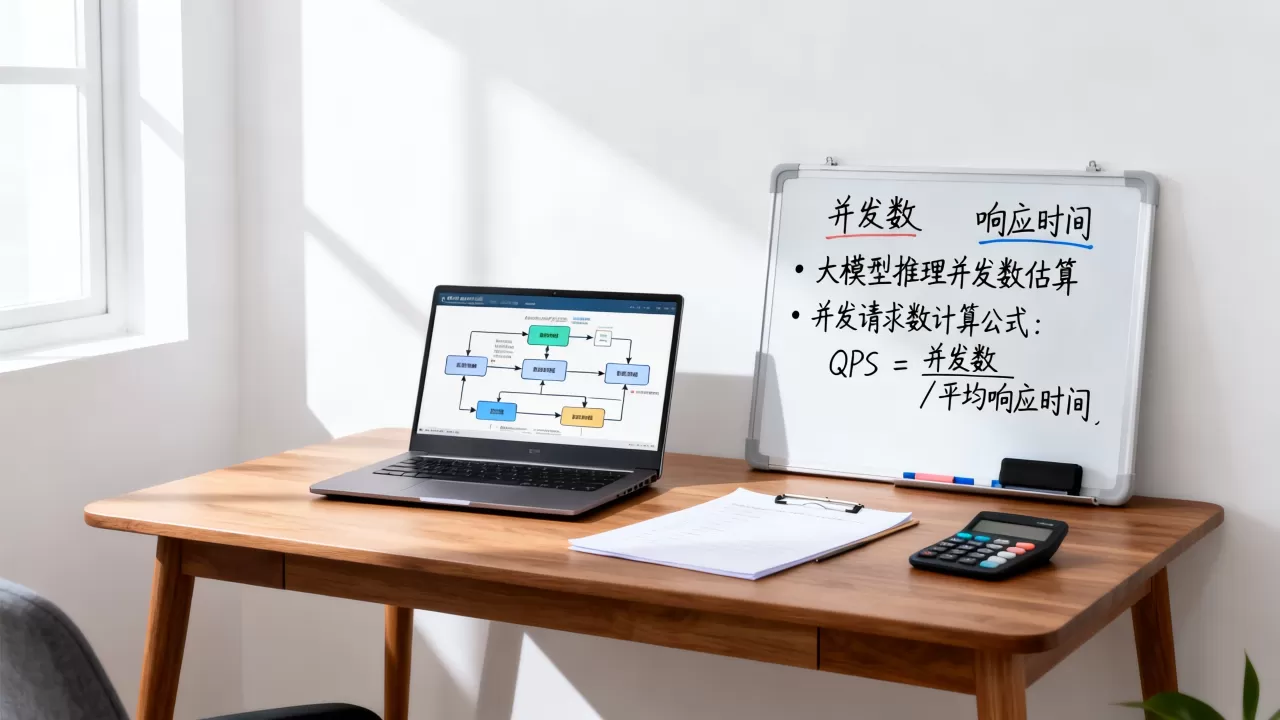
大模型推理并发数如何估算?大模型并发请求数计算公式

忽视网络IO瓶颈

当并发数极高时,网络带宽可能成为瓶颈,确保服务器网卡带宽足够,避免数据在传输过程中阻塞。

静态配置,缺乏弹性

固定并发数无法适应流量波动,建议采用基于指标的自动扩缩容,如根据GPU利用率或请求延迟动态调整实例数。

Q&A:大模型推理并发数怎么估算

如何根据显存大小快速估算最大并发数?

可以使用公式:最大并发数 = (总显存 – 模型权重显存 – 预留显存) / (单请求平均KV Cache显存),单请求平均KV Cache显存 = 平均输入长度 平均输出长度 每token显存开销,每token显存开销取决于模型维度和量化精度。

高并发下出现OOM怎么办?

首先检查KV Cache是否溢出,若溢出,可尝试减少最大并发数,或启用PagedAttention技术优化显存管理,检查模型是否未量化,尝试使用INT8或INT4量化降低权重显存占用,确保没有内存泄漏,定期重启服务。

并发数与延迟的关系是什么?

并发数与延迟呈非线性关系,在低并发时,增加并发数对延迟影响较小,甚至因批处理效率提升而降低平均延迟,但当并发数接近硬件极限时,延迟会急剧上升,出现长尾延迟,需找到延迟可接受范围内的最大并发数,而非无限增加并发。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/410253.html

赞 (0)
gyro2js怎么用?陀螺仪转js代码工具
上一篇 2026年6月22日 08:01
个人app如何搭建服务器?个人app搭建服务器教程
下一篇 2026年6月22日 08:08

相关推荐

  • 大模型LoRA微调梯度消失怎么办?如何解决LoRA梯度消失

    解决大模型LoRA微调中梯度消失的核心在于:优化学习率调度策略、引入残差连接或预归一化技术,并检查数据集质量与初始化参数,通常将学习率降低一个数量级并配合Warmup机制即可显著缓解该问题,在2026年的大模型应用落地场景中,LoRA(Low-Rank Adaptation)因其高效性和低资源消耗,已成为微调主……

    2026年6月17日
    2310
  • 大模型微调用DeepSpeed教程怎么做?DeepSpeed优化大模型训练

    大模型微调用DeepSpeed的核心在于通过分布式并行策略显著降低显存占用并提升训练效率,建议初学者优先选择ZeRO-3优化器状态分片方案以平衡性能与易用性,DeepSpeed微调基础架构解析在2026年的大模型应用落地场景中,显存瓶颈依然是制约中小企业和独立开发者进行模型定制的主要障碍,DeepSpeed作为……

    2026年6月17日
    3610
  • 服务器合租有哪些注意事项,合租服务器多少钱一个月?

    服务器合租本质上是通过共享硬件资源来降低个人使用成本,但成功的关键在于选择信誉良好的合租平台并明确分工与权限,否则可能带来安全与稳定性的隐患,服务器合租怎么操作?从需求分析到环境部署服务器合租的操作流程看似简单,但每个环节都有细节需要把控,从寻找合租伙伴到最终环境上线,走完这几步才算真正完成一次合租,合租的形式……

    2026年7月24日
    700
  • FreeBSD系统安全怎么保障?FreeBSD系统安全加固方法

    FreeBSD系统安全的核心在于其内置的强制访问控制(MAC)框架、严格的默认权限设置以及持续的漏洞补丁管理,通过合理配置这些原生机制,可构建起比多数Linux发行版更坚固的安全防线,很多人误以为开源操作系统天生就“裸奔”,需要层层包裹才敢上生产环境,FreeBSD的设计哲学恰恰相反,它从内核层面就贯彻了“最小……

    2026年7月7日
    14400
  • 如何使用IDEA远程调试跳转?,IDEA远程调试怎么配置

    一句话说清IDEA远程调试与跳转IDEA远程调试的本质是借助JVM的JDWP协议,让本地IDE与远程运行的应用建立通信,从而实现断点暂停、变量查看和源码跳转,要想跳转顺畅,必须保证本地代码与远程部署的代码完全一致,且正确配置Agent库和端口,远程调试到底解决什么问题很多开发者在本地写代码跑得挺好,一旦部署到测……

    2026年8月10日
    800
  • 服务器处理速度慢怎么办?服务器处理速度慢怎么解决

    服务器处理速度的核心在于降低延迟与提升并发吞吐量,关键在于合理选择硬件架构、优化操作系统内核参数以及实施高效的缓存策略,为什么你的服务器总是“慢半拍”想象一下,服务器就像一个在繁忙餐厅工作的厨师,如果厨房(CPU)太小,或者食材(内存)存放混乱,或者传菜口(网络带宽)堵塞,哪怕厨师手艺再好,出餐速度也会大打折扣……

    AI资讯 2026年7月12日
    5900
  • 五大ai大模型哪个最强?国内主流ai大模型排名

    2026年主流AI大模型已形成“通用综合型”与“垂直专业型”双轨并行的格局,用户应根据具体场景在通义千问、文心一言、Kimi、智谱清言及Claude/GPT-4o之间进行精准选择,而非盲目追求单一“最强”模型,随着人工智能技术从“炫技”走向“落地”,大模型之间的差异不再仅仅是参数规模的竞赛,而是体现在对中文语境……

    2026年6月15日
    3300
  • 大模型微调用TRL教程怎么学?大模型微调常用框架有哪些

    大模型微调的核心在于利用TRL库高效对齐人类价值观,通过强化学习让模型从“懂知识”进化为“懂规矩”,显著提升特定场景下的回答质量与安全性,在2026年的AI应用开发浪潮中,通用大模型虽然博学,但在垂直领域往往显得“笨拙”且不可控,微调不再是简单的参数更新,而是一场关于模型行为规范的精密手术,TRL(Transf……

    2026年6月17日
    3000
  • ieee 云计算和大数据库_科学计算大模型

    科学计算大模型依赖高性能云数据库和大数据架构,IEEE标准为跨云数据管理提供了互操作性基础,有效降低训练成本并提升推理效率,科学计算大模型如何重塑云计算与大数据库格局科学计算大模型正在推动传统IT架构的全面升级,这类模型通常需要处理PB级甚至EB级的数据,对存储、计算和网络提出了极高要求,云计算和大数据库不再是……

    2026年8月1日
    500
  • iOS系统FTP服务器怎么设置视频文件夹?, 如何实现音视频通话

    在iOS开发中,同时实现音视频通话和视频文件夹管理并非难事,通过集成WebRTC框架完成实时通信,再结合CocoaHTTPServer或类似库搭建FTP服务器,你可以构建一个功能完整的应用,既支持文件上传下载,又具备高质量通话能力,iOS FTP服务器视频文件夹管理方案为什么要在iOS上搭建FTP服务器?很多场……

    2026年8月3日
    1200

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注