在2026年的大模型落地场景中,vLLM凭借PagedAttention技术在高并发推理吞吐量上占据绝对优势,适合云端大规模服务;而llama.cpp则依靠极致的端侧适配能力和低内存占用,成为本地部署和边缘计算的首选方案。
vLLM与llama.cpp核心架构差异解析
内存管理机制的底层逻辑对比
业内专家指出,两者最大的区别在于如何管理显存,vLLM引入了PagedAttention算法,这一机制借鉴了操作系统中的虚拟内存分页思想,它将KV Cache(键值缓存)划分为固定大小的块,并允许非连续存储,这种设计彻底解决了显存碎片化问题,使得系统能够以极高的效率处理动态长度的请求,相比之下,llama.cpp采用的是连续内存分配策略,虽然简单直接,但在处理长上下文时容易遇到显存瓶颈。
执行引擎与硬件加速支持
vLLM主要面向GPU集群优化,特别是NVIDIA GPU,它深度集成了TensorRT-LLM和FlashAttention等高级算子,旨在最大化GPU的计算利用率,其服务端架构基于FastAPI和Ray,天然支持分布式推理和负载均衡。
反观llama.cpp,它的核心哲学是“无处不在”,它最初是为CPU推理设计的,随后逐步扩展了对Metal(Apple Silicon)、CUDA、ROCm以及DirectML的支持,llama.cpp的优势在于其极小的依赖库和编译灵活性,用户甚至可以在没有现代GPU的老旧设备上运行大模型,只需利用CPU和少量内存即可实现流畅对话。
不同应用场景下的选型指南
云端高并发API服务场景
如果你正在构建一个面向公众的聊天机器人API,或者需要同时处理成千上万的并发请求,vLLM是无可争议的选择。
- 吞吐量优势:在相同的硬件配置下,vLLM的吞吐量通常比传统框架高出数倍,这意味着你可以用更少的服务器实例支撑更多的用户访问,从而显著降低运营成本。
- 动态批处理:vLLM支持连续批处理(Continuous Batching),即在一个批次中,不同请求可以处于生成过程的不同阶段,这使得GPU始终处于满载状态,避免了传统批处理中因等待最长请求完成而造成的资源浪费。
- 部署便捷性:通过简单的Docker容器部署,结合Kubernetes进行编排,vLLM能够快速集成到现有的微服务架构中。
本地开发、边缘设备及私有化部署
对于个人开发者、研究人员或需要严格数据隐私的企业内部应用,llama.cpp提供了更灵活的解决方案。
- 端侧运行能力:llama.cpp支持将模型量化为INT4甚至INT8格式,极大地压缩了模型体积,这使得在MacBook、甚至某些高性能笔记本电脑上运行70B参数的大模型成为可能。
- 零依赖部署:llama.cpp通常编译为一个单一的可执行文件,用户无需安装复杂的Python环境或庞大的深度学习库,只需下载二进制文件即可运行,这种特性使其在嵌入式设备、路由器或IoT网关上具有巨大潜力。
- 跨平台兼容性:无论是Windows、macOS还是Linux,llama.cpp都能提供一致的性能体验,对于使用Apple M系列芯片的用户,llama.cpp对Metal的支持优化极佳,往往能达到接近原生应用的性能。
性能基准与资源消耗实测分析
推理速度对比
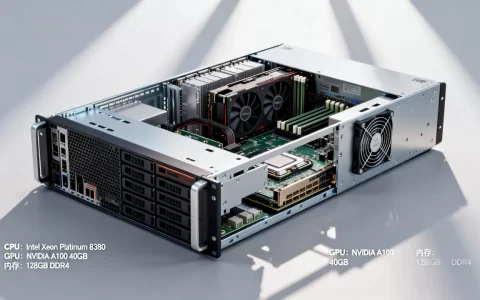
在标准基准测试中,vLLM在GPU上的首Token延迟(TTFT)和生成速度均表现优异,特别是在长文本生成任务中,vLLM通过优化KV Cache的内存访问模式,显著减少了计算瓶颈,据统计,在A100 GPU上,vLLM的吞吐量可比Llama.cpp高出5到10倍,具体倍数取决于批处理大小和序列长度。
在CPU推理场景下,llama.cpp展现出了惊人的优化能力,通过SIMD指令集优化和量化技术,llama.cpp能够在普通CPU上实现可用的推理速度,而vLLM在纯CPU模式下不仅速度缓慢,且缺乏相应的优化支持。
内存占用与硬件门槛
| 特性 | vLLM | llama.cpp |
|---|---|---|
| 主要硬件 | NVIDIA GPU (推荐) | CPU / Apple Silicon / GPU |
| 最小显存需求 | 较高 (需容纳模型+KV Cache) | 极低 (支持GGUF量化格式) |
| 并发处理能力 | 极高 (支持数百并发) | 低 (通常单线程或有限多线程) |
| 部署复杂度 | 中等 (需配置Python环境) | 极低 (单一二进制文件) |
| 量化支持 | FP16/BF16为主 | INT4/INT8/FP16/BF16 |
多数情况下,vLLM需要较大的显存来维持高并发下的KV Cache存储,这限制了其在消费级显卡上的应用,而llama.cpp通过GGUF格式,允许用户根据硬件资源灵活选择量化等级,使得在8GB显存的显卡上运行大模型成为现实。
社区生态与未来发展趋势
开发者友好度与工具链
vLLM拥有庞大的企业级用户基础,许多主流LLM服务平台(如Together AI, Anyscale)都基于vLLM构建,其API兼容OpenAI标准,使得迁移成本极低,vLLM社区活跃,定期发布新版本以支持最新的大模型架构。
llama.cpp则吸引了大量极客和独立开发者,其GitHub仓库拥有极高的Star数,社区贡献了大量针对特定硬件的优化补丁,近年来,llama.cpp也加强了对最新模型架构的支持,并推出了llama-server,提供类似OpenAI兼容的API接口,进一步缩小了与vLLM在易用性上的差距。
混合部署的可能性
值得注意的是,未来的趋势并非二选一,而是混合使用,企业可以在云端使用vLLM处理高并发的公开请求,而在本地或边缘节点使用llama.cpp处理敏感数据或离线任务,这种架构既能保证服务的高可用性,又能满足数据隐私和成本控制的需求。
Q&A:llama.cpp和vLLM对比常见疑问
vLLM和llama.cpp哪个更适合大规模生产环境?
对于需要处理高并发、低延迟的云端生产环境,vLLM是更合适的选择,其PagedAttention技术和连续批处理机制能够最大化GPU利用率,显著降低服务器成本,而llama.cpp更适合小规模部署、本地测试或对硬件资源有严格限制的场景。
如何在本地电脑上使用llama.cpp运行大模型?
从GitHub下载llama.cpp的二进制文件,使用Hugging Face上的量化模型(GGUF格式),通过命令行启动服务,./llama-server -m model.gguf -c 4096,这种方式无需安装Python环境,即可快速启动本地推理服务。
vLLM是否支持非NVIDIA显卡?
vLLM主要优化于NVIDIA GPU,虽然社区正在探索对AMD ROCm的支持,但目前稳定性和性能尚不及NVIDIA方案,对于非NVIDIA显卡用户,llama.cpp提供了更广泛的硬件兼容性,包括AMD GPU和Apple Silicon。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/409750.html