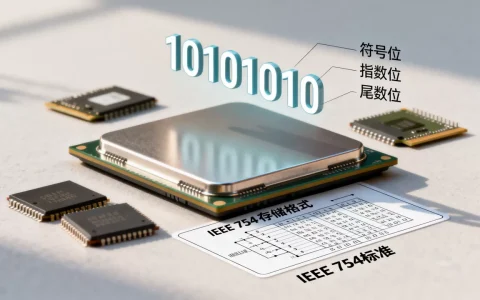
大模型量化本质上是把原本需要高精度存储的模型参数,通过降低精度(如从32位浮点数降至8位整数或更低)来压缩体积并加速推理,从而让普通硬件也能流畅运行大型AI模型。
想象一下,你原本拥有一本用纯金打造的百科全书,内容珍贵但沉重无比,搬运困难且阅读缓慢,大模型量化就是将其转化为铝合金版本,虽然材质变了,但核心知识没丢,而且变得轻便、易读,甚至能塞进你的口袋,这种技术变革直接打破了算力垄断,让“人人可用大模型”从愿景走向现实。


大模型量化的核心逻辑与必要性
为什么我们需要“降级”精度?
在深度学习领域,精度不仅仅是数字的小数点位数,它直接决定了模型对世界认知的细腻程度,传统的Transformer架构通常使用FP32(32位浮点数)甚至FP16(16位半精度)进行训练和推理,这种高精度带来了极高的准确度,但也带来了巨大的资源消耗。
业内专家指出,随着模型参数从几十亿膨胀到千亿级别,内存带宽成为瓶颈,量化技术通过牺牲极少量的精度,换取巨大的效率提升,这并非简单的“阉割”,而是一种精密的数学权衡。
- 存储压缩:将参数从32位压缩至8位,体积直接减少75%。
- 计算加速:整数运算(INT8)在现代CPU和NPU上的速度远快于浮点运算(FP32)。
- 能耗降低:移动端设备运行大模型时,发热量显著下降,续航更持久。
量化前后的直观对比
为了更清晰地理解这一过程,我们可以对比一下不同精度下的模型表现。
| 特性 | FP32 (32位浮点) | INT8 (8位整数) | INT4 (4位整数) |
|---|---|---|---|
|
模型体积 | 极大 | 约为FP32的1/4 | 约为FP32的1/8 |
| 推理速度 | 慢 | 快 | 极快 |
| 内存占用 | 高 | 低 | 极低 |
| 精度损失 | 无 | 微小(lt;1%) | 中等(需精细调优) |
| 适用硬件 | 高端GPU集群 | 主流服务器/手机 | 嵌入式设备/旧手机 |
主流量化技术路线解析
PTQ与QAT的区别在哪里?
量化并非只有一种方法,主要分为训练后量化(PTQ)和量化感知训练(QAT),理解这两者的区别,是选择合适方案的关键。
PTQ(Post-Training Quantization)是在模型训练完成后,直接对权重和激活值进行量化,这种方法速度快,无需重新训练,适合快速部署,它可能无法完全保留模型在极端情况下的表现。
QAT(Quantization-Aware Training)则是在训练过程中模拟量化误差,让模型“学会”在低精度下工作,这种方法效果最好,但成本高昂,需要重新训练或微调。
- PTQ适用场景:快速原型开发、对延迟极度敏感的应用、模型本身已经过充分微调。
- QAT适用场景:对精度要求极高的垂直领域(如医疗诊断)、PTQ导致性能大幅下降的情况。
动态量化与静态量化的选择
除了训练阶段,量化执行方式也分为动态和静态,动态量化在推理时实时计算缩放因子,灵活性高但开销大;静态量化则预先统计数据分布,确定量化参数,推理速度更快,适合生产环境。
据工信部数据,目前主流开源框架如Hugging Face Transformers和LangChain均支持多种量化后端,开发者可根据硬件特性灵活切换。
大模型量化落地实操指南
如何快速实现模型量化?
对于开发者而言,落地量化并不需要从零开始编写底层代码,利用现有的开源工具链,可以大幅降低门槛,以下是基于Python环境的常见操作步骤。
确保安装必要的库,推荐使用bitsandbytes或llama.cpp等成熟库。
# 示例:使用transformers库进行INT8量化加载
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "meta-llama/Llama-2-7b"
tokenizer = AutoTokenizer.from_pretrained(model_name)
# 关键参数:load_in_8bit=True 实现INT8量化
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    load_in_8bit=True,
    device_map="auto"
)
这段代码展示了最基础的INT8量化加载方式,通过device_map="auto",框架会自动将模型层分配到可用的GPU或CPU上,实现无缝切换。
量化后的性能验证与调优
量化完成后,必须进行严格的验证,不能仅凭感觉判断效果,而应使用标准基准测试集(如MMLU、HumanEval)进行对比。
- 准确率测试:对比量化前后模型在相同测试集上的得分,确保下降幅度在可接受范围内(lt;2%)。
- 延迟测试:使用
timeit或专用压测工具,测量生成Token的平均耗时。 - 显存监控:观察GPU显存占用曲线,确认是否达到预期的压缩效果。
若发现精度损失过大,可尝试混合精度量化,即对敏感层保持FP16,对不敏感层使用INT8,这种细粒度控制能平衡性能与效果。
大模型量化的应用场景与未来趋势
边缘设备上的AI革命
量化技术最大的受益者是边缘计算领域,在智能手机、IoT设备甚至汽车芯片上,算力资源有限,散热条件苛刻,通过量化,原本只能在云端运行的大模型,现在可以本地部署。
在移动端运行本地LLM进行隐私敏感的数据处理,无需上传云端,既保护了用户隐私,又降低了网络延迟,这种“端侧智能”正在重塑移动互联网的体验。
成本优化与企业级部署
对于企业而言,量化意味着直接的金钱节省,减少GPU需求,意味着降低硬件采购成本和电力消耗,据统计,采用量化技术后,部分企业的AI推理成本可降低50%以上。
生成、代码辅助等高频场景中,低延迟和高并发是核心诉求,量化模型能够以更低的价格提供同等甚至更好的服务,提升ROI(投资回报率)。
常见疑问解答
大模型量化到底是什么意思,会影响回答质量吗?
量化是通过降低数值精度来压缩模型体积的技术,多数情况下,INT8量化对回答质量的影响微乎其微,仅在极少数复杂逻辑推理中可能出现细微偏差,对于日常对话、创意写作和代码生成,用户几乎无法察觉差异。
量化模型在本地电脑能跑起来吗?
可以,通过GGUF格式和llama.cpp等工具,即使只有8GB内存的普通笔记本,也能流畅运行7B参数量的量化模型,关键在于选择合适的量化等级(如Q4_K_M),在速度与精度间取得平衡。
量化模型的价格会比原始模型便宜吗?
开源模型本身免费,但推理成本大幅降低,对于商业API服务,量化模型通常提供更低价的计费档位,因为服务器资源消耗更少,用户可以用更少的预算获得更快的响应速度。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/409738.html