

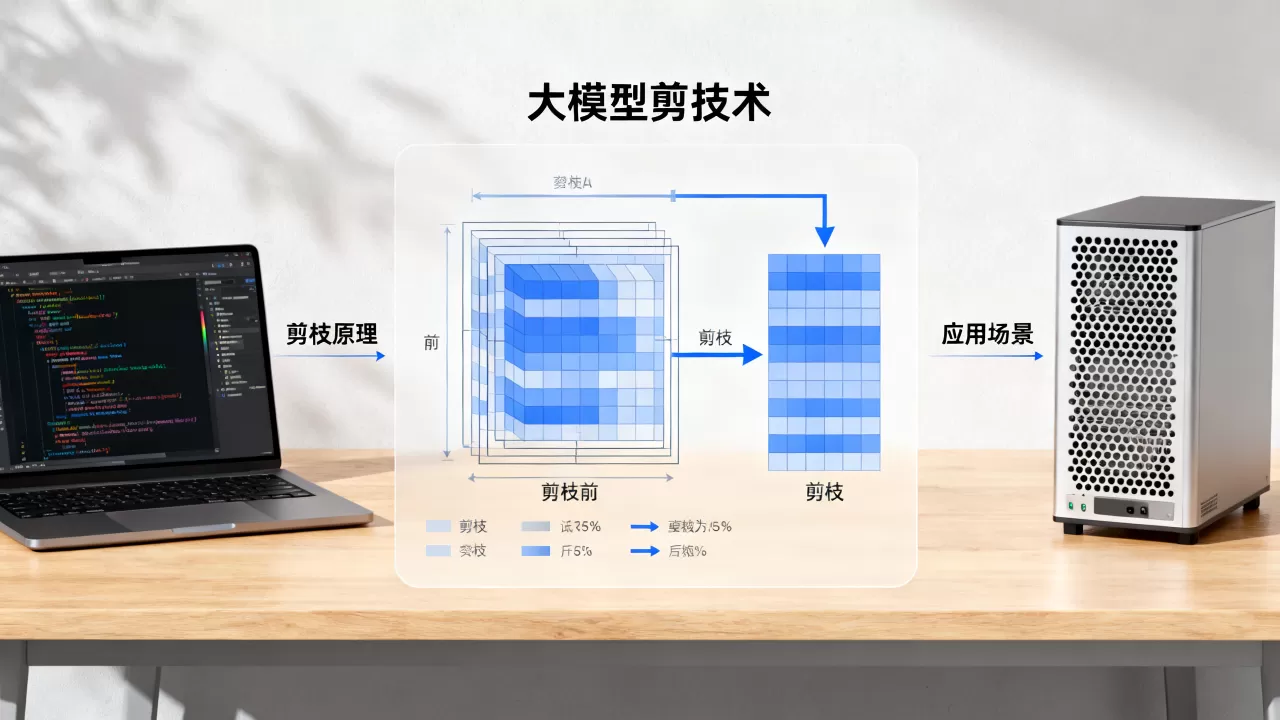
大模型剪枝的核心原理是通过识别并移除神经网络中冗余或贡献微小的参数(权重),在保持模型性能基本不变的前提下,显著降低模型的存储体积和计算延迟,从而实现轻量化部署。
想象一下,一个拥有千亿参数的超大语言模型就像是一个知识渊博但臃肿的学者,他脑海中存储了海量的信息,其中大部分是精华,但也混杂着大量重复、模糊甚至无用的记忆碎片,剪枝技术就是那位严谨的编辑,他仔细审视学者的每一个神经元连接,果断地剪掉那些对最终答案影响微乎其微的“无用连接”,让这位学者变得更轻盈、反应更快,同时依然能准确回答问题。
大模型剪枝Pruning是什么原理
要理解剪枝,首先要明白神经网络是如何工作的,在深度学习中,模型由成千上万个节点(神经元)和连接它们的边(权重)组成,每个连接都有一个数值权重,代表信息传递的重要性,有些权重极大,意味着该路径至关重要;有些权重极小,甚至接近于零,意味着这条路径几乎不传递有效信息。
基于权重大小的稀疏化策略
这是最直观且应用最广泛的剪枝方法,业内专家指出,神经网络中存在大量的“冗余连接”,这些连接对输出结果的贡献微乎其微。
结构化剪枝与非结构化剪枝的区别
剪枝主要分为两个流派,它们在实操路径上有着截然不同的效果:
- 非结构化剪枝(Unstructured Pruning):这是“微观手术”,它直接针对单个权重进行修剪,如果某个权重的绝对值小于设定阈值(例如0.01),就直接将其置为零,这种方法能实现极高的稀疏度,比如将90%以上的参数置零,由于它破坏了矩阵的连续结构,普通CPU或GPU难以直接加速,必须依赖专门的稀疏计算库或硬件支持,否则反而可能因为稀疏性带来的索引开销而变慢。
- 结构化剪枝(Structured Pruning):这是“宏观切除”
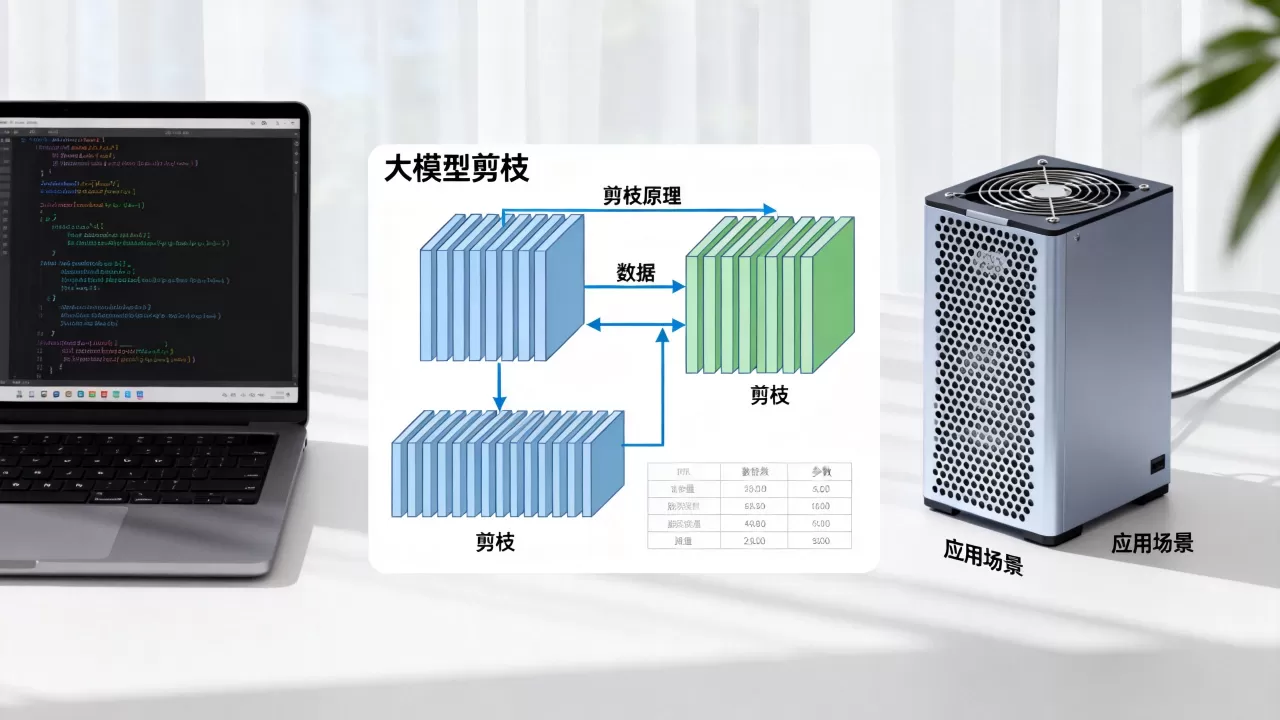
,它按照通道、层或滤波器为单位进行整体删除,如果某个卷积层的某个滤波器对特征提取贡献很小,就整个删除该滤波器,虽然剪枝率通常低于非结构化剪枝,但它生成的模型结构紧凑,可以直接在标准硬件上运行,无需特殊优化,因此在工业界落地更为普遍。
动态剪枝与静态剪枝的选择
在考虑大模型剪枝Pruning技术选型时,开发者往往面临静态与动态的抉择。
- 静态剪枝:在训练前或训练后一次性完成,优点是流程简单,易于集成到现有的MLOps流水线中,缺点是模型一旦剪枝,结构固定,无法适应不同输入数据的复杂度。
- 动态剪枝:根据输入样本的不同,动态决定哪些路径需要激活,哪些可以跳过,这类似于人类阅读时,对简单句子快速扫过,对复杂段落仔细研读,动态剪枝能带来更高的推理效率,但实现复杂度极高,需要修改模型架构以支持条件执行逻辑。
剪枝后的性能恢复与微调策略
剪枝并非一蹴而就,直接剪掉参数往往会导致模型性能断崖式下跌,如何恢复性能是技术落地的关键。
重新训练(Fine-tuning)的重要性
剪枝后,模型处于“营养不良”状态,必须通过重新训练来恢复能力,这个过程通常被称为“剪枝-微调”循环。
- 初始化恢复:使用预训练模型的权重作为起点,保留未被剪枝的权重,对剩余权重进行随机初始化或插值初始化。
- 学习率调整:重新训练时,通常需要使用比初始训练更低的学习率,以避免破坏已经学到的良好表征。
- 数据选择:使用高质量、高多样性的数据进行微调,据统计,使用精心筛选的少量数据往往比使用海量低质数据效果更好。
知识蒸馏的协同效应
在剪枝过程中,引入知识蒸馏(Knowledge Distillation)能显著提升效果,可以将原始的庞大模型作为“教师”,剪枝后的轻量模型作为“学生”,学生模型不仅学习真实标签,还模仿教师模型的输出分布(软标签),这种协同作用能帮助剪枝模型更好地保留原始模型的知识分布,特别是在处理长尾分布数据时表现优异。
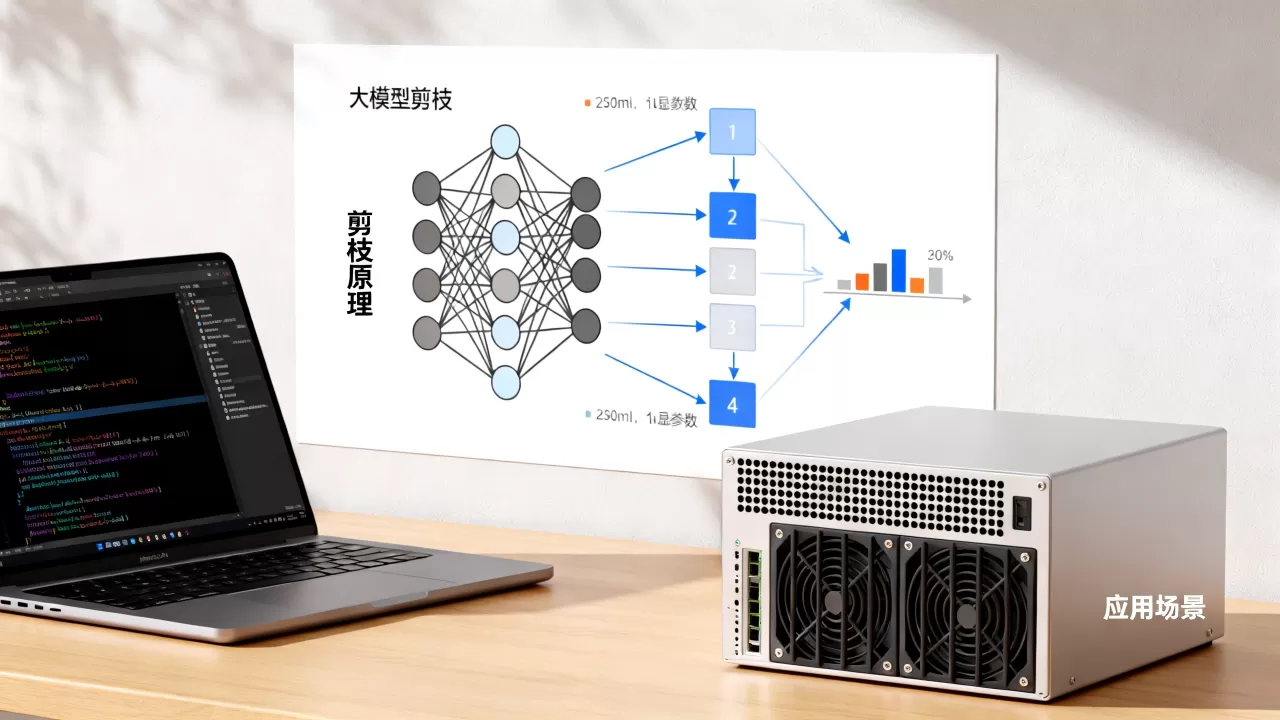
大模型剪枝Pruning在实际场景中的应用价值
为什么企业要花大力气做剪枝?答案在于成本与效率的平衡。
边缘设备部署的现实需求
对于手机、IoT设备等边缘端场景,内存和算力极其有限,一个未经剪枝的百亿参数模型可能无法在普通智能手机上运行,或者运行速度极慢,导致用户体验糟糕,通过剪枝,模型体积可缩小至原来的1/3甚至1/10,推理速度提升数倍,使得大模型真正走进千家万户成为可能。
云端推理成本的显著降低
对于云服务提供商而言,推理成本是巨大的支出,模型越小,单次推理所需的GPU显存和计算资源就越少,这意味着在相同的硬件资源下,可以服务更多的用户请求,或者在维持相同服务量的情况下,大幅降低服务器集群的规模,据行业共识认为,合理的剪枝策略可使推理成本降低30%以上,这对于大规模商业化应用至关重要。
常见误区与实操建议
在实施大模型剪枝时,许多开发者容易陷入一些误区。
剪枝率越高越好
这是一个常见的错误认知,虽然高剪枝率能带来更小的模型,但往往伴随着性能的急剧下降,业内专家指出,存在一个“精度-压缩率”的帕累托前沿,盲目追求高剪枝率会导致模型丧失泛化能力,变成“残废”模型,建议从10%-20%的低剪枝率开始尝试,逐步增加,并密切监控验证集上的性能指标。
忽视硬件特性
不同的硬件对稀疏矩阵的支持程度不同,如果目标部署平台是最新的NVIDIA GPU,非结构化剪枝可能通过Tensor Cores获得加速;但如果目标是老旧的CPU或特定嵌入式芯片,结构化剪枝可能是更稳妥的选择,在决定剪枝策略前,务必明确目标硬件的指令集和内存带宽特性。
实操步骤建议
- 基准测试:记录原始模型的推理延迟、吞吐量及精度指标。
- 选择剪枝算法:根据硬件限制选择结构化或非结构化剪枝。
- 执行剪枝:使用工具如PyTorch的Pruning模块或Hugging Face的Transformers库中的相关功能。
- 微调恢复:使用小规模高质量数据进行微调,观察性能恢复情况。
- 量化配合:剪枝后通常配合INT8或FP16量化,进一步压缩模型并加速推理。
大模型剪枝Pruning技术问答
大模型剪枝Pruning会影响模型的创造力吗?
剪枝主要影响模型的参数冗余度,对核心逻辑能力影响较小,对于创意生成任务,只要剪枝率控制在合理范围(如30%以内),并通过充分微调,模型仍能保持较高的创造性,但若剪枝过度,模型可能会变得保守,倾向于输出常见、安全的回答,而非新颖的观点。
剪枝和量化有什么区别?可以一起用吗?
剪枝是移除参数,量化是降低参数精度(如从FP32降至INT8),两者互补,剪枝减少参数量,量化减少每个参数的存储和计算开销,业内普遍认为,剪枝加量化是目前模型压缩的黄金组合,能实现10倍以上的压缩比,同时保持较好的性能。
开源社区有哪些主流的大模型剪枝工具?
目前主流工具包括Hugging Face Transformers库内置的剪枝支持,PyTorch官方提供的Pruning模块,以及专门针对LLM优化的框架如LLM.int8()和Bitsandbytes,这些工具提供了从非结构化到结构化剪枝的完整流水线,降低了开发者的实施门槛。
大模型剪枝并非简单的“删减”,而是一场精密的“瘦身手术”,它通过去除冗余、保留精华,让庞大的AI模型变得轻盈高效,从而在边缘设备和云端推理中发挥最大价值,掌握这一技术,是通往高效AI应用的关键一步。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/409526.html

评论列表(1条)
笑死,这模型跟臃肿学者似的,难怪我刷它都饿得肚子咕咕叫!