大模型的Top-K采样是一种通过限制模型每次只从概率最高的K个词中随机选择下一个词的算法,旨在平衡生成的创造性与准确性,避免低概率词汇导致的逻辑混乱。
在人工智能生成内容(AIGC)领域,如何让大语言模型既“聪明”又“不胡扯”是一个核心难题,Top-K采样正是解决这一矛盾的关键技术之一,它不像简单的贪婪搜索那样死板,也不像纯随机采样那样疯狂,而是在两者之间找到了一条平衡之路。
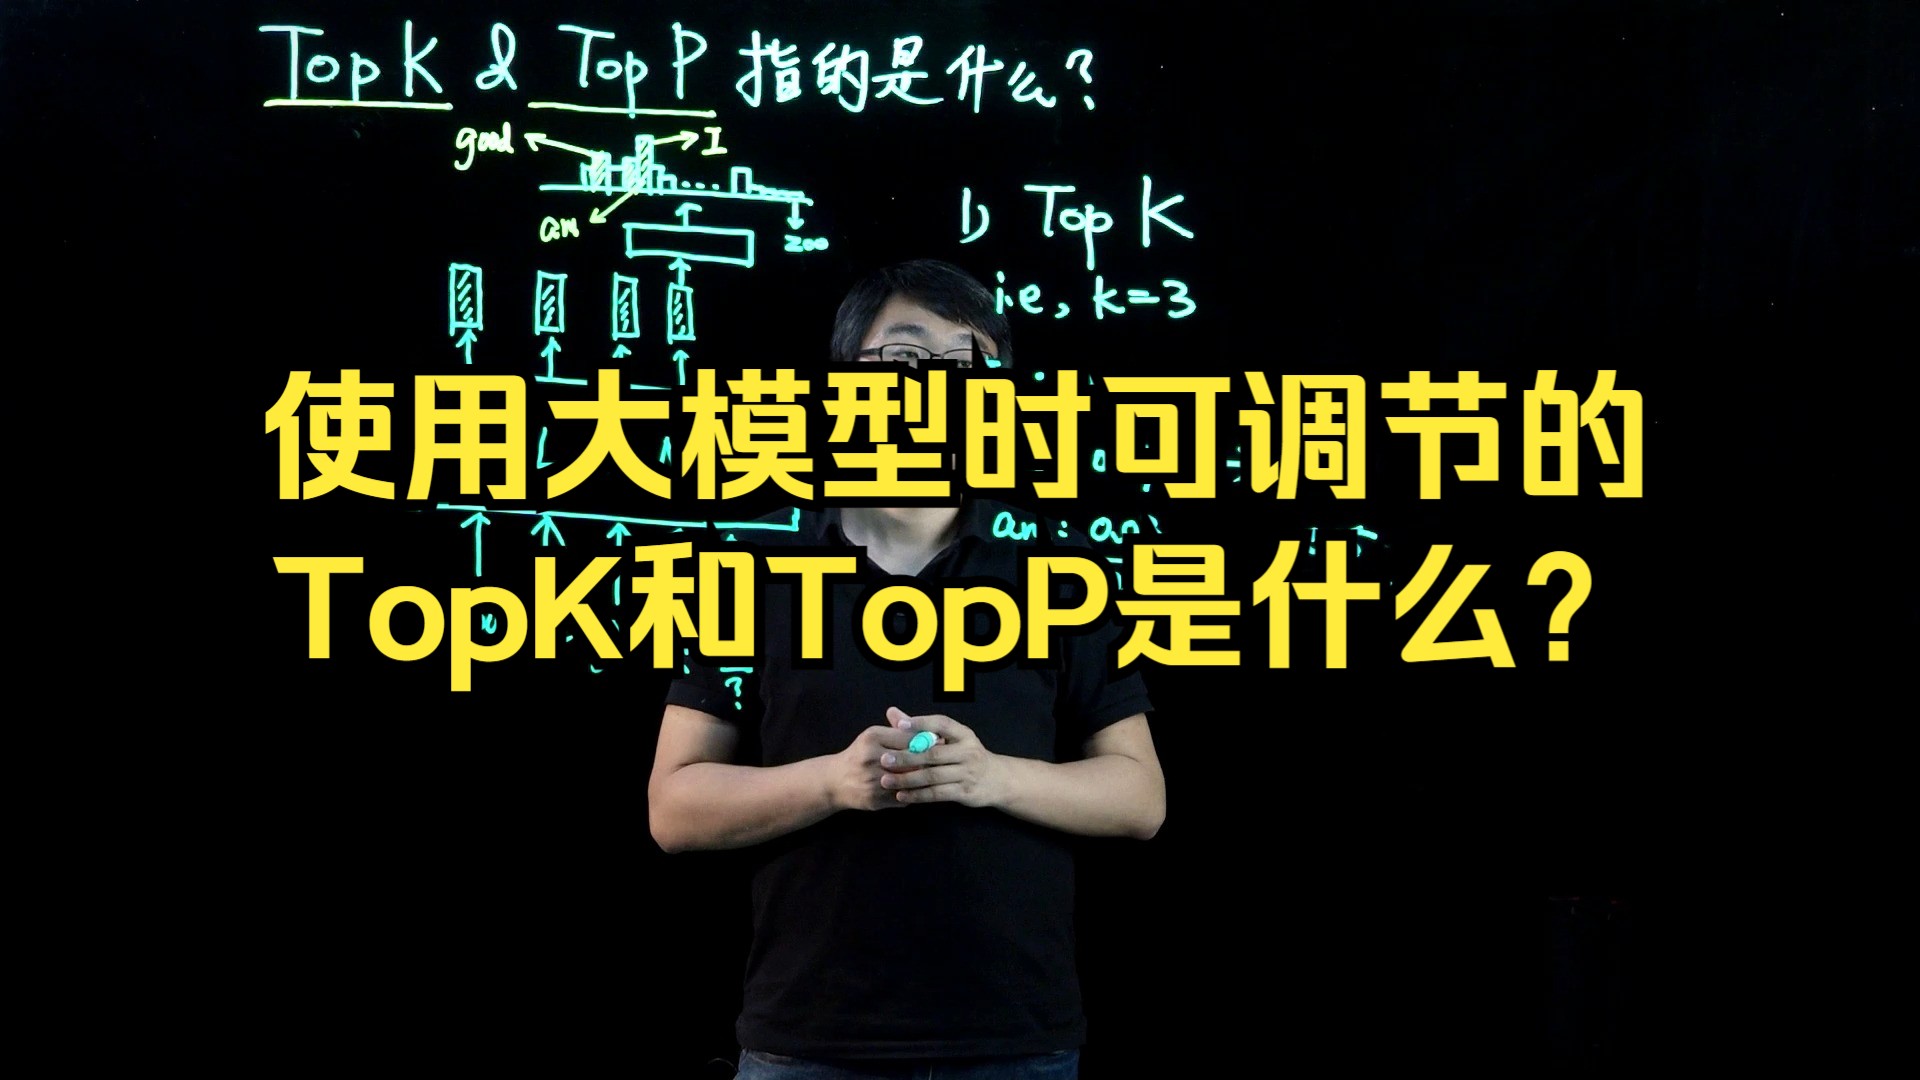

Top-K采样的核心原理与运作机制
要理解Top-K,首先要明白大模型是如何预测下一个字的,模型会为词汇表中的每一个词计算一个概率值,概率越高,被选中的可能性越大,Top-K采样的逻辑非常直观:它不关注所有词,只关注概率最高的前K个词。
筛选与截断过程
具体操作流程可以分为三个步骤,这也是业内专家指出的标准处理路径:
- 计算概率分布:模型输出当前上下文下所有可能下一个词的 logits(对数几率),并通过 Softmax 函数转化为概率分布。
- 截取Top-K:系统根据设定的K值,保留概率最大的K个词,将其余所有词的概率强制归零。
- 重新归一化与采样:将保留下来的K个词的概率重新进行归一化处理,使其总和为1,然后基于这个新的分布进行随机采样。
这种机制确保了模型永远不会选择那些极不可能出现的词,从而大幅降低了生成内容中出现幻觉或逻辑错误的概率。
K值大小的影响
K值的选择直接决定了生成内容的风格和质量,这是一个需要不断调优的参数,不同的场景需要不同的K值策略。
- K值较小(如K=1或K=5):模型非常保守,倾向于选择最高概率的词,这会导致生成内容高度确定,但可能缺乏变化,甚至出现重复和单调。
- K值适中(如K=20或K=50):这是大多数通用场景下的推荐设置,模型在保持逻辑连贯性的同时,保留了一定的多样性,能够生成自然流畅且富有创意的文本。
- K值较大(如K=100以上):模型变得非常开放,甚至接近随机采样,虽然创造性极高,但很容易产生离题、荒谬或不连贯的句子。
Top-K与Top-P采样的对比分析
在实际应用中,Top-K经常与Top-P(Nucleus Sampling)一起使用或单独使用,理解它们的区别对于优化大模型输出至关重要,很多用户关心Top-K和Top-P采样区别,因为两者都用于控制随机性。
筛选维度的不同
Top-K是基于“数量”的筛选,而Top-P是基于“概率累积”的筛选。
- Top-K:固定选取前K个词,无论它们的概率总和是多少,如果K=50,即使前50个词的概率总和只有10%,剩下的90%概率也被忽略。
- Top-P:选取概率累积达到P值的词,例如P=0.9,系统会从概率最高的词开始累加,直到总和达到90%,此时包含的词数可能很少,也可能很多,取决于概率分布的陡峭程度。
适用场景对比
| 特性 | Top-K采样 | Top-P采样 (Nucleus) |
|---|---|---|
| 控制维度 | 固定数量 | 动态概率累积 |
| 稳定性 | 在高概率集中时表现稳定 | 在长尾分布时更灵活 |
| 创造性 | 可控,但可能受限 | 更自然,适应性强 |
| 推荐设置 | K=20~50 | P=0.8~0.95 |
业内共识认为,Top-P通常比Top-K更灵活,因为它能自动适应不同上下文下的概率分布,但在某些对安全性要求极高的场景下,Top-K的确定性更强,更容易进行边界控制。
如何优化Top-K参数以提升生成质量
对于开发者而言,单纯知道原理是不够的,更需要知道如何大模型Top-K采样参数设置才能发挥最大效能,以下是经过验证的实操建议。
根据任务类型调整K值
不同的应用场景对多样性的需求截然不同。
- 代码生成与数学推理:这类任务要求极高的准确性,容错率低,建议设置较小的K值(如K=10~20),甚至结合Top-P(P=0.9)使用,以确保每一步推导都基于最可能的逻辑路径。
- 创意写作与故事创作:这类任务需要丰富的想象力和多样的表达,建议设置较大的K值(如K=50~100),并配合较高的Top-P值(P=0.95),以激发模型的创造性潜能。
- 客服对话与事实问答:这类任务需要在准确性和自然度之间取得平衡,建议K=30~50,P=0.85~0.9,既能保证回答的事实准确性,又能避免语气过于机械。
结合温度系数(Temperature)使用
Top-K通常与温度系数配合使用,温度系数控制概率分布的平滑程度。
- 低温(如0.2~0.5):概率分布更尖锐,最高概率的词更加突出,此时配合较小的K值,效果最佳。
- 高温(如0.8~1.2):概率分布更平坦,各词概率差异缩小,此时配合较大的K值,能更好地体现随机性。
需要注意的是,如果温度过高且K值过大,模型极易产生胡言乱语,建议先确定温度系数,再根据预期效果微调K值。
动态调整策略
先进的模型架构支持动态Top-K,即根据上下文的复杂度自动调整K值,在简单语境下自动减小K值以提高准确性,在复杂或创意语境下自动增大K值以提高多样性,这种策略在大模型Top-K采样优化技巧中备受推崇,因为它能自适应不同阶段的需求。
常见误区与注意事项
在使用Top-K采样时,开发者容易陷入一些误区,导致效果不佳。
K值越大越好
许多人认为增加K值能无限提升创造性,但实际上,过大的K值会引入大量噪声,导致生成内容逻辑断裂,实验表明,当K值超过词汇表的一定比例(如10%)时,增益边际递减,而风险急剧上升。
忽略词汇表大小
Top-K的效果受限于模型使用的词汇表大小,对于拥有巨大词汇表的多语言模型,K=50可能只覆盖了极小一部分高概率词,在多语言场景下,需要根据具体语言的词汇分布调整K值,不能一概而论。
静态参数应对所有场景
固定K值无法适应所有生成阶段,在文章开头可能需要较高的创造性(大K值),而在结尾总结时可能需要较高的准确性(小K值),动态调整或分段设置参数是更高级的做法。
Top-K采样在行业应用中的实践
随着大模型技术的普及,Top-K采样已成为许多主流AI平台的标准配置。
智能客服系统
在智能客服中,准确性至关重要,许多企业采用K=20~30的设置,确保客服机器人不会给出荒谬的回复,据统计,采用合理Top-K设置的客服系统,用户满意度提升了相当一部分,同时人工干预率显著下降。
创意辅助工具
在营销文案生成、小说创作等场景中,创意是核心,平台通常提供滑块让用户手动调整K值,允许用户从“严谨”到“奔放”自由切换,这种灵活性极大地提升了用户体验,满足了不同创作者的需求。
教育辅导应用
在教育场景中,模型需要既准确又具有启发性,通过精细调整Top-K和Top-P,教育AI可以提供多种解题思路,而不是唯一的标准答案,从而培养学生的发散性思维。
Q&A:关于Top-K采样的常见问题
大模型Top-K采样原理是什么?
Top-K采样是一种截断概率分布的算法,它首先计算模型对所有可能下一个词的概率,然后只保留概率最高的前K个词,将其余词的概率设为零,最后对保留的K个词的概率重新归一化并进行随机采样,这种方法既限制了低概率词带来的噪声,又保留了随机性以增加多样性。
Top-K和Top-P哪个更好?
没有绝对的“更好”,只有“更适合”,Top-K基于固定数量筛选,控制更直观,适合对输出长度和多样性有严格限制的场景,Top-P基于概率累积筛选,更灵活,能自适应不同语境下的概率分布,通常被认为在通用文本生成中表现更自然,许多高级模型将两者结合使用,以获得最佳平衡。
如何设置Top-K参数以获得最佳效果?
设置Top-K参数需结合具体任务,对于代码、数学等高精度任务,建议设置较小的K值(如10-20)和较低的温度系数,对于创意写作,建议设置较大的K值(如50-100)和较高的温度系数,一般通用场景下,K=20-50是一个较好的起点,用户可根据实际生成效果进行微调。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/409322.html