大模型的Perplexity(困惑度)是衡量语言模型预测下一个词准确率的指标,数值越低代表模型对语言的掌握越精准,生成的内容逻辑越连贯、意外性越小。
理解这个概念,不需要你是数学博士,只需要把它想象成“猜词游戏”的得分机制,当你读一段话时,如果每个词都顺理成章,困惑度就低;如果突然冒出个让你愣住的词,困惑度就飙升,对于2026年的内容创作者和开发者来说,这不仅是技术指标,更是判断AI是否“懂你”的核心标尺。
Perplexity到底在测什么?从猜词游戏说起
很多人听到“困惑度”这个词,第一反应是复杂的概率论,它的本质非常简单:它衡量的是模型对未知事物的“惊讶程度”。
想象你在玩一个填空游戏,句子是“今天天气真____”,如果模型预测“好”的概率极高,那么当“好”字真的出现时,模型并不惊讶,困惑度很低,但如果模型预测“好”的概率只有1%,结果却出来了个“糟糕”,模型就会非常“困惑”,困惑度瞬间拉高。
业内专家指出,Perplexity本质上是交叉熵(Cross-Entropy)的指数形式,在自然语言处理领域,它被广泛用于评估语言模型的质量。
为什么低困惑度等于高质量?
低困惑度意味着模型内部的知识图谱非常清晰,它知道在某种语境下,哪些词出现的概率大,哪些小。
- 逻辑连贯性:低困惑度的模型生成的文章,前后呼应,不会出现前言不搭后语的情况。
- 用词精准度:它能区分“即使”和“既然”这种细微的语法差别,而不是随意堆砌同义词。
- 预测稳定性:在相同提示词下,低困惑度模型的输出波动较小,更适合用于需要稳定性的商业场景。
高困惑度一定不好吗?
这里有个误区,在创意写作或头脑风暴场景中,较高的困惑度反而可能带来惊喜,如果模型太“确定”,它可能会给出最平庸、最套路的答案,适当引入随机性(Temperature参数调整),可以让模型跳出常规概率分布,产生更具创造性的内容,但如果是用于代码生成、法律条文或医疗建议,低困惑度则是硬性要求。
如何计算与解读Perplexity数值?
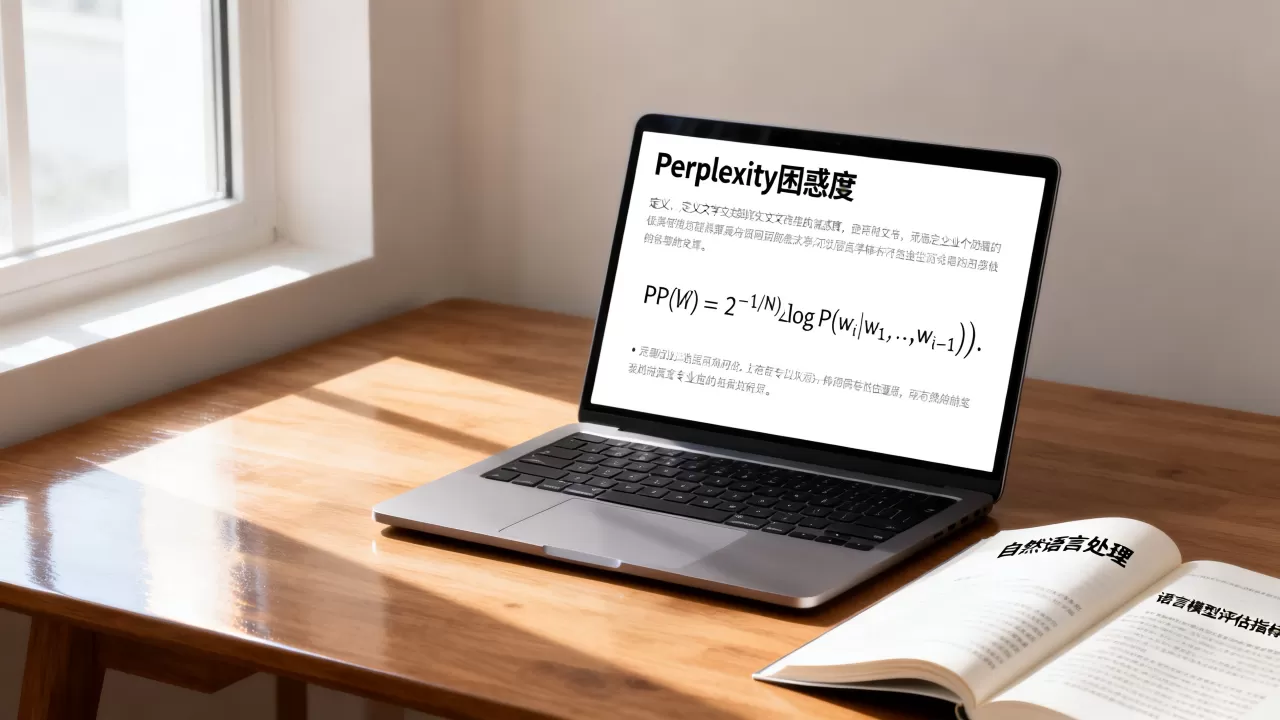
要真正用好这个指标,你得知道它是怎么算出来的,以及拿到一个数字后该怎么看。
计算公式背后的直觉
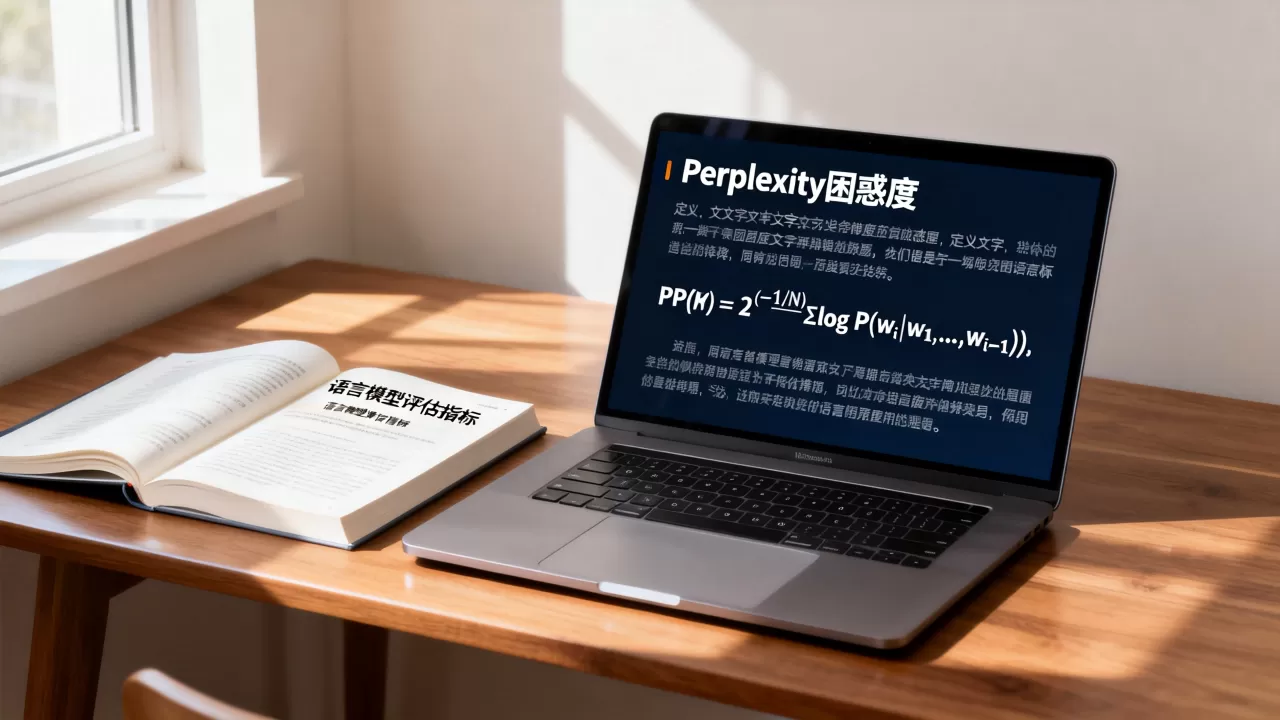
Perplexity的计算公式涉及概率乘积的开方,就是看模型对测试集中每个词的概率预测的几何平均值的倒数。
- 如果模型对每个词都给了100%的确定性,困惑度就是1,这是理论上的完美状态,现实中不存在。
- 如果模型完全随机猜测,困惑度将等于词汇表的大小,比如一个模型有10万个词,它完全瞎猜,困惑度就是10万。
不同领域的基准线对比
没有绝对的“好”或“坏”,只有相对的比较,不同任务、不同大小的模型,其困惑度基准线完全不同。
| 模型类型 | 典型应用场景 | 合理Perplexity范围参考 | 解读 |
|---|---|---|---|
| 小型本地模型 | 个人笔记整理 | 20 – 50 | 对日常用语理解尚可,专业术语易出错 |
| 中型云端模型 | 通用文案创作 | 10 – 20 | 平衡了速度与质量,适合大多数场景 |
| 大型旗舰模型 | 复杂逻辑推理 | 5 – 10 | 对长上下文和复杂指令有极强掌控力 |
| 专用领域模型 | 医疗/法律问答 | < 5 | 在特定垂直领域达到极高精准度 |
注:以上数据为行业共识中的相对范围,具体数值因测试集和预处理方式而异。
解读时的常见陷阱
千万不要直接拿两个不同架构模型的Perplexity做绝对数值对比,一个基于Transformer架构的模型和一个基于RNN架构的模型,即使困惑度相同,实际表现可能天差地别。
测试集的质量
至关重要,如果测试集全是简单句,困惑度自然低;如果包含大量生僻专业术语,困惑度必然高,评估时必须确保测试集与目标应用场景高度匹配。
2026年实战:如何优化你的模型困惑度?
对于开发者或高级用户来说,降低困惑度不仅仅是调参,更是一套系统工程,以下是经过验证的实操路径。
数据清洗是第一步
垃圾进,垃圾出,模型学到的困惑度,很大程度上取决于训练数据的质量。
- 去重:移除训练数据中的重复样本,防止模型过拟合某些特定句式。
- 规范化:统一标点符号、大小写和特殊字符,将全角逗号统一为半角,能显著降低模型在标点预测上的困惑度。
- 领域适配:如果你的应用是金融方向,必须引入高质量的金融语料进行微调(Fine-tuning),而不是直接依赖通用大模型。
提示词工程(Prompt Engineering)的影响
很多人不知道,用户的提示词质量直接影响推理阶段的困惑度。
- 提供上下文:模糊的指令会让模型在多个可能性中徘徊,导致概率分布平坦,困惑度升高,提供详细的背景信息,能压缩模型的不确定性空间。
- 结构化输出:要求模型以JSON或Markdown格式输出,相当于给模型加了“约束”,强制其遵循特定模式,从而降低意外输出的概率。
使用Perplexity监控实时质量
在生产环境中,你可以将Perplexity作为监控指标。
- 设置阈值告警:当某次生成的文本困惑度超过设定阈值(如15),系统自动标记该条记录,提示人工复核。
- A/B测试:在更新模型版本或提示词模板时,对比两组数据的平均困惑度,如果新模板的困惑度显著降低,说明其逻辑一致性更好。
Perplexity与其他评估指标的关系
Perplexity不是万能的,它需要与其他指标配合使用,才能全面评估模型能力。
与BLEU、ROUGE的区别
BLEU和ROUGE主要关注生成文本与参考文本的字面重合度,而Perplexity关注的是模型内部的概率分布合理性。
- 一个模型可能生成与参考答案完全不同但逻辑完美、语法正确的句子,Perplexity很低,但BLEU得分可能不高。
- 反之,一个模型可能机械地复制参考答案,Perplexity可能较高(因为它没表现出“理解”),但BLEU得分很高。
Perplexity更适合评估模型的“语言能力”和“逻辑连贯性”,而BLEU/ROUGE更适合评估“事实准确性”或“翻译质量”。
人类评估的不可替代性
尽管Perplexity是客观指标,但多数情况下,人类评估依然是最终裁判,有些句子在统计上概率极低(困惑度高),但在文学创作中却是神来之笔,反之,有些句子概率极高(困惑度低),却可能显得枯燥乏味。
最佳实践是将Perplexity作为初筛工具,结合人工抽检,形成闭环评估体系。
FAQ:关于Perplexity的常见疑问
Perplexity越低,模型就越聪明吗?
不一定,低困惑度代表模型对语言统计规律的掌握越好,预测下一个词越准确,但这不等于模型具备真正的“智能”或“推理能力”,一个模型可以完美预测语法正确的废话,其困惑度依然很低,智能还涉及逻辑推理、常识判断等更深层的能力,这些需要结合其他测试集(如MMLU、GSM8K)来综合评估。
我可以用Perplexity来比较不同大模型的价格性价比吗?
不能直接比较,Perplexity是技术指标,价格是商业指标,虽然低困惑度通常意味着更好的效果,但不同厂商的定价策略、API调用成本、并发限制差异巨大,你需要结合具体业务场景,计算“每单位困惑度降低带来的业务价值”与“成本”的比例,才能得出性价比结论,对于法律问答,低困惑度带来的合规风险降低可能远超API成本的增加。
本地部署的小模型如何降低Perplexity?
对于本地部署模型,降低困惑度的核心在于量化后的微调和上下文窗口优化,确保使用高质量的领域数据进行LoRA微调,这比单纯增加量化精度更有效,优化Prompt模板,减少歧义,利用RAG(检索增强生成)技术,将外部知识库作为上下文输入,可以显著降低模型在事实性问题上的困惑度,因为它不再需要凭空记忆所有知识,而是基于提供的可靠信息进行预测。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/406612.html