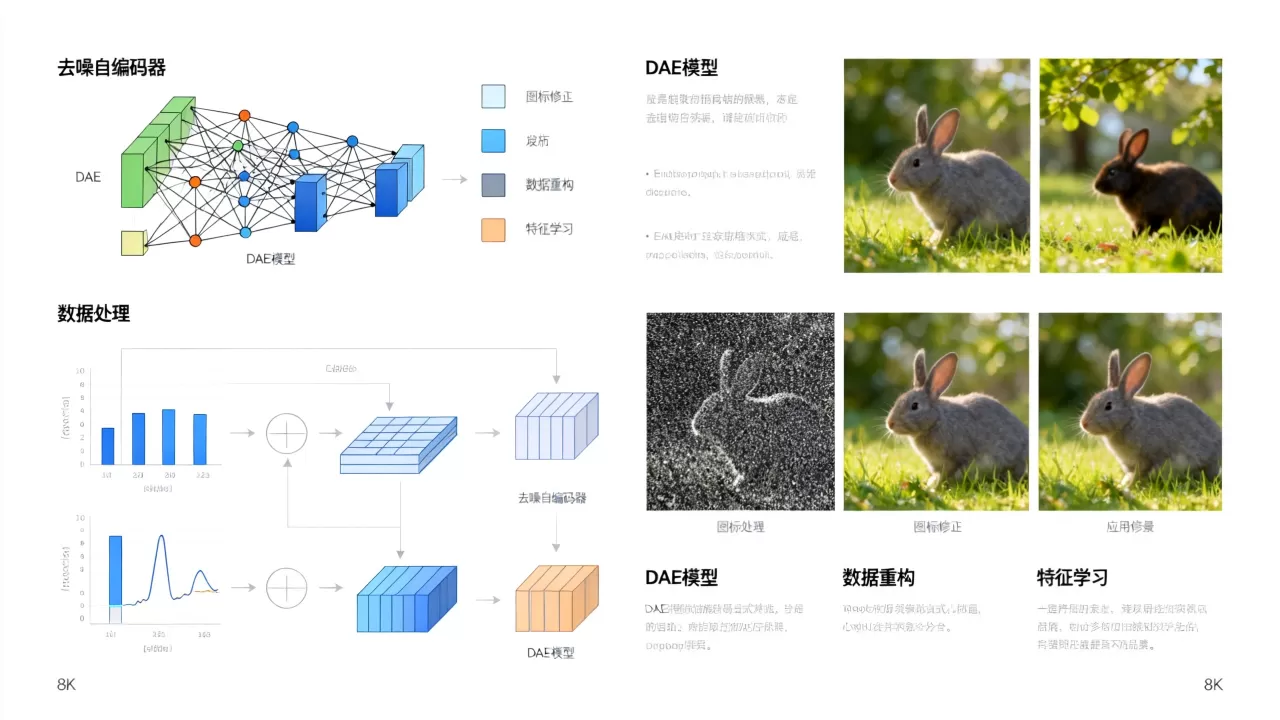
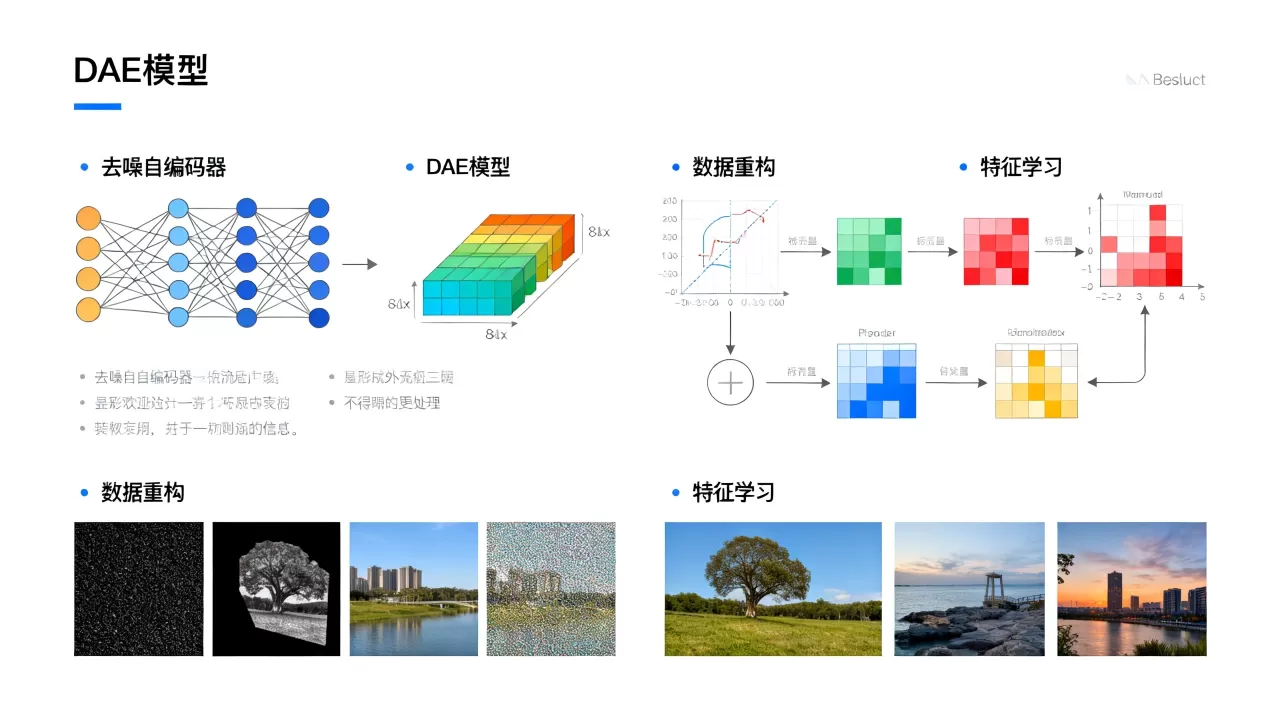
去噪自编码器(DAE)是一种通过向输入数据添加噪声并训练模型重建原始干净数据,从而学习数据深层特征表示的神经网络架构,其核心在于利用“噪声”作为正则化手段,防止模型死记硬背,提升泛化能力。
在2026年的大模型语境下,DAE不再仅仅是图像处理的工具,而是理解语义、清洗数据甚至生成内容的底层逻辑之一,它像是一个在嘈杂环境中练就了“听清重点”能力的翻译官,即使周围人声鼎沸(噪声干扰),也能准确还原出原本想表达的意思(原始数据)。


大模型的去噪自编码器DAE是什么
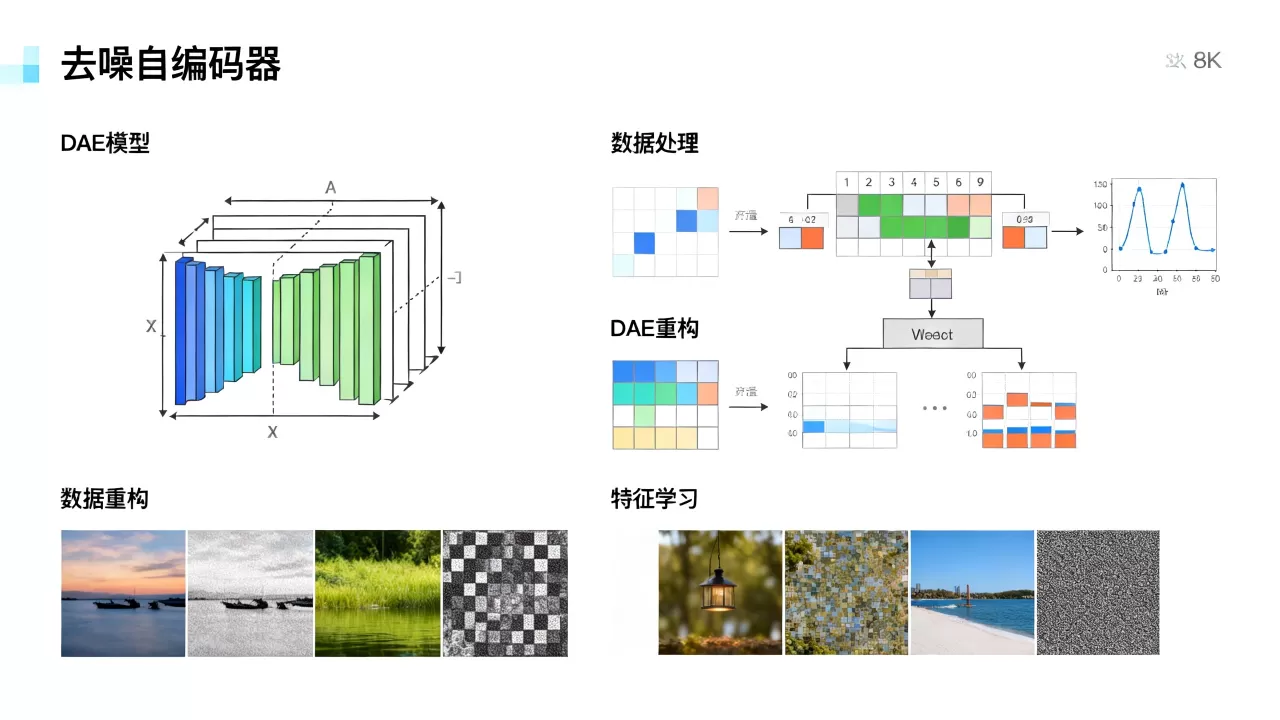
要理解DAE,我们得先拆解它的名字,自编码器(Autoencoder)本身是一个无监督学习模型,它由两部分组成:编码器(Encoder)和解码器(Decoder),编码器负责把输入数据压缩成低维的潜在表示(Latent Representation),解码器则负责把这个压缩后的表示还原回原始数据。
普通的自编码器容易陷入“恒等映射”的陷阱,也就是直接复制输入,而不学习任何有意义的特征,去噪自编码器通过引入噪声打破了这种惰性。
工作原理与核心机制
DAE的工作流程可以概括为“破坏-重建”循环。
第一步:注入噪声
假设我们有一张清晰的照片或者一段完整的文本,DAE不会直接处理它,而是先人为地给数据加上干扰。
- 高斯噪声:给连续数据(如数值、向量)加上随机波动。
- 掩码噪声(Masking):随机遮盖部分数据(如文本中的单词、图像中的像素块)。
- 缺失值:故意让部分数据不可见。
第二步:编码压缩
模型接收这些“残缺”或“模糊”的数据,尝试将其映射到一个紧凑的潜在空间,在这个过程中,模型被迫忽略那些随机的噪声,提取出数据中最稳定、最具代表性的结构特征。
第三步:解码重建
解码器接收潜在向量,尝试还原出最初那个“干净”的原始数据,损失函数计算的是重建数据与原始干净数据之间的差异,模型通过反向传播不断调整参数,直到能够准确从噪声中恢复出真相。
业内专家指出,这种机制本质上是一种强大的正则化方法,它迫使模型学习数据的流形结构,而不是简单的像素或字符对应关系。
DAE在2026年大模型生态中的关键角色
随着大语言模型(LLM)和多模态大模型的发展,DAE的应用场景发生了深刻变化,它不再局限于传统的图像去噪,而是成为了数据治理和特征提取的重要基础设施。
数据清洗与预处理
在训练大模型之前,数据质量决定上限,互联网上的数据充满了垃圾信息、错别字和无关内容。
- 文本清洗:利用DAE架构训练一个语言模型,输入包含错别字或语法错误的文本,目标输出是修正后的标准文本,这比传统的规则匹配更智能,能理解上下文语境。
- 图像修复:在视频生成或图像编辑中,DAE用于修复被压缩失真或遮挡的画面细节。
特征提取与表示学习
DAE学到的潜在向量(Latent Vector)通常比原始数据更具语义密度。
- 降维可视化:将高维数据通过DAE压缩后,可以更清晰地展示数据分布。
- 异常检测:如果模型无法从噪声中很好地重建某条数据,说明该数据可能属于异常值或噪声本身,这在金融风控和工业质检中非常有用。
对比传统自编码器的优势
| 特性 | 普通自编码器 (AE) | 去噪自编码器 (DAE) |
|---|---|---|
| 输入数据 | 干净原始数据 | 被破坏/含噪声的数据 |
| 学习目标 | 复制输入 | 重建原始干净数据 |
| 抗过拟合能力 | 较弱,易学恒等映射 | 强,强制学习鲁棒特征 |
| 泛化性能 | 一般 | 优异,能处理未见过的噪声 |
为什么DAE对大模型训练至关重要
在2026年,算力成本和数据规模成为制约模型发展的两大瓶颈,DAE提供了一种高效的学习范式。
提升模型的鲁棒性
现实世界的数据从来不是完美的,用户输入的语音可能有背景音,拍摄的照片可能有模糊,文本可能有拼写错误,DAE在训练阶段就模拟了这些情况,使得模型在推理阶段面对真实世界的“脏数据”时,依然能保持稳定的输出。
具体场景示例
想象一个智能客服系统,如果用户输入“我买的东西怎么还没到?”,东西”被误识别为“东西(同音字)”,“到”被误识别为“倒”。
- 普通模型可能直接基于错误字符进行语义匹配,导致回答偏差。
- 经过DAE预训练的模型,由于在训练中学会了从噪声中还原语义,它能自动纠正这些错误,理解用户真实的意图是询问物流状态。
实现半监督学习
标注数据昂贵且稀缺,而无标注数据海量,DAE允许我们利用大量无标注数据进行预训练,学习通用的数据分布特征,随后,只需少量标注数据微调下游任务,就能取得很好的效果,这种“预训练+微调”的模式已成为2026年大模型开发的标准路径。
行业共识认为,DAE在预训练阶段的作用类似于“数据过滤器”,它帮助模型建立起对数据本质的理解,而非仅仅记忆表面模式。
如何实操:构建一个简单的DAE流程
对于开发者而言,理解DAE不仅仅是理论,更需要落地,以下是一个基于PyTorch构建简单DAE的核心逻辑步骤。
定义噪声函数
首先需要定义如何破坏数据,以文本为例,可以使用随机掩码(Random Masking)。
def add_noise(text, noise_level=0.15):
    words = text.split()
    # 以一定概率将单词替换为特殊标记[MASK]
    noisy_words = [
        "[MASK]" if random.random() < noise_level else word
        for word in words
    ]
    return " ".join(noisy_words)
构建编码器与解码器
编码器将输入映射为潜在向量,解码器将其还原,可以使用LSTM或Transformer作为基础组件。
关键参数设置
- 潜在维度(Latent Dimension):通常远小于输入维度,迫使模型压缩信息。
- 噪声强度:噪声太大,模型无法学习;噪声太小,模型容易退化,通常需要通过实验调整。
训练与评估
使用重建损失(如交叉熵损失或均方误差)作为优化目标,训练过程中,监控验证集上的重建准确率,确保模型没有过拟合训练数据。
常见疑问解答
大模型的去噪自编码器DAE与变分自编码器VAE有什么区别
DAE和VAE都是生成模型的基础,但侧重点不同,DAE的核心目标是“去噪”,即学习从噪声数据中恢复原始数据,它关注的是数据的鲁棒特征提取,潜在空间通常是确定性的,VAE的核心目标是“生成”,它假设潜在空间服从某种概率分布(如高斯分布),通过引入随机采样来生成新数据,DAE更像是一个“修复师”,而VAE更像是一个“创作者”,在2026年的大模型应用中,DAE更多用于特征学习和数据清洗,VAE则更多用于图像或视频的生成任务。
DAE在中文大语言模型训练中有什么特殊应用
中文具有单字成词、多字词义复杂的特点,且存在大量的同音字和错别字,DAE在中文NLP中的应用主要体现在两个方面:一是通过掩码语言模型(Masked Language Model, MLM)的形式,随机遮盖中文句子中的字符,让模型预测被遮盖的字,这本质上就是一种DAE机制;二是用于中文文本的纠错与规范化,特别是在OCR识别后的文本处理中,DAE能有效纠正因图像模糊导致的识别错误,据工信部相关技术报告指出,采用DAE预训练的中文模型在低资源语言任务上的表现显著优于传统监督学习方法。
DAE是否会增加大模型的训练成本
从单次训练迭代来看,DAE确实增加了数据预处理和重建计算的开销,从整体模型效能来看,DAE能显著提升模型的收敛速度和最终性能,由于DAE强制模型学习更本质的特征,往往可以用更少的标注数据达到相同的性能水平,从而降低了数据标注成本,DAE学到的良好初始化参数,可以减少后续微调所需的训练轮数,综合来看,DAE是一种以计算换效率、以预处理换泛化能力的策略,长期来看有助于降低总体的模型开发成本。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/405717.html