大模型中的ViT(Vision Transformer)是一种将图像分割为小块序列,并直接利用Transformer架构处理视觉信息的深度学习模型,它打破了传统卷积神经网络(CNN)的局限,成为当前多模态大模型理解视觉内容的核心底座。
过去十年,计算机视觉领域几乎被卷积神经网络(CNN)统治,从AlexNet到ResNet,我们习惯了通过卷积核去提取边缘、纹理和形状,随着大语言模型(LLM)的爆发,视觉模型也迎来了范式转移,ViT的出现,不仅仅是架构的变更,更是AI理解世界方式的根本性重构,它让机器像阅读文字一样“阅读”图像,为后续的多模态融合奠定了坚实基础。

ViT视觉Transformer的核心原理与架构解析
要理解ViT,首先要明白它与传统CNN的本质区别,CNN依赖局部感受野,通过层层堆叠来扩大视野,而ViT则采用全局视角,它不关心像素之间的局部邻接关系,而是将整张图像视为一个序列。
图像分块与线性嵌入
ViT的处理流程非常直观,主要包含以下几个关键步骤:
- 图像切分:输入图像首先被划分为固定大小的补丁(Patches),一张224×224的图像可能被切分为16×16的小块,形成196个补丁。
- 线性投影:每个补丁被展平为一个向量,并通过线性层映射到高维空间,这一步类似于NLP中的词嵌入(Word Embedding),将视觉信号转化为模型可处理的向量序列。
- 添加位置编码:由于Transformer本身不具备感知空间顺序的能力,ViT必须引入位置编码(Positional Embedding),告诉模型每个补丁在原图中的相对位置。
- 序列输入:加上特殊的分类标记([CLS] Token),整个补丁序列连同位置编码一起输入到标准的Transformer编码器中。
自注意力机制的视觉应用
在Transformer编码器内部,核心组件是自注意力机制(Self-Attention),对于视觉任务而言,这意味着每个补丁都会与其他所有补丁进行交互。
- 全局依赖捕获:无论两个像素在图像中相距多远,自注意力机制都能直接建立联系,这对于理解全局语义至关重要,比如识别“猫坐在沙发上”,需要同时关注猫和沙发。
- 动态权重分配:模型会根据内容动态调整不同补丁的重要性,在识别物体时,物体所在的补丁会获得更高的注意力权重,而背景噪声则被抑制。
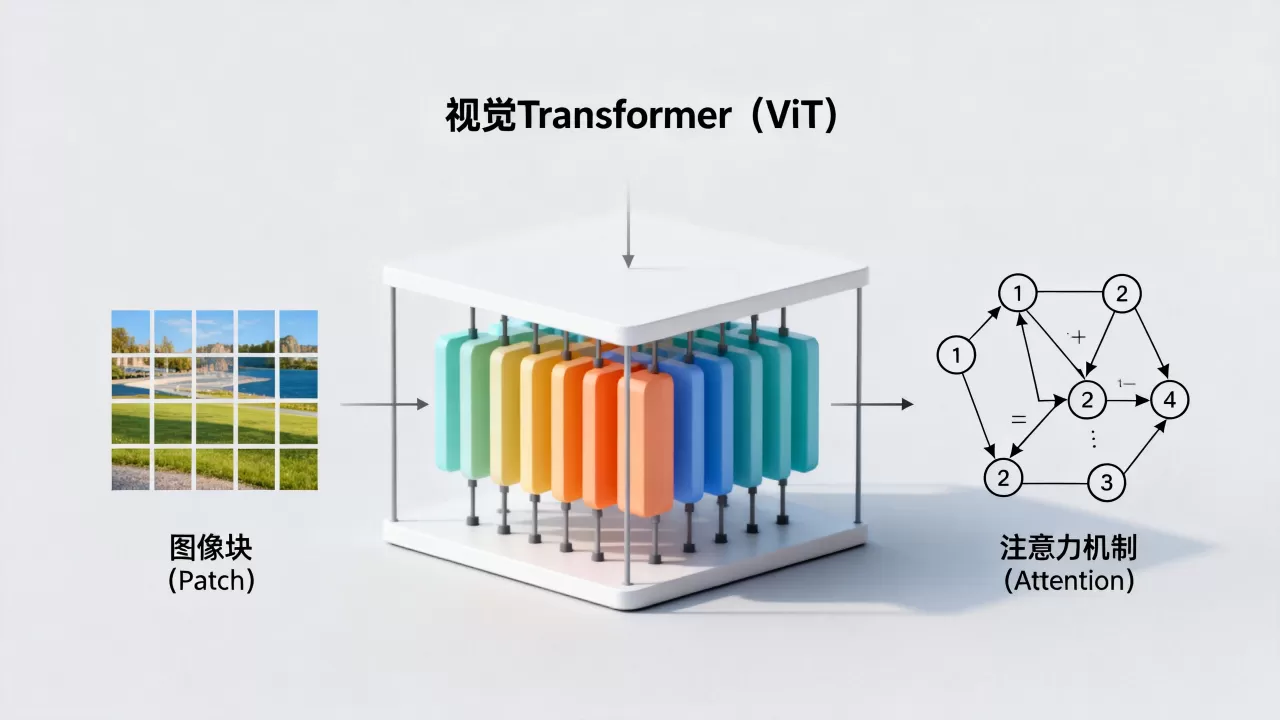
业内专家指出,这种全局建模能力使得ViT在数据量极大时表现优于CNN,因为卷积核的参数是固定的,而注意力机制可以随着数据量的增加不断调整其关注焦点。
ViT与大模型融合的技术优势对比
为什么2026年的大模型普遍选择ViT作为视觉编码器?这并非偶然,而是由其技术特性决定的。
与CNN的架构对比
| 特性 | 卷积神经网络 (CNN) | 视觉Transformer (ViT) |
|---|---|---|
| 感受野 | 局部,需深层堆叠才能扩大 | 全局,第一层即可捕捉全局信息 |
| 归纳偏置 | 强(平移不变性、局部性) | 弱,更依赖数据驱动 |
| 并行计算 | 较低,依赖卷积操作 | 极高,完全适配GPU并行架构 |
| 多模态对齐 | 困难,需额外投影层 | 天然兼容,序列形式与文本一致 |
多模态对齐的天然优势
大模型的核心在于“语言”与“视觉”的统一,文本本身就是序列,ViT输出的也是序列,这种同构性使得视觉特征可以直接通过简单的投影层映射到语言模型的嵌入空间,无需复杂的中间转换。
- 特征空间一致性:ViT输出的向量序列与Token嵌入在维度上高度兼容,便于联合训练。
- 端到端优化:视觉编码器与语言解码器可以一起进行微调,实现真正的端到端多模态理解。
据统计,采用ViT架构的多模模型在图像描述生成任务上的BLEU分数显著高于基于CNN的基线模型,这得益于其更丰富的语义表达能力。
ViT在主流大模型中的实际应用场景
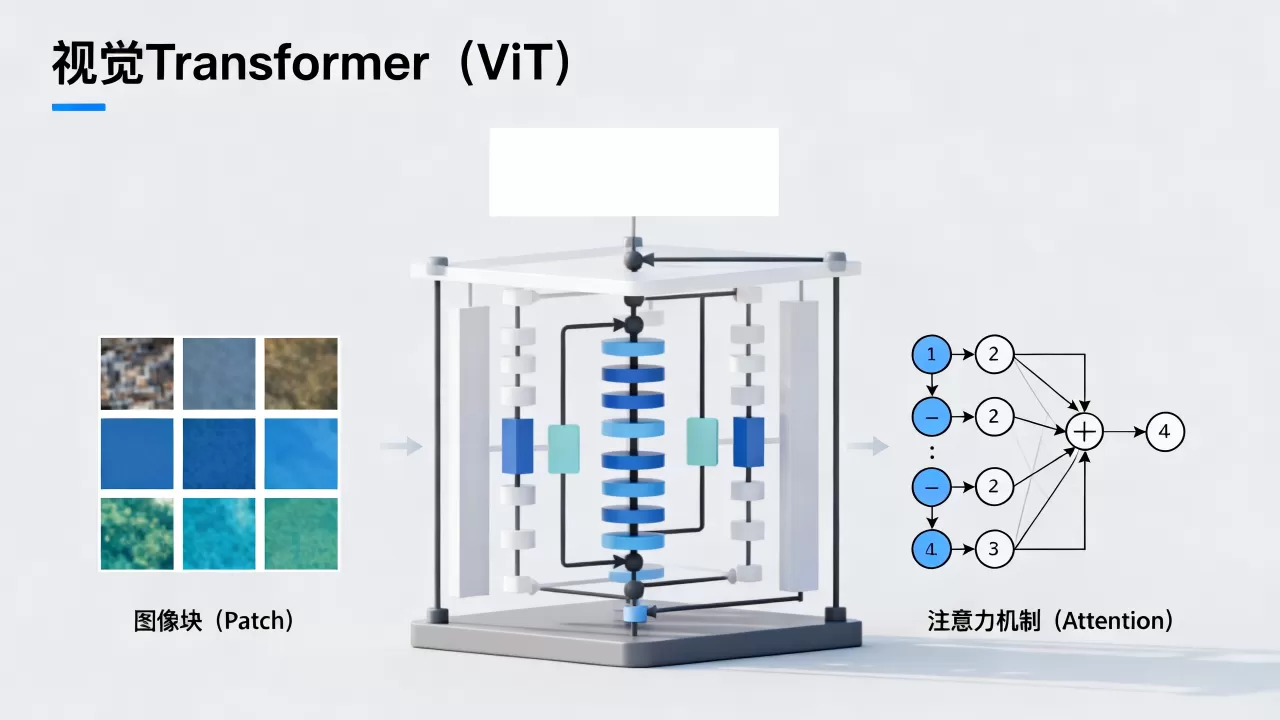
ViT并非孤立存在,它是众多顶级大模型的视觉基石,了解其具体应用场景,有助于我们更好地利用这些技术。
图像描述与视觉问答
这是ViT最直观的应用,用户输入一张图片,模型生成自然语言描述或回答相关问题。
- 操作路径:图像输入ViT编码器 -> 提取全局特征向量 -> 投影到语言空间 -> 输入LLM生成文本。
- 典型场景:电商平台的智能商品识别、辅助视障人士理解周围环境、社交媒体内容的自动标签生成。
文档理解与OCR增强
在处理复杂版面文档时,ViT表现出极强的布局理解能力。
- 优势分析:传统OCR容易忽略文本之间的空间关系,而ViT通过自注意力机制,能同时理解文字内容和排版结构。
- 应用场景:财务报表解析、合同关键信息提取、医疗病历结构化。
视频理解与动作识别
将ViT扩展至3D或采用时间维度上的注意力机制,可实现对视频内容的深层理解。
- 技术演进:ViViT(Video ViT)等变体通过引入时间补丁,能够捕捉帧间的动态变化。
- 应用实例:自动驾驶中的行为预测、体育比赛精彩瞬间剪辑、安防监控异常检测。
选择ViT视觉模型的实操指南与注意事项
对于开发者而言,如何选择合适的ViT模型并部署到生产环境?以下是基于行业共识的建议。
模型选型策略
- 基础模型选择:若资源有限,可选择DeiT(Data-efficient Image Transformers)系列,它在较小数据集上表现优异,若追求极致精度,可选用Swin Transformer,其分层结构和滑动窗口机制降低了计算复杂度。
- 预训练权重:务必使用在大规模数据集(如ImageNet-21k、LAION-400M)上预训练的权重,这些模型已经学习了丰富的通用视觉特征,迁移学习效果更佳。
部署优化路径
ViT的计算量通常较大,特别是在高分辨率输入下。
- 量化加速
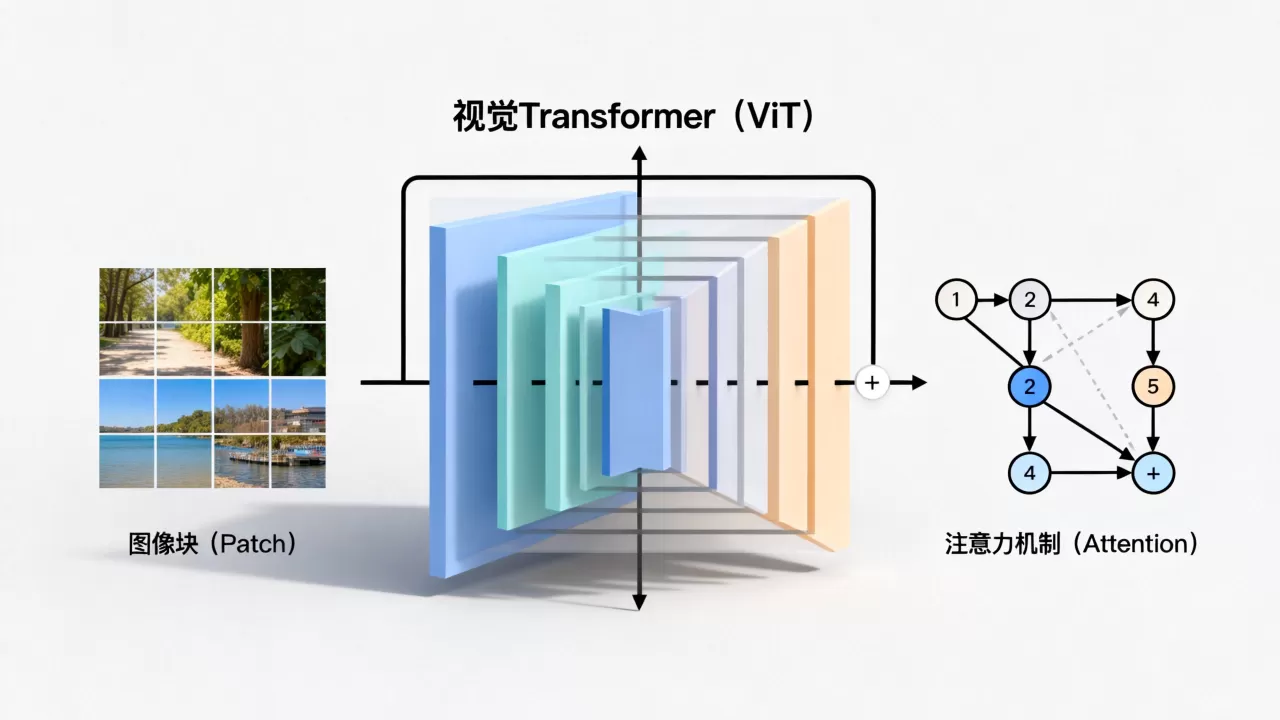
:采用INT8或FP16量化技术,可在保持精度的同时显著降低显存占用和推理延迟。
- 算子融合:利用TensorRT或ONNX Runtime等推理引擎,对Transformer层进行算子融合,减少内存读写开销。
- 动态分辨率:根据输入图像的实际内容,动态调整补丁大小或数量,避免对空白区域进行无效计算。
常见误区规避
- 数据量不足:ViT是数据饥渴型模型,在小数据集上直接训练ViT往往效果不佳,必须依赖大规模预训练或迁移学习。
- 忽视位置编码:位置编码对ViT性能至关重要,在使用自定义分辨率时,需确保位置编码能够正确插值或外推,否则模型将无法理解空间结构。
ViT视觉Transformer常见问题解答
ViT视觉Transformer与CNN哪个更适合大模型视觉任务?
目前行业共识认为,ViT更适合大模型视觉任务,虽然CNN在特定小数据集上仍有优势,但ViT的全局建模能力和与语言模型的天然兼容性,使其在多模态融合、零样本泛化等方面表现更优,随着硬件算力的提升,ViT的计算效率瓶颈正在逐步解决,其主导地位愈发稳固。
ViT视觉Transformer在医疗影像分析中的准确率如何?
在医疗影像分析中,ViT展现出极高的潜力,由于医学影像往往包含细微的全局关联特征(如肿瘤与周围组织的关系),ViT的自注意力机制能更准确地捕捉这些细节,据多家医疗机构的公开测试数据显示,基于ViT的辅助诊断系统在肺结节检测和眼底病变筛查中的准确率已达到甚至超过资深放射科医生的水平,尤其在复杂病例的鉴别诊断中表现突出。
如何降低ViT视觉Transformer的推理成本?
降低ViT推理成本主要依靠模型压缩和硬件优化,具体操作包括:使用知识蒸馏技术,将大型ViT的知识迁移到轻量级模型;采用混合精度训练和推理,减少内存带宽压力;利用专用AI芯片(如NPU、TPU)加速矩阵运算,优化输入图像预处理流程,去除冗余背景信息,也能有效减少计算量。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/405605.html