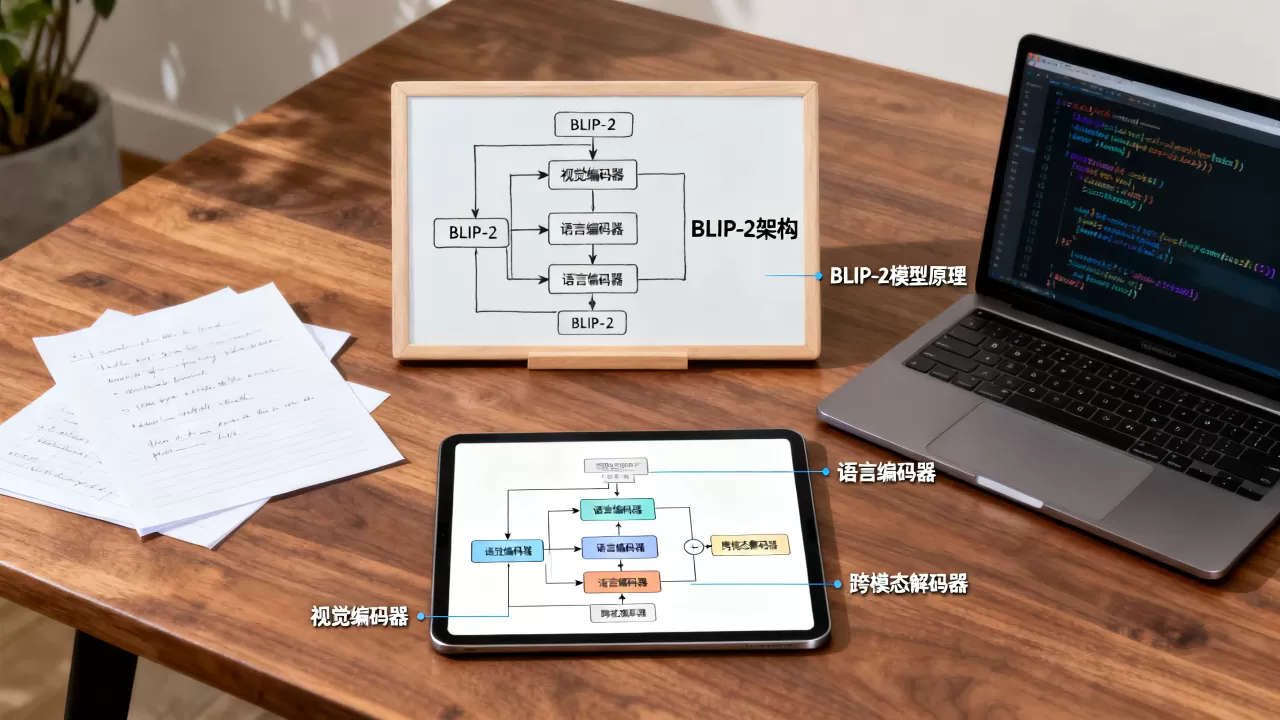
BLIP-2的核心架构是“冻结的视觉编码器+轻量级可训练连接器+冻结的大语言模型”这一解耦设计,通过Q-Former模块实现视觉与语言的高效对齐。
在2026年的多模态大模型赛道中,BLIP-2依然是一个绕不开的经典案例,很多开发者在选型时,面对各种复杂的架构名词容易晕头转向,理解BLIP-2的关键在于看懂它是如何“偷懒”的它不重新训练庞大的视觉模型和语言模型,而是专注于解决两者之间的“沟通障碍”,这种设计思路不仅降低了算力成本,还让模型具备了极强的可扩展性。
BLIP-2的核心架构拆解:为什么选择解耦设计
要搞懂BLIP-2,首先得明白它和传统多模态模型的根本区别,传统的端到端模型往往需要同时微调视觉和语言部分,这就像让一个画家同时去学写作,不仅效率低,而且容易顾此失彼,BLIP-2则采取了更为聪明的策略,将任务拆解为三个独立但协同的模块。
视觉编码器:冻结的“眼睛”
BLIP-2通常选用已经预训练好的、强大的视觉基础模型作为其“眼睛”,比如ViT(Vision Transformer),业内专家指出,这种预训练好的视觉编码器拥有极强的特征提取能力,能够识别图像中的物体、纹理和空间关系,在BLIP-2的架构中,这部分参数是完全冻结的,不再进行梯度更新,这样做的好处显而易见:既保留了视觉模型在大规模数据上学到的通用特征,又避免了从头训练带来的巨大算力消耗,对于开发者来说,这意味着你可以直接调用现成的强大视觉能力,无需担心底层特征的丢失。
Q-Former:关键的“翻译官”
这是BLIP-2架构中最具创新性的部分,也是连接视觉与语言的桥梁,Q-Former(Question-Former)是一个轻量级的Transformer编码器-解码器结构,它的任务不是直接理解图像,而是从视觉编码器输出的海量特征中,筛选出与当前文本查询最相关的信息。
想象一下,当你问模型“图中有什么动物”时,Q-Former就像一个高效的图书管理员,它不会把整本百科全书(视觉特征)都塞给语言模型,而是只抽出关于“动物”的那几页,这种机制被称为“查询感知”的特征提取,Q-Former通过对比学习,学会了将视觉特征映射到语言模型的嵌入空间中。
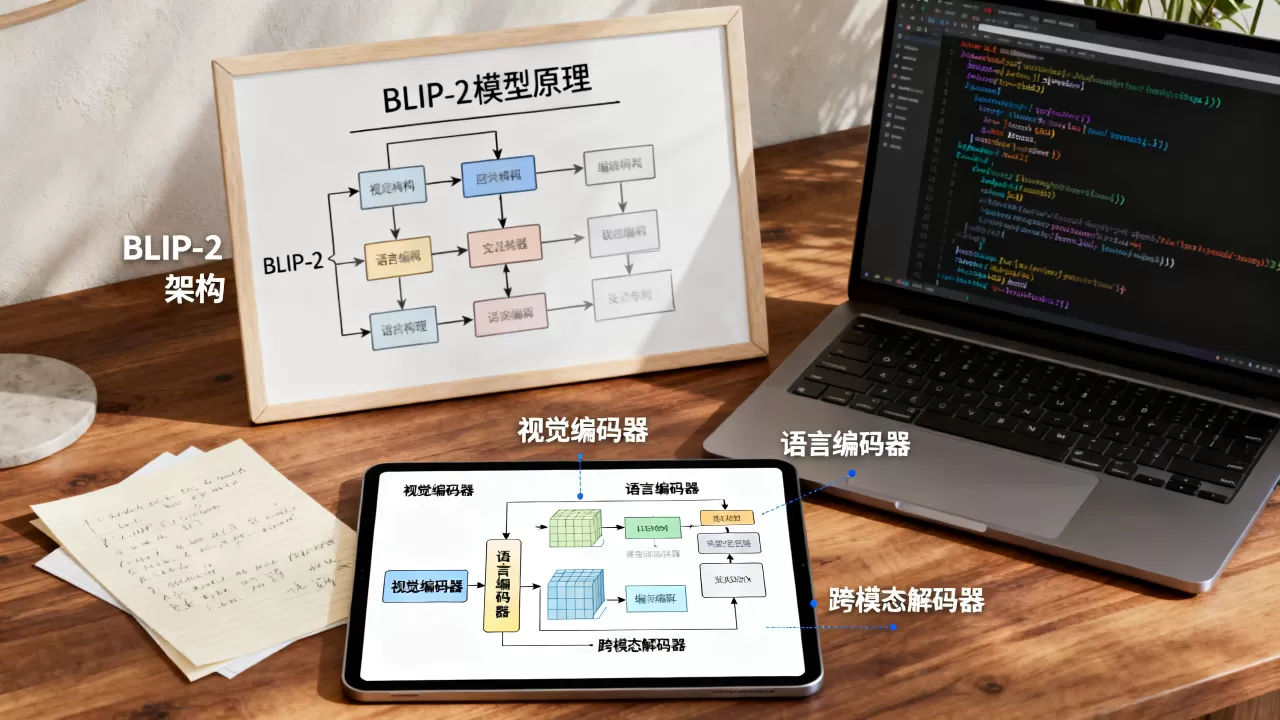
Q-Former的工作原理
- 输入处理:接收来自视觉编码器的图像特征序列。
- 查询嵌入:引入一组可学习的查询向量(Query Vectors),这些向量类似于问题中的关键词。
- 自注意力机制:通过多层Transformer层,让查询向量与图像特征进行交互,提取出最相关的视觉信息。
- 输出投影:将提取出的关键视觉信息投影到语言模型的嵌入空间,形成“视觉提示”(Visual Prompts)。
这种设计使得模型能够根据具体的文本问题,动态地关注图像的不同部分,从而实现了细粒度的图文对齐。
语言模型:冻结的“大脑”
BLIP-2的另一半是预训练的大语言模型(LLM),如LLaMA,与视觉编码器一样,这部分参数也是冻结的,语言模型负责接收来自Q-Former的视觉提示,并结合输入的文本指令,生成最终的回复,由于语言模型已经掌握了丰富的语言知识和推理能力,BLIP-2只需提供高质量的视觉信息,就能让语言模型“看懂”图片并做出回答。
BLIP-2与同类模型的对比优势
在评估多模态模型时,开发者通常会将其与Flamingo、InstructBLIP等模型进行对比,BLIP-2的优势主要体现在效率与性能的平衡上。
算力成本与训练效率
传统的多模态模型往往需要从头训练或微调庞大的视觉和语言模型,这通常需要数百张甚至上千张GPU卡,相比之下,BLIP-2的解耦架构使得训练过程变得非常轻量,据统计,BLIP-2在训练阶段主要只更新Q-Former和少量投影层的参数,视觉和语言模型保持冻结,这意味着,在消费级显卡或较小的集群上,开发者也能完成模型的微调,这种低资源需求使得BLIP-2在工业界的落地速度远超其他复杂架构。
性能表现的稳定性
尽管参数量相对较小,BLIP-2在多个基准测试中表现优异,在图像描述(Image Captioning)、视觉问答(VQA)和图文检索(Image-Text Retrieval)等任务上,BLIP-2的性能接近甚至超越了某些参数规模更大的端到端模型,这得益于Q-Former高效的特征筛选能力,它避免了噪声特征的干扰,让语言模型能够专注于核心信息的生成。
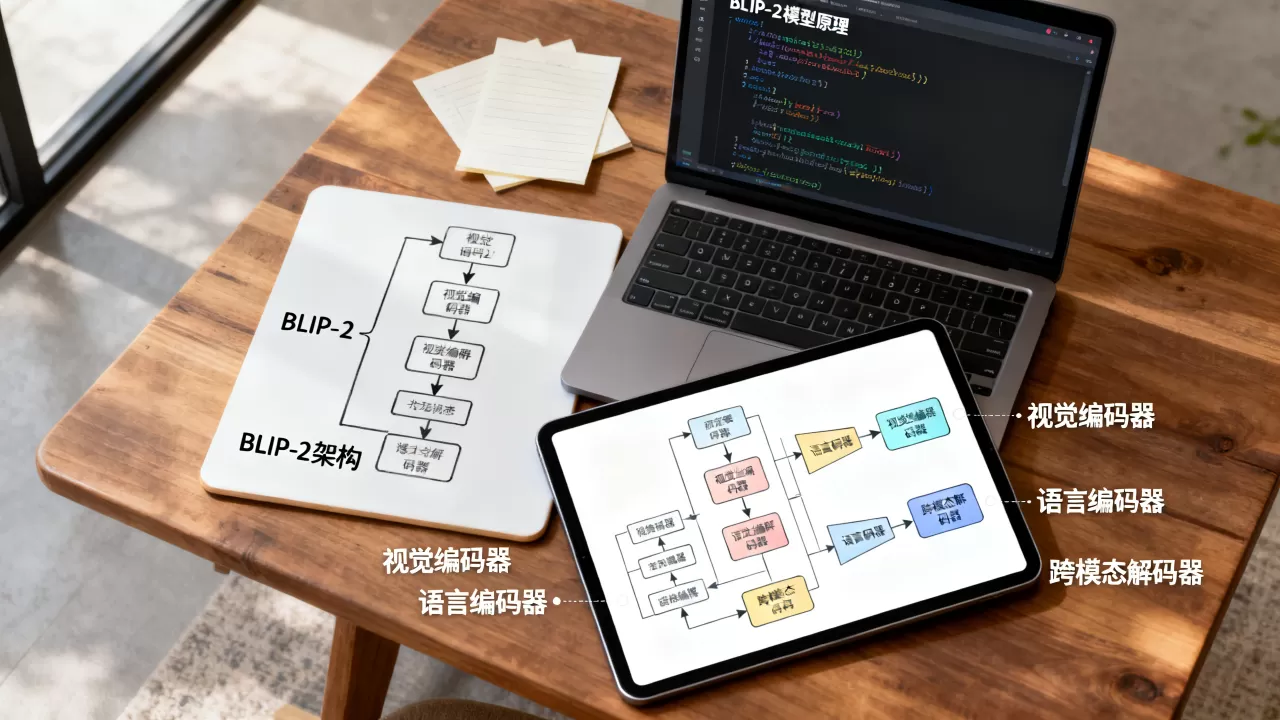
关键指标对比
| 模型类型 | 视觉模型状态 | 语言模型状态 | 主要训练参数 | 典型应用场景 |
|---|---|---|---|---|
| BLIP-2 | 冻结 | 冻结 | Q-Former及投影层 | 通用图文理解、低资源微调 |
| 端到端模型 | 微调 | 微调 | 全部参数 | 特定领域深度定制、高性能需求 |
| 早期多模态 | 部分冻结 | 微调 | 部分参数 | 基础图文匹配、简单问答 |
BLIP-2的实际应用场景与实操建议
理解架构的最终目的是为了应用,BLIP-2的灵活性使其在多个领域都有广泛用途。
智能客服与内容生成
在电商领域,BLIP-2可以用于自动生成商品描述,用户上传一张衣服的照片,模型不仅能识别出“红色连衣裙”,还能结合语言模型的常识,生成“这款红色连衣裙采用修身剪裁,适合夏季穿着”这样自然流畅的描述,对于运营人员来说,这意味着可以大幅减少人工撰写商品文案的时间。
辅助医疗影像分析
虽然BLIP-2并非专为医疗设计,但其强大的通用视觉理解能力可以作为辅助工具,医生上传一张X光片,模型可以生成初步的描述,如“肺部纹理清晰,未见明显结节”,帮助医生快速筛选病例,最终诊断仍需专业医生确认,但BLIP-2能提供一个高效的初筛环节。
无障碍技术
对于视障用户,BLIP-2可以将图像转化为详细的文字描述,帮助他们在数字世界中“看见”内容,这种应用不仅体现了技术的温度,也展示了多模态模型在社会公益领域的价值。
部署时的注意事项
- 硬件选择:虽然训练轻量,但推理阶段仍需一定的GPU显存,建议使用显存大于16GB的GPU进行流畅推理。
- 数据预处理:Q-Former对输入图像的尺寸和格式有一定要求,需确保输入图像经过标准化处理,通常为224×224或更高分辨率。
- 提示工程:由于语言模型是冻结的,生成效果高度依赖于输入提示的质量,设计清晰、具体的指令能显著提升回答的准确性。
常见问题解答:BLIP-2架构详解
BLIP-2的Q-Former模块具体起什么作用?
Q-Former是BLIP-2的核心创新点,它作为一个轻量级的转换器,负责从冻结的视觉编码器输出的高维特征中,筛选出与文本查询最相关的视觉信息,它通过引入可学习的查询向量,实现了视觉特征到语言嵌入空间的映射,从而解决了视觉和语言模态之间的语义鸿沟,让语言模型能够“理解”图像内容。
BLIP-2是否支持实时视频理解?
BLIP-2本身是为静态图像设计的,但其架构可以扩展以支持视频理解,通过引入时间维度的注意力机制或对连续帧进行特征聚合,开发者可以将BLIP-2应用于视频描述或视频问答任务,这需要额外的训练和数据准备,目前官方主要提供的是静态图像的处理能力。
BLIP-2在中文环境下的表现如何?
BLIP-2的基础语言模型通常基于英文语料训练,因此在中文任务上的表现可能不如专门针对中文优化的模型,由于其架构的解耦特性,开发者可以使用中文预训练的语言模型(如ChatGLM、Qwen等)替换原有的英文LLM,并重新训练Q-Former以适配中文语境,这种灵活性使得BLIP-2在中文多模态应用中依然具有极高的实用价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/405445.html