

大模型混合专家(MoE)路由的核心在于通过动态选择子网络激活特定专家,在保持参数总量巨大的同时,显著降低推理成本并提升响应速度。
传统的大语言模型大多采用稠密架构,每次生成回答时,所有的参数都会被调用,这种“全量激活”的方式虽然能保证知识的全面性,但也带来了巨大的算力浪费和延迟,想象一下,你问一个博学的教授“今天天气如何”,他却先背诵了一遍量子力学公式,再回答天气,这显然效率极低,MoE架构的出现,就是为了解决这个“杀鸡用牛刀”的问题,它像是一个拥有多个专业顾问的团队,你只需要根据问题类型,精准呼叫对应的专家,而不是让所有顾问都站起来发言。参考2
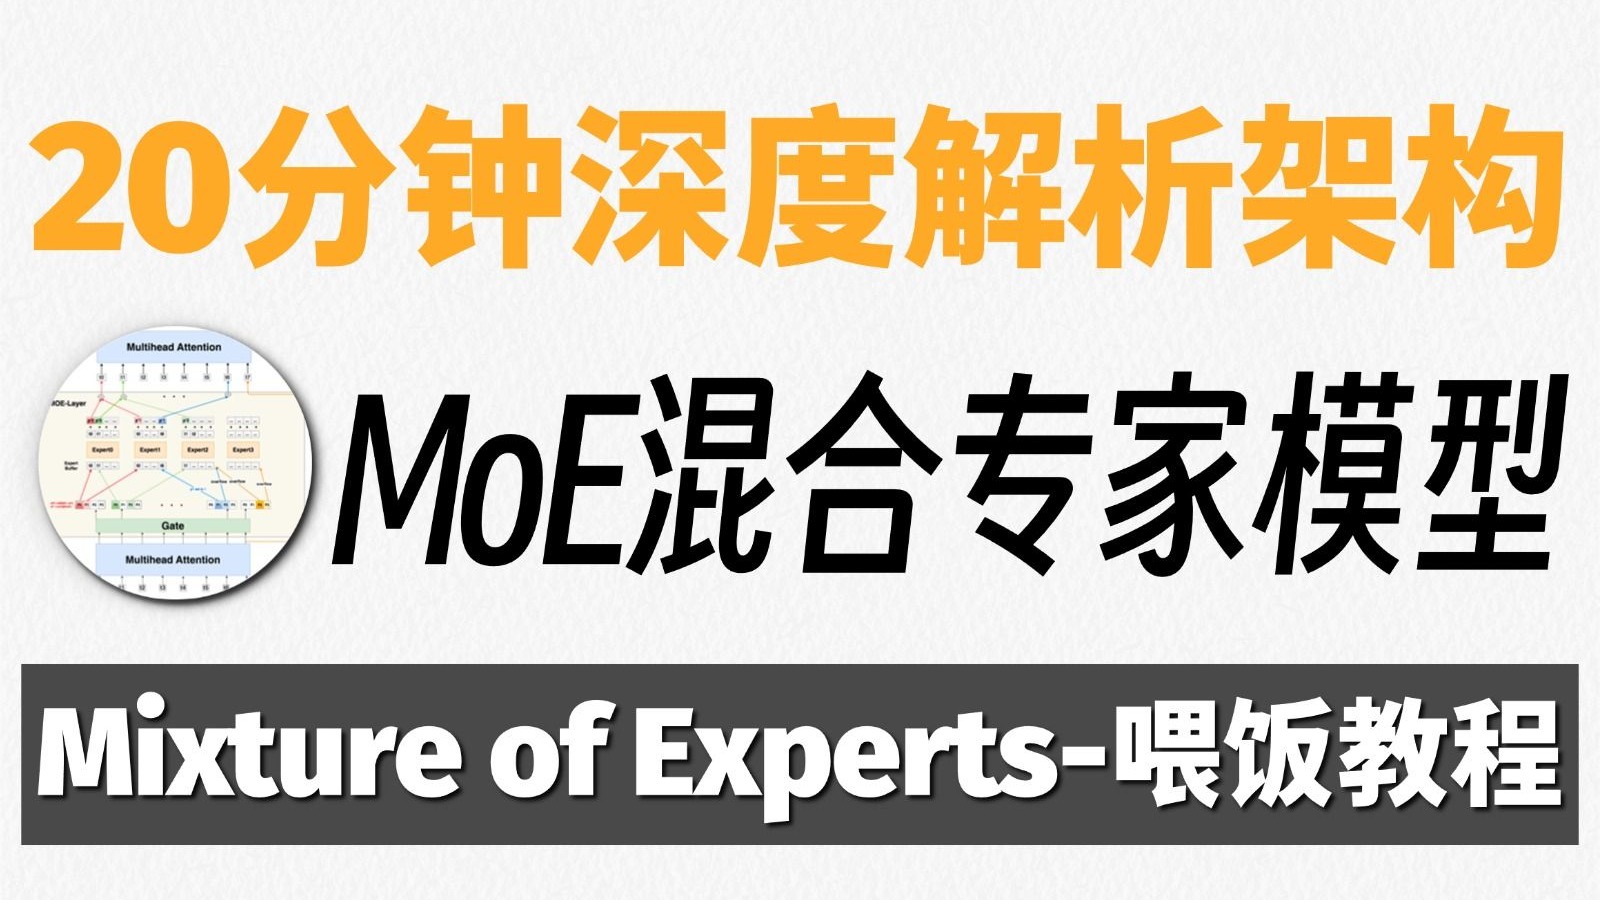
MoE架构的基本原理与运作机制
MoE,即Mixture of Experts,混合专家模型,它的核心思想是将庞大的模型参数拆分成多个小的“专家”模块,每个专家只负责处理特定类型的数据或任务。
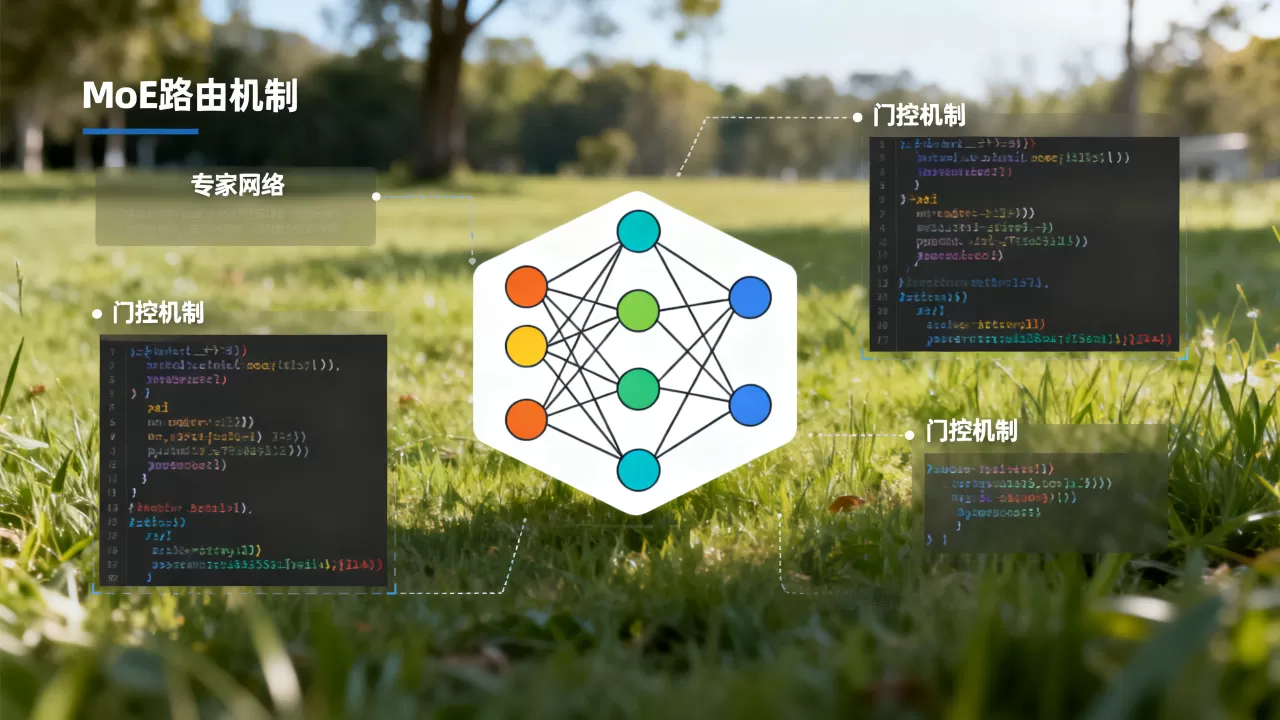
门控机制:智能的路由指挥家
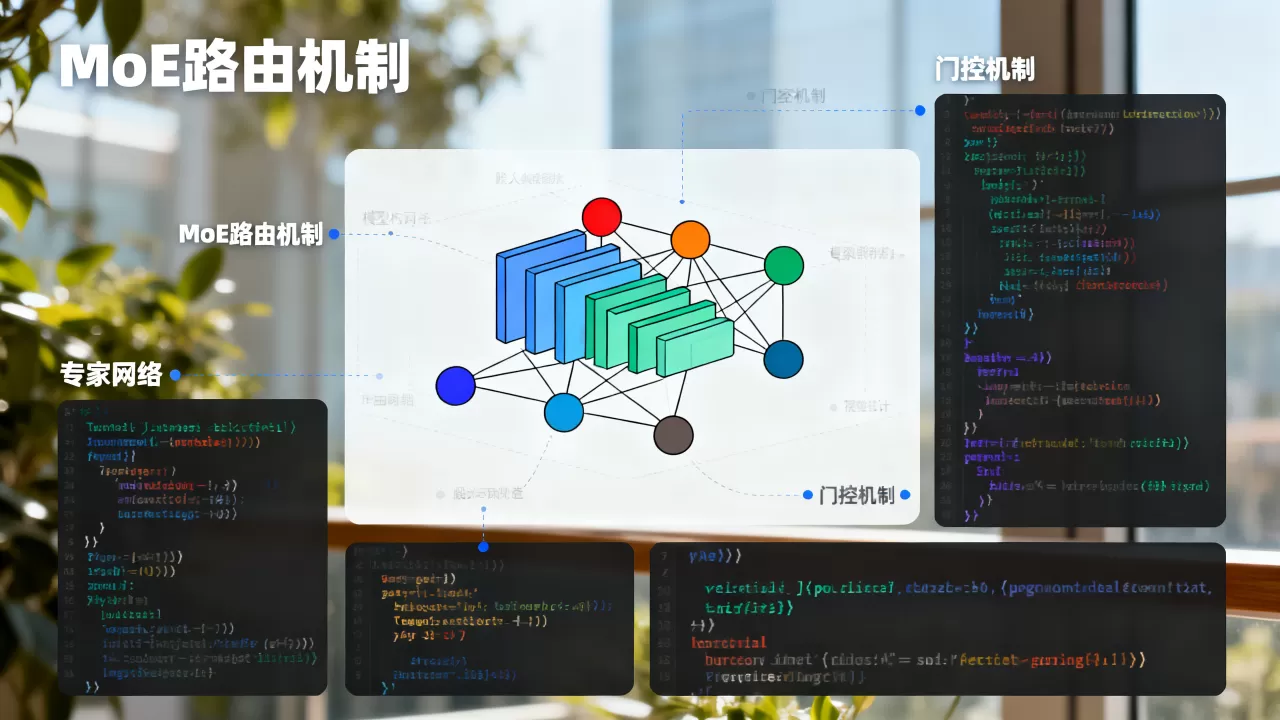
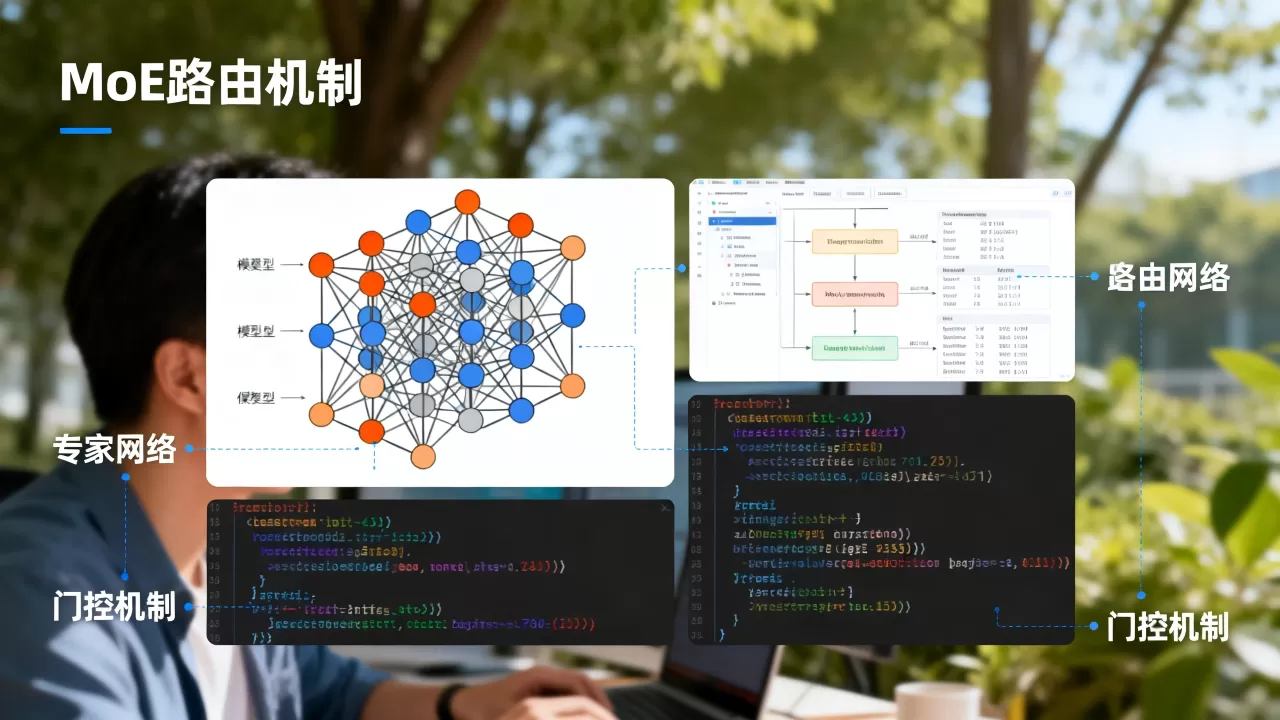
在MoE中,最关键的组件是“门控网络”(Gating Network),它的作用就像一个经验丰富的调度员,负责判断输入的问题应该交给哪位专家处理。
- 输入分析:当用户提出一个问题时,门控网络首先对问题进行特征提取。
- 权重计算:根据提取的特征,计算每个专家的匹配度得分。
- 专家选择:通常只选择得分最高的K个专家(例如Top-2)进行激活,其余专家保持休眠状态。
- 结果加权:将选中专家的输出结果进行加权求和,得到最终答案。
这种机制确保了模型在处理简单问题时,只激活少量参数,从而大幅降低计算量,而在处理复杂问题时,则能调动更多专家协同工作,保证输出的质量。
稀疏激活:节省算力的关键
在传统的稠密模型中,无论问题难易,所有参数都参与计算,而在MoE中,只有被选中的专家参与计算,这就是“稀疏激活”。
据统计,采用MoE架构的大模型,在推理阶段可以节省相当一部分的算力资源,这意味着,同样的硬件条件下,MoE模型可以支持更高的并发量,或者在相同的并发量下,提供更快的响应速度,对于需要大规模部署的企业来说,这种效率提升意味着直接的服务器成本降低。参考2
MoE路由技术的实际应用场景与优势
MoE不仅仅是一个学术概念,它已经在多个实际场景中展现出巨大的应用价值,理解这些场景,有助于我们更好地评估其技术价值。
多语言与多领域处理
不同的语言和文化背景对应着不同的语言模式和知识体系,MoE可以通过分配不同的专家来处理不同语言或领域的内容。
- 语言专家:专门负责处理中文、英文、法文等不同语言的语法和语义。
- 领域专家:分别负责医疗、法律、编程、金融等专业领域的知识问答。
这种分工使得模型在处理跨领域、跨语言的任务时,能够更加精准和高效,在处理医疗咨询时,模型会激活医疗专家,而忽略编程专家,从而避免无关信息的干扰。
个性化推荐与内容生成
在推荐系统中,MoE可以用于捕捉不同用户的兴趣偏好,通过为不同用户群体分配不同的专家,模型可以更精准地生成个性化内容。
业内专家指出,这种基于用户画像的动态专家选择,能够显著提升推荐系统的点击率和用户满意度,对于内容创作者而言,这意味着可以更高效地生成符合特定受众口味的文章、视频脚本或营销文案。
MoE路由面临的挑战与优化方向
尽管MoE优势明显,但在实际落地过程中,仍然面临一些挑战,理解这些挑战,有助于我们在选型和部署时做出更明智的决策。
负载均衡问题
如果门控网络总是将相似类型的问题分配给同一组专家,会导致这些专家过载,而其他专家闲置,这种“忙闲不均”的现象会降低整体效率,甚至影响模型性能。
为了解决这个问题,研究者引入了辅助损失函数(Auxiliary Loss),鼓励门控网络更均匀地分配任务给各个专家,还有一些动态调整策略,根据专家的负载情况实时调整选择概率。
通信开销与显存占用
虽然MoE减少了计算量,但由于专家分布在不同的GPU或节点上,专家之间的数据通信可能成为瓶颈,特别是在大规模分布式部署中,通信延迟可能抵消掉计算节省带来的优势。
在硬件选型和集群配置时,需要重点关注网络带宽和显存容量,对于预算有限且追求高性能的团队来说,选择合适的MoE模型部署方案至关重要。
训练稳定性与收敛难度
MoE模型的训练比稠密模型更复杂,由于专家的选择是动态的,每个专家接收到的数据分布可能不一致,导致训练不稳定。
在实际操作中,需要精心调整学习率、专家数量等超参数,多数情况下,采用分阶段训练策略,先预训练稠密模型,再转换为MoE结构进行微调,可以提高训练的稳定性。
如何选择适合的MoE模型与服务
面对市场上琳琅满目的MoE模型,企业和个人开发者该如何选择?以下是一些实用的建议。
评估模型性能与成本
在选择模型时,不能只看参数量,更要关注实际推理速度和准确率,建议通过以下维度进行评估:
- 基准测试得分:参考MMLU、HumanEval等权威基准测试的结果。
- 推理延迟:在真实业务场景下,测量首字生成时间和整体响应时间。
- 单位算力成本
:计算每生成1000个Token所需的费用,对比不同模型的性价比。
关注厂商的技术支持与服务
MoE模型的部署和维护需要一定的技术门槛,选择提供完善技术支持的厂商,可以降低运维难度。
据工信部数据,近年来国内多家云服务商推出了优化的MoE推理引擎,显著提升了部署效率,对于中小企业来说,使用这些托管服务可能比自建集群更具成本优势。
考虑可扩展性与未来兼容性
技术迭代迅速,选择具有良好扩展性的模型架构,可以确保未来能够轻松接入新的专家或升级模型版本。
在选型时,应优先选择开源生态完善、社区活跃的模型,以便获取最新的技术支持和工具链。
常见问题解答(MoE路由)
MoE模型相比传统稠密模型,在推理速度上具体快多少?
MoE模型的推理速度提升取决于激活的专家数量和模型的具体实现,在多数情况下,由于只有部分参数被激活,MoE模型在相同算力下可以实现较大比例的速度提升,具体数值因模型规模和硬件配置而异,但通常能显著降低延迟,提升用户体验。
MoE架构是否会导致模型知识碎片化,影响回答的一致性?
不会,门控网络的设计目标就是确保不同专家之间的知识能够互补而非冲突,通过统一的输出层和训练过程中的对齐优化,MoE模型能够保持回答的一致性和连贯性,分工明确往往能让回答更加精准和专业。
中小企业是否有必要自建MoE模型,还是直接使用API服务更划算?
对于大多数中小企业而言,直接使用API服务是更经济高效的选择,自建MoE模型需要昂贵的GPU集群和专业的算法团队,投入产出比往往不高,除非有极高的数据隐私要求或特殊的定制化需求,否则云端API服务在成本、性能和稳定性上更具优势。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/403779.html

评论列表(1条)
莫名戳到,以前觉得知识越多越厉害,现在才懂有时候“放弃”也是一种智慧,懂吗。