LM Studio是目前最适合个人电脑本地运行大模型的工具,它无需编程基础即可实现隐私安全的AI交互,且完全免费。
在数据泄露频发和云端API成本高昂的背景下,越来越多的开发者、研究人员以及普通用户开始转向本地部署大语言模型,这种趋势并非偶然,而是对数据主权和计算自主权的回归,LM Studio凭借其直观的图形界面和强大的底层兼容性,成为了这一领域的标杆产品,它打破了大型语言模型必须依赖高性能服务器或复杂代码环境的壁垒,让普通用户也能在消费级硬件上体验前沿AI技术。
LM Studio本地运行大模型教程:核心优势与场景解析
为什么选择LM Studio而不是其他工具?业内专家指出,易用性与兼容性的平衡是用户留存的关键,许多替代方案虽然功能强大,但需要用户具备Python环境配置、Git克隆代码以及处理依赖冲突的能力,这对非技术背景用户构成了巨大门槛,LM Studio则通过“开箱即用”的设计,将复杂的模型加载过程封装在简单的点击操作中。
隐私保护与数据主权
在金融、法律或医疗等敏感行业,数据出境或上传至第三方云端服务往往面临合规风险,本地运行意味着所有推理过程都在你的硬件上完成,数据从未离开过你的设备,这种隔离性不仅满足了GDPR等严格的数据保护法规,也为个人用户提供了心理安全感。
离线可用性与成本控制
云端API通常按Token计费,对于高频使用者而言,长期成本不可控,网络波动可能导致服务中断,LM Studio支持离线运行,一旦模型下载完毕,无论身处何地均可使用,对于预算有限的学生或独立开发者,这种一次性获取模型文件的方式,极大地降低了使用门槛。
LM Studio本地运行大模型教程:环境准备与模型选择
在开始之前,了解硬件需求至关重要,虽然LM Studio优化良好,但大模型的运行对内存(RAM)和图形处理器(GPU)仍有较高要求。
硬件配置建议
- 内存(RAM):建议至少16GB,若运行70B参数级别的模型,可能需要32GB或更高。
- 图形处理器(GPU):NVIDIA显卡支持CUDA加速,效率最高,Apple Silicon(M1/M2/M3系列)芯片由于统一内存架构,也能提供出色的推理速度,且能效比优于传统PC。
- 存储空间:模型文件通常较大,建议预留50GB以上的SSD空间,以确保快速读取。
模型格式与选择策略
LM Studio主要支持GGUF格式的模型,这是一种量化格式,能在保持模型智能水平的同时,显著减小体积并降低显存占用。
- Q4_K_M量化:平衡了速度与质量,适合大多数日常任务,是LM Studio推荐模型格式的首选。
- Q8_0量化:精度更高,但占用资源更多,适合对准确性要求极高的场景。
- FP16原始格式:精度最高,但体积巨大,通常仅用于微调或研究,不推荐普通用户日常使用。
在模型选择上,Hugging Face是主要的模型仓库,用户可以在LM Studio内置的搜索栏中直接输入模型名称,如”Llama 3″、”Mistral”或”Qwen”,系统会自动索引并展示可用的量化版本。
LM Studio本地运行大模型教程:实操步骤详解
以下是从安装到首次对话的完整流程,整个过程无需命令行操作,完全通过图形界面完成。
第一步:下载与安装
访问LM Studio官网,根据你的操作系统(Windows、macOS或Linux)下载对应版本,安装过程与普通软件无异,注意勾选“添加到桌面快捷方式”以便快速启动。
第二步:搜索与下载模型
- 打开LM Studio,点击左侧边栏的“搜索”图标(放大镜形状)。
- 在搜索框中输入你想要的模型名称,Llama-3-8B-Instruct”。
- 在搜索结果中,寻找由可信组织(如Meta、Microsoft、Qwen团队)发布的模型。
- 点击模型卡片,进入详情页,你会看到多个量化版本。
- 选择适合你硬件的版本(Q4_K_M”),点击“Download”按钮。
- 等待下载完成,进度条显示100%即表示模型已加载至本地缓存。
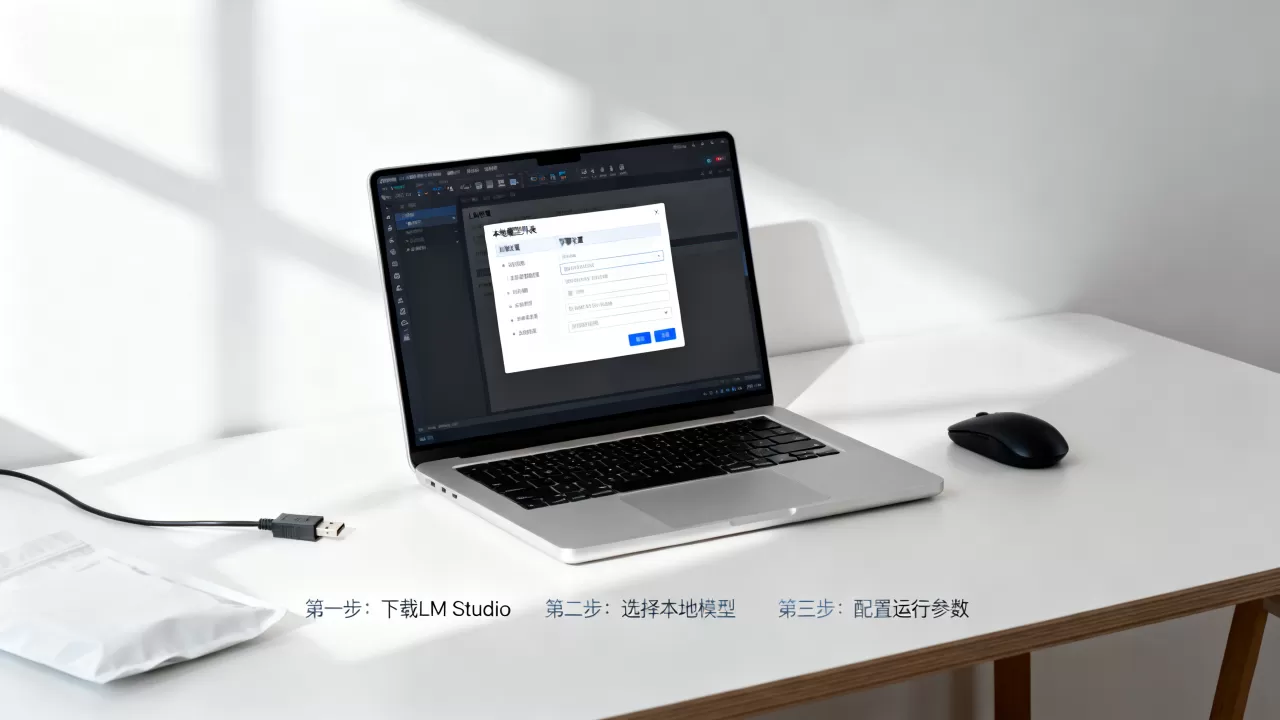
第三步:配置推理参数
模型下载完成后,切换到“Chat”标签页,右侧的设置面板允许你微调模型行为。
- Temperature(温度):控制输出的随机性,0.7左右适合创意写作,0.2左右适合事实性问答。
- Context Length(上下文长度):决定模型能记住多少前文,默认通常为4096,若需处理长文档,可调整为8192或更高,但这会显著增加内存占用。
- GPU Offload(GPU卸载):这是性能优化的关键,滑块允许你指定多少层网络层由GPU处理,若显存充足,建议拉至最大值,以最大化推理速度。
第四步:开始对话
在左侧聊天窗口输入你的问题,点击发送,LM Studio会显示推理速度(Tokens per second),初次运行可能较慢,因为模型需要加载到内存中,后续对话将显著提速。
LM Studio本地运行大模型教程:常见问题与优化技巧
在实际使用中,用户可能会遇到性能瓶颈或兼容性问题,以下针对LM Studio本地运行大模型教程中常见痛点提供解决方案。
如何解决内存溢出(OOM)错误?
如果运行较大模型时出现崩溃,通常是因为显存或内存不足。
- 降低量化等级:从Q8降级到Q4或Q3,虽然损失少量精度,但能大幅节省资源。
- 减少上下文长度:缩短最大Token数,减少内存峰值占用。
- 关闭其他应用:确保没有其他大型程序(如浏览器标签页、视频软件)占用GPU资源。
如何提升推理速度?
速度是本地部署的核心体验指标。
- 启用GPU加速
:确保在设置中正确识别并启用了你的GPU,对于NVIDIA用户,需安装CUDA Toolkit;对于Mac用户,系统会自动优化Metal加速。
- 使用专用推理后端:LM Studio支持多种后端引擎,在设置中尝试切换“llama.cpp”或“Metal”后端,观察哪个在你的硬件上表现更佳。
- 保持驱动更新:最新的显卡驱动通常包含针对AI推理的性能优化补丁。
模型更新与维护
大模型领域迭代迅速,新模型不断涌现,LM Studio支持模型库的自动更新,你可以定期检查“Library”标签页,查看是否有新发布的量化版本或更高效的模型架构,建议关注主流开源社区,如Hugging Face Trending,以获取最新的高质量模型信息。
LM Studio本地运行大模型教程:Q&A模块
LM Studio本地运行大模型教程支持哪些操作系统?
LM Studio目前全面支持Windows 10/11、macOS(包括Intel和Apple Silicon芯片)以及主流Linux发行版,不同操作系统的安装方式略有差异,但核心功能一致,Windows用户需注意显卡驱动兼容性,macOS用户则需确保系统版本在13.0以上以充分利用Metal加速。
LM Studio本地运行大模型教程免费吗?
是的,LM Studio的核心软件完全免费,包括模型搜索、下载和推理功能,它采用开源核心加商业支持的商业模式,用户无需支付订阅费即可使用所有基础AI功能,对于高级企业级功能或优先技术支持,官方提供付费服务,但个人用户无需为此付费。
LM Studio本地运行大模型教程的模型来源是否安全?
LM Studio内置的模型库主要索引自Hugging Face等知名开源社区,这些模型通常经过严格审查,用户也可自行导入外部GGUF文件,为确保安全,建议仅从官方发布者或高信誉机构下载模型,并在使用前扫描文件病毒,模型本身不包含恶意代码,但需警惕来源不明的第三方修改版模型可能存在的后门风险。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/402282.html