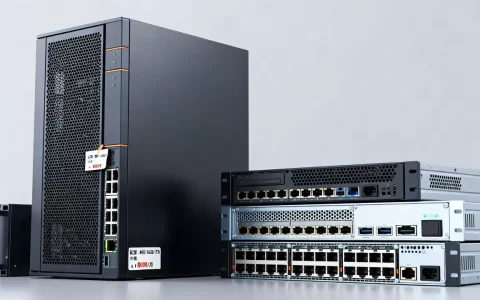
大模型部署对CPU的核心要求在于拥有充足的内存带宽和核心数量,通常建议单节点配备至少128GB至512GB以上的高频内存,并优先选择支持AVX-512指令集的多核处理器,以弥补GPU缺失时的算力短板。
当我们在讨论大模型部署时,大多数人第一反应是昂贵的GPU集群,随着模型量化技术的成熟和边缘计算场景的普及,纯CPU部署或CPU-GPU混合部署正成为许多企业降低成本、提升灵活性的首选方案,这种转变并非盲目跟风,而是基于硬件性能瓶颈的理性选择,CPU在处理逻辑控制、数据预处理以及轻量级推理任务上具有天然优势,但其短板也显而易见:内存带宽不足和并行计算能力弱于专用加速卡,理解CPU在大模型生态中的真实定位,是构建高效部署架构的第一步。
CPU在大模型推理中的角色定位与性能瓶颈
业内专家指出,大模型推理本质上是一个巨大的矩阵乘法运算过程,GPU之所以强大,是因为它拥有成千上万个流式多处理器,专为并行计算设计,相比之下,CPU的核心数量较少,但单核频率高、逻辑复杂度高,在纯CPU环境下运行大模型,主要面临两个核心挑战。
内存带宽成为最大瓶颈
大模型参数量巨大,例如一个70亿参数的模型,即使采用INT8量化,也需要约7GB的显存或内存空间;而FP16精度下则需14GB,当模型加载到CPU内存中时,数据读取速度直接决定了推理延迟。
- 内存通道数量:普通消费级主板通常只有双通道内存,而服务器级CPU支持四通道甚至八通道内存,通道越多,理论带宽越高。
- 内存频率:高频内存(如DDR5-4800或更高)能显著提升数据吞吐率。
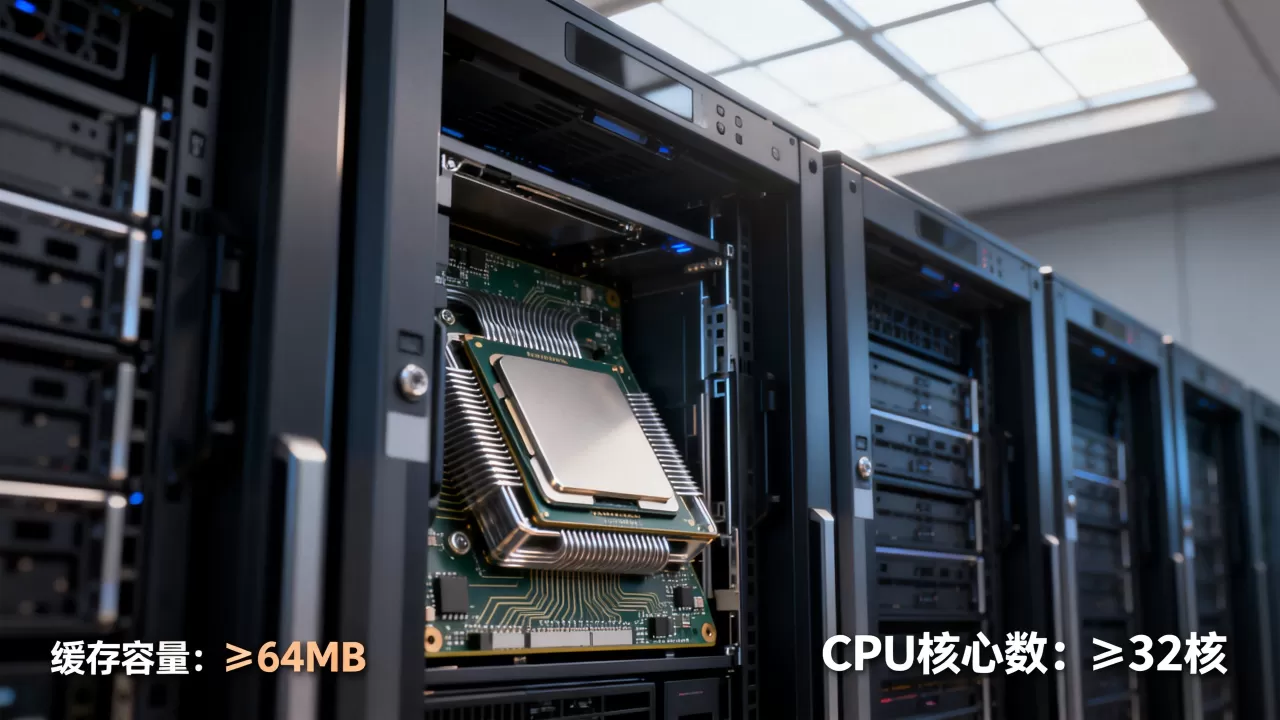
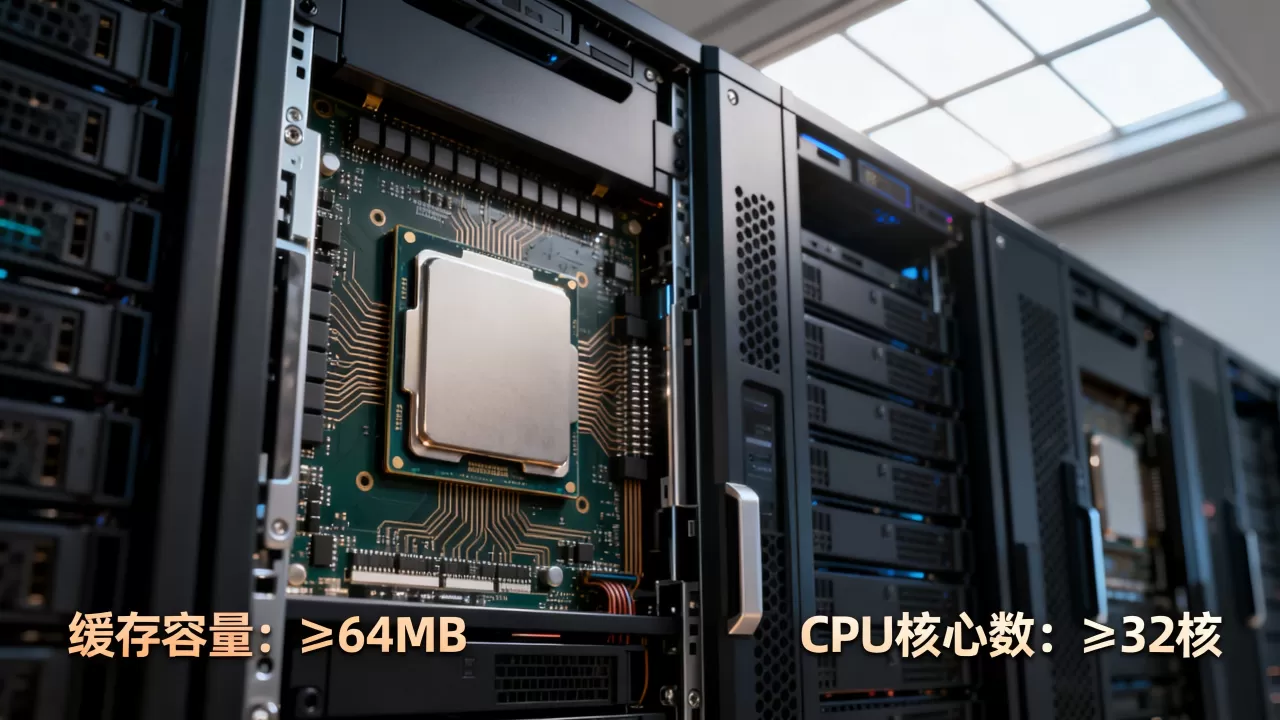
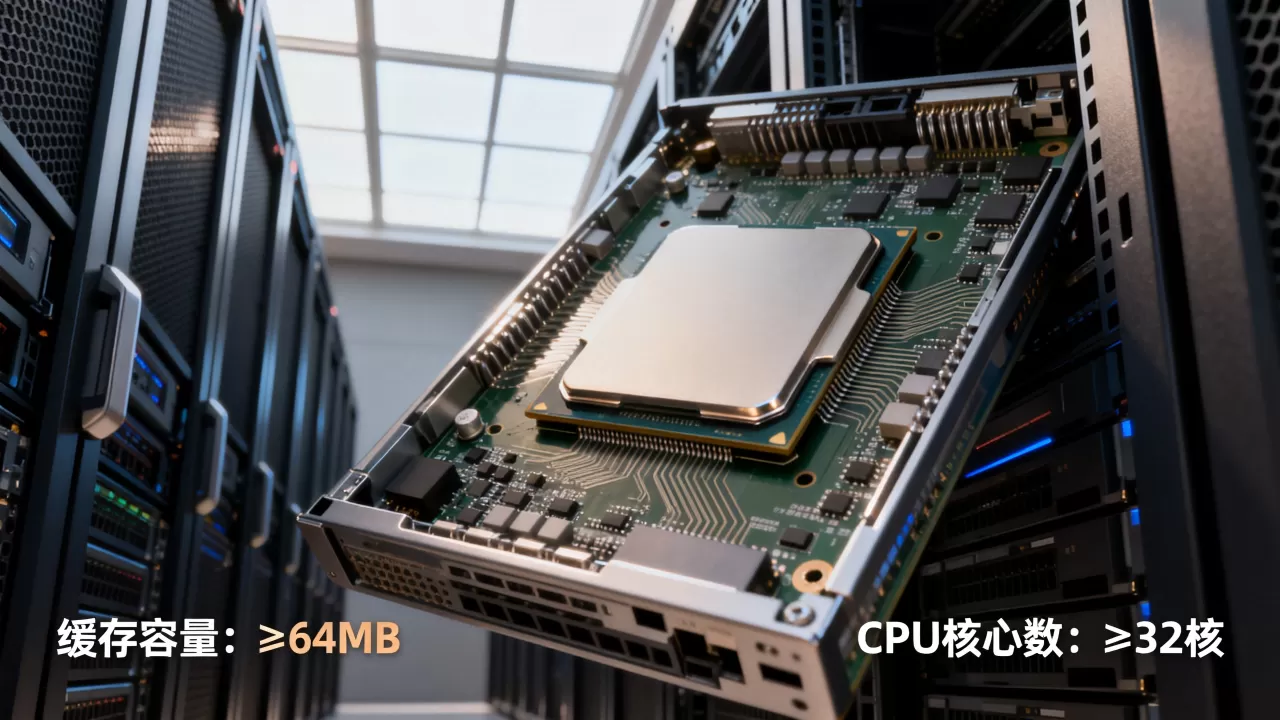
- 缓存大小:L3缓存较大的CPU能减少访问主存的次数,从而降低延迟。
如果内存带宽不足,CPU核心再强,也只能“饿着肚子”等待数据,导致推理速度极慢,甚至不如低端GPU。
指令集架构的影响
不同的指令集对矩阵运算的支持力度不同,x86架构中的AVX-512指令集能够在一个时钟周期内处理更宽的数据向量,显著加速浮点运算,ARM架构的NEON指令集在移动端和嵌入式设备上表现优异,但在大规模服务器部署中,x86生态的兼容性更好。
选型指南:大模型部署CPU配置建议
针对不同规模的部署需求,CPU的配置策略截然不同,这里我们对比几种典型场景,帮助你做出精准选择。
边缘端与个人开发者:轻量级模型的本地化
对于运行7B以下参数量的量化模型(如Llama-3-8B-INT4),对CPU要求相对宽松,但内存容量是关键。
- 核心数:8核16线程起步,如Intel Core i7或AMD Ryzen 7系列。
- 内存:必须32GB以上,建议64GB,因为模型权重、KV缓存以及操作系统本身都会占用大量内存。
- 指令集:支持AVX2或AVX-512更佳。
- 适用场景:本地知识库问答、个人助手、小型文档处理。
企业级私有化部署:高并发与低延迟
当需要支持多用户并发访问,或运行70B以上的大模型时,必须使用服务器级CPU。
- 核心数:建议32核以上,如Intel Xeon Scalable或AMD EPYC系列,核心越多,能并行的推理请求越多。
- 内存:256GB起步,推荐512GB或更高,大模型权重加载需要巨大空间,且KV缓存随上下文长度线性增长。
- 内存带宽:选择支持四通道或八通道内存的主板,并搭配高频DDR5 ECC内存。
- PCIe通道数:确保有足够的PCIe通道连接GPU或高速网卡,避免IO瓶颈。
混合部署架构:CPU与GPU的协同
在大多数生产环境中,CPU并不单独承担推理任务,而是作为“指挥官”协调GPU。
-
数据预处理:CPU负责文本清洗、Tokenization、数据增强等串行任务。
- 调度管理:CPU负责请求路由、负载均衡和上下文管理。
- 模型卸载:当显存不足时,部分层可以卸载到CPU内存中,通过PCIe总线交换数据,CPU的内存带宽和PCIe带宽至关重要。
优化策略:提升CPU推理效率的实操步骤
选对了硬件,还需要软件层面的优化才能发挥最大效能,以下是经过验证的优化路径。
使用专为CPU优化的推理引擎
通用框架如Hugging Face Transformers在CPU上运行效率较低,建议采用以下工具:
- llama.cpp:基于C++编写,支持GGUF格式量化模型,对CPU缓存和指令集优化极佳,是目前CPU推理的主流选择。
- ONNX Runtime:微软推出的高性能推理引擎,支持图优化和算子融合,能显著提升CPU上的执行速度。
- OpenVINO:英特尔官方工具包,针对Intel CPU和GPU进行深度优化,特别适合Intel硬件平台。
模型量化与剪枝
量化是将模型权重从FP16(16位浮点数)转换为INT8(8位整数)甚至INT4的过程。
- 效果:模型体积缩小4-8倍,内存占用大幅降低,推理速度提升2-4倍。
- 精度损失:对于大多数应用,INT4量化带来的精度损失在可接受范围内(准确率下降通常低于1%)。
- 操作:使用llama.cpp的quantize工具或ONNX Runtime的量化插件,将模型转换为适合CPU运行的格式。
批处理与动态批处理
CPU单线程处理能力有限,但多线程并行能力强。
- 静态批处理:将多个请求打包成一个批次同时处理,提高GPU利用率,但在纯CPU场景中,过大的批次会导致单个请求延迟增加。
- 动态批处理:根据当前系统负载动态调整批次大小,平衡吞吐量与延迟。
- KV缓存优化:复用相同前缀的KV缓存,减少重复计算,特别适用于对话场景。
常见问题解答:大模型部署CPU相关疑问
大模型部署CPU需要多少钱?
成本取决于部署规模,对于个人开发者,一台配备64GB内存的消费级台式机(约5000-8000元)即可运行7B量化模型,对于中小企业,一台双路服务器CPU(如AMD EPYC 7003系列,约2-5万元)搭配512GB内存(约1-2万元),总成本控制在5-10万元,即可支持中等规模的企业级私有化部署,相比动辄数十万元的GPU集群,CPU方案在初期投入上具有显著优势,尤其适合预算有限但对数据隐私要求高的场景。
大模型部署CPU和GPU有什么区别?
核心区别在于并行计算能力和内存带宽,GPU拥有数千个核心,专为大规模并行矩阵运算设计,适合高吞吐量的推理任务,但显存昂贵且容量有限,CPU核心少但单核性能强,擅长逻辑控制和串行任务,内存容量大且成本低,适合处理大上下文、低并发或对延迟不敏感的场景,多数情况下,企业会选择GPU处理核心推理,CPU处理辅助任务,形成互补。
大模型部署CPU需要多少内存?
内存容量是硬性指标,计算公式大致为:内存需求 = 模型参数量 × 每参数字节数 + KV缓存 + 系统开销,以7B模型为例,INT8量化后权重约7GB,加上KV缓存和系统开销,建议至少16GB内存,但为了流畅体验,推荐32GB,对于70B模型,INT4量化后权重约35-40GB,建议内存128GB起步,若需长上下文支持,则需256GB或更高,内存不足会导致频繁的磁盘交换,使推理速度降至不可用水平。
大模型部署对CPU的要求并非遥不可及,关键在于精准匹配场景需求,通过合理选型、量化优化和引擎调优,CPU完全能够胜任从边缘端到企业级的多种部署任务,成为大模型落地的重要基石。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/402234.html