苹果统一内存架构通过让CPU和GPU共享同一块高速内存池,彻底消除了数据在处理器间复制的瓶颈,使得Mac设备能以极低的功耗和成本流畅运行百亿参数级的大语言模型,这是传统Windows PC难以比拟的核心优势。
统一内存架构如何重塑大模型本地部署体验
打破显存墙:告别显存焦虑
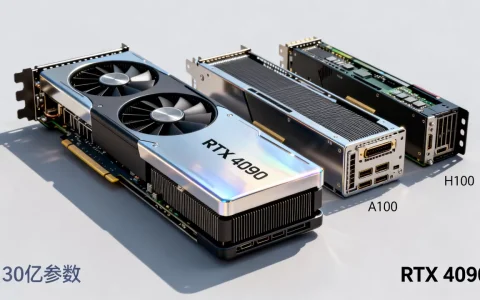
在传统PC架构中,CPU负责逻辑运算,GPU负责图形渲染,两者各自拥有独立的内存,当你在本地运行大模型时,模型权重需要从系统内存加载到显卡显存中,如果显存不足,模型就会加载失败,或者被迫使用速度极慢的磁盘交换文件。
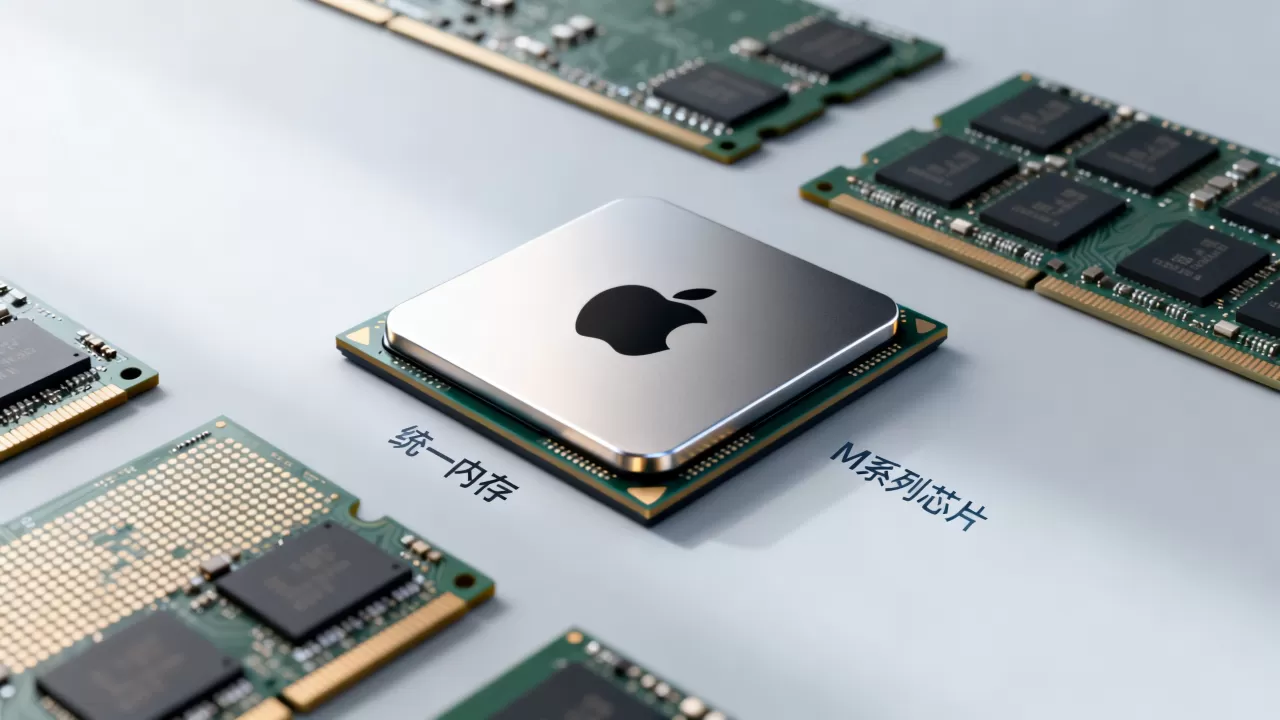
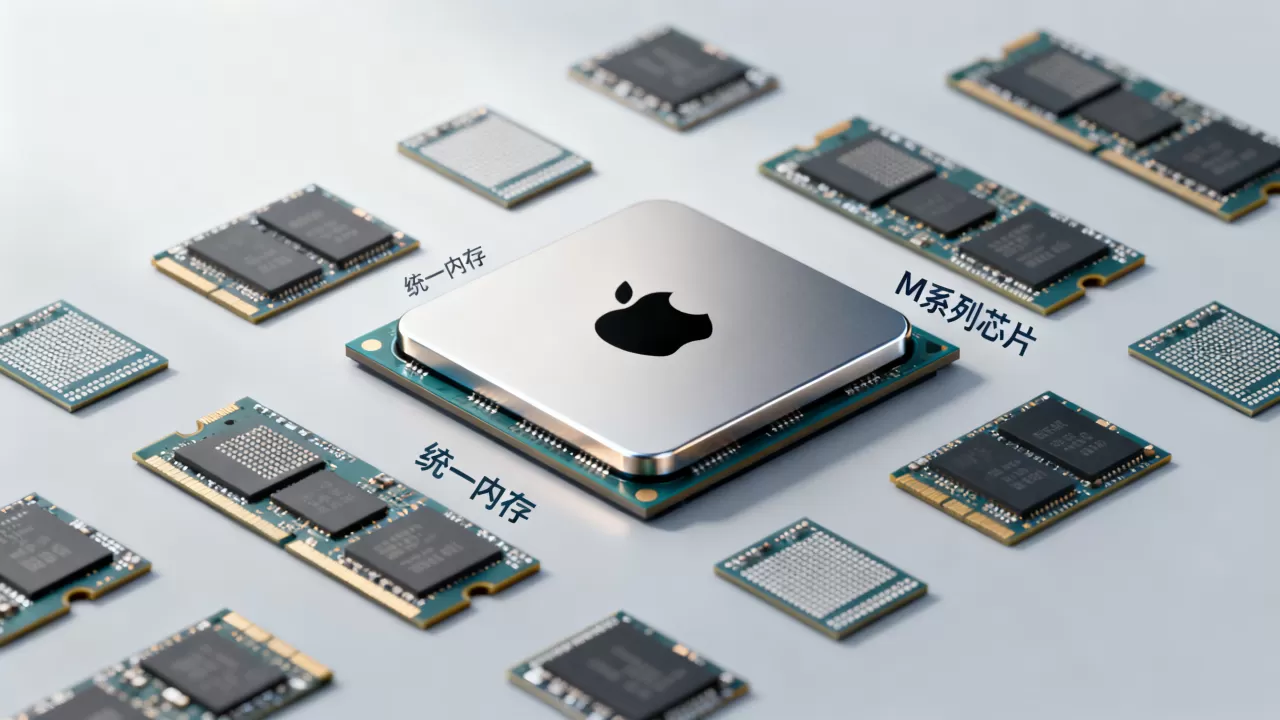
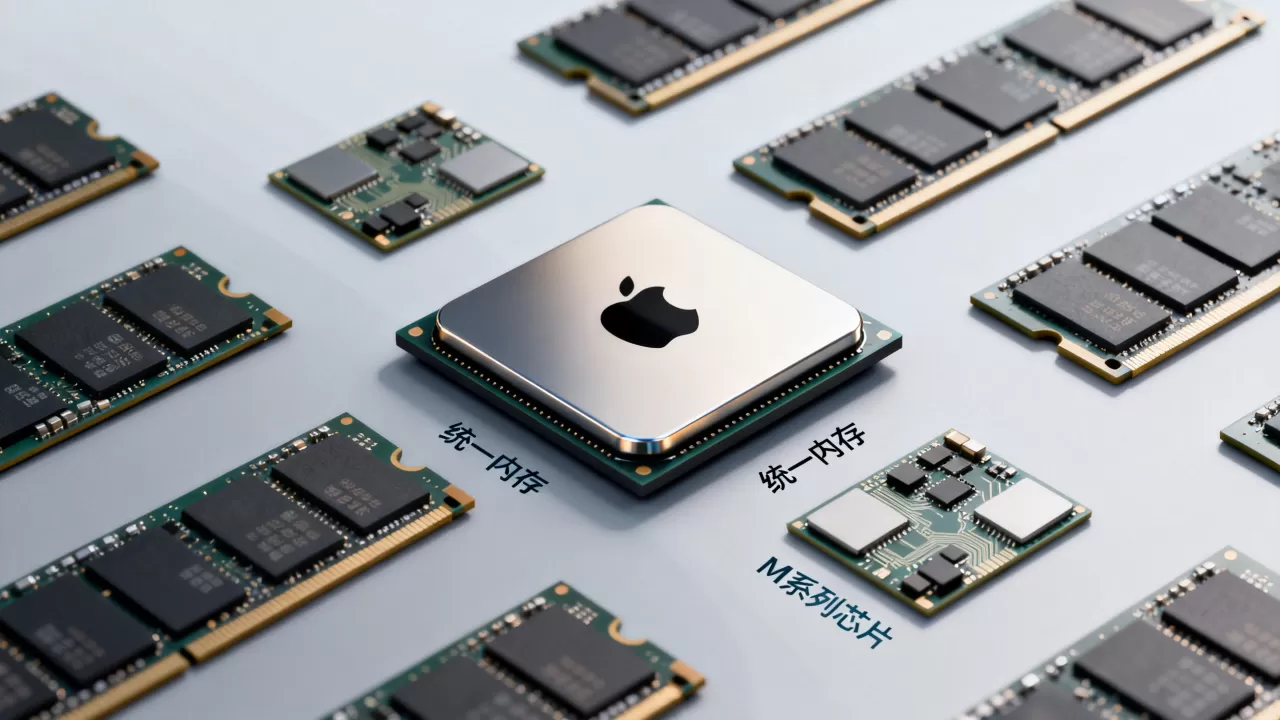
苹果的统一内存架构(Unified Memory Architecture, UMA)从根本上解决了这个问题,在M系列芯片的Mac电脑上,内存不再是分割的,而是由CPU、GPU和神经网络引擎共享,这意味着,如果你有一台配备64GB统一内存的Mac Studio,GPU可以直接访问这64GB中的大部分空间作为显存使用。
业内专家指出,这种设计让大模型的加载不再受限于独立显卡的物理显存大小,对于想要本地部署Llama 3或Qwen等大模型的开发者来说,这意味着无需购买昂贵的高显存专业显卡,只需关注整机的内存容量即可。
零拷贝技术:提升推理速度
数据搬运是大模型推理中的隐形杀手,在传统架构中,数据需要在CPU内存和GPU显存之间反复拷贝,这不仅消耗时间,还占用带宽,苹果的统一内存允许CPU和GPU直接访问同一物理地址空间,实现了“零拷贝”传输。
这种机制带来的直接好处是推理延迟的显著降低,在处理长上下文窗口时,数据量的激增会让传统架构的带宽瓶颈暴露无遗,而统一内存架构则能保持稳定的吞吐量。
实际场景对比
- 传统PC方案:加载13B参数模型,需将数据从DDR5内存复制到GDDR6显存,耗时约10-15秒,且受限于8GB或12GB显存上限,无法加载更大模型。
- Mac方案:模型直接映射到统一内存,GPU即时读取,加载时间缩短至3-5秒,且可轻松加载70B参数以上的量化模型。
为什么苹果Mac是个人开发者的大模型首选
能效比碾压:静音且不发烫
大模型推理是计算密集型任务,传统高性能PC在运行此类任务时,风扇会狂转,功耗高达数百瓦,甚至需要外接散热底座,相比之下,搭载M系列芯片的Mac在运行相同负载时,整机功耗通常控制在30W到60W之间。
这种极高的能效比意味着你可以在安静的办公室或家中,全天候运行本地大模型助手,而无需忍受噪音和高温,对于需要7×24小时运行本地知识库索引的开发者而言,这种稳定性至关重要。
生态兼容性:开箱即用的优化
苹果对自家硬件的软件栈拥有绝对的控制权,Metal Performance Shaders (MPS) 框架为大模型推理提供了底层加速支持,主流的大模型框架如Ollama、LM Studio以及Python的MLX库,都对Mac进行了深度优化。
这意味着用户无需手动配置复杂的CUDA环境,也无需担心驱动冲突,安装软件后,系统会自动识别并使用统一内存进行加速,这种“开箱即用”的体验,极大地降低了大模型本地部署的技术门槛。
价格优势:高性价比的专业算力
在Windows阵营,要实现同等内存容量的本地大模型部署,通常需要搭配高端CPU和拥有24GB以上显存的专业级显卡,整机成本往往超过2万元,而一台配置32GB或64GB统一内存的MacBook Pro或Mac Mini,价格可能仅为前者的一半甚至更低。
据统计,多数个人开发者和小型团队更倾向于选择这种集成度高、维护成本低的解决方案,Mac Mini M4版本更是以相对亲民的价格,提供了足以运行中等规模大模型的算力基础,成为入门级本地AI部署的高性价比之选。
实操指南:如何在Mac上高效运行大模型
第一步:选择合适的模型格式
为了充分利用统一内存,建议选择经过量化处理的模型格式,GGUF格式是目前最通用的选择,它支持在CPU和GPU之间灵活分配计算层。
- 推荐模型:Llama-3-8B-Instruct-Q4_K_M.gguf 或 Qwen2.5-7B-Instruct-Q4_K_M.gguf。
- 量化等级:Q4_K_M在保持较高精度的同时,能显著减少内存占用,适合大多数消费级Mac设备。
第二步:部署推理引擎
推荐使用Ollama或LM Studio,这两个工具对Mac的支持最为完善。
- 安装Ollama:访问官网下载Mac版本安装包,双击安装即可。
- 拉取模型:打开终端,输入命令
ollama run llama3,系统将自动下载并启动模型。 - 验证性能:在对话界面输入复杂指令,观察首字生成速度(TTFT)和后续生成速度(tokens/s)。
第三步:优化系统设置
- 关闭后台应用:在运行大型模型前,关闭浏览器、视频编辑软件等高内存占用应用,确保有充足的统一内存可供模型使用。
- 启用Metal加速:在LM Studio等软件中,确保设置中启用了Metal GPU加速选项,而非使用纯CPU推理。
常见疑问解答
苹果统一内存跑大模型有哪些具体优势
苹果统一内存跑大模型的核心优势在于打破了传统PC的显存限制,允许GPU直接访问大容量系统内存,从而能够加载更大参数的模型;零拷贝机制减少了数据搬运开销,提升了推理速度;其极高的能效比使得设备在长时间运行下保持低温静音,适合个人开发者日常使用。
Mac运行大模型相比Windows PC价格更便宜吗
在同等内存容量下,Mac通常比组装高性能Windows PC更具性价比,因为Windows方案需要单独购买高显存显卡,而Mac将内存与计算单元集成,无需额外显卡费用,对于需要32GB以上内存的本地AI部署场景,Mac的整体拥有成本通常更低,且维护成本更少。
统一内存架构是否适合所有大模型任务
统一内存架构非常适合推理阶段和中小规模的微调任务,特别是对于内存带宽敏感的应用,对于需要极致训练速度或超大规模分布式训练的企业级任务,传统多GPU集群仍具有优势,但对于个人开发者、研究人员以及需要本地隐私保护的场景,Mac的统一内存架构提供了最佳平衡点。
苹果统一内存架构通过硬件与软件的深度协同,为大模型本地化部署开辟了一条高效、低成本的新路径,它让普通用户也能轻松拥有接近专业服务器的AI算力,真正实现了人工智能的普惠化,随着模型规模的不断扩大,这一架构的优势将更加凸显。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/401405.html