

大模型分布式推理的核心在于通过模型并行、数据并行及流水线并行技术,将庞大的计算任务拆解并分发至多张GPU或集群节点,从而在降低延迟的同时显著提升吞吐量,解决单机显存不足与算力瓶颈问题。
随着生成式AI从概念验证走向大规模落地,单体GPU的显存墙和算力墙已成为制约大模型实时响应的最大障碍,业内专家指出,单卡推理已无法满足千亿参数模型的实时服务需求,分布式推理不再是“可选项”,而是企业级应用的“必选项”,它不仅仅是硬件的堆砌,更是软件栈、通信协议与调度算法的深度协同。
分布式推理的核心架构与并行策略解析
要理解分布式推理,首先要打破“一张卡跑所有层”的传统思维,在大模型时代,模型权重、激活值、梯度等数据量级远超单张显卡的存储极限,我们需要将模型切分,让不同的硬件单元各司其职。
张量并行:细粒度的矩阵计算拆分
张量并行(Tensor Parallelism, TP)是目前最主流的分布式策略之一,特别适用于注意力机制和前馈神经网络层,它的逻辑是将一个大矩阵乘法拆分成多个小矩阵乘法,分散到多张显卡上计算,最后汇总结果。
- 通信开销极低:由于数据在层内流动,节点间通信频率高但数据量相对可控,适合高速互联如NVLink的环境。
- 延迟敏感场景首选:在需要极低首字延迟(TTFT)的场景中,TP能有效减少单步计算时间。
- 实现复杂度适中:主流框架如DeepSpeed和Megatron-LM均提供了成熟的TP实现,开发者无需从零编写底层通信代码。
流水线并行:层级的流水线作业
当模型层数极多,单张卡甚至无法容纳单层权重时,流水线并行(Pipeline Parallelism, PP)便派上用场,它将模型的层按顺序切分,不同层分布在不同设备上,数据像流水线一样从前向后流动。
- 显存占用最小化:每张卡只需存储部分层,极大缓解了显存压力。
- 气泡问题需优化:传统PP存在“气泡”(Bubble),即部分设备空闲等待,采用GPipe或1F1B(One-Forward-One-Backward)策略可显著降低空闲率。
- 适合超大规模模型
:对于万亿参数级别的模型,PP往往是唯一可行的扩展方案。
混合并行策略的实际应用
在实际生产环境中,单一策略往往不够用,常见的做法是TP+PP+DP(数据并行)的组合,在一个8卡节点内使用TP=4,两个节点间使用PP=2,全局使用DP=2,这种混合模式能平衡显存、通信带宽和计算效率。
主流分布式推理框架对比与选型指南
面对市场上琳琅满目的推理框架,企业该如何选择?这取决于你的硬件基础、模型类型以及对延迟的敏感度。
FasterTransformer vs vLLM:性能与易用性的权衡
NVIDIA的FasterTransformer以极致性能著称,支持张量并行和流水线并行,底层经过深度CUDA优化,适合对延迟有极致要求的金融、医疗场景,它的配置复杂,需要深厚的底层调优经验。
相比之下,vLLM凭借PagedAttention技术,在显存管理和吞吐量上取得了巨大突破,它原生支持连续批处理(Continuous Batching),能动态合并不同长度的请求,显著降低显存碎片,对于大多数互联网应用,vLLM提供了更好的开箱即用体验和更高的并发处理能力。
DeepSpeed Inference:微软的生态优势
DeepSpeed Inference集成了ZeRO-Inference技术,能够自动处理模型切分和通信优化,它最大的优势在于与PyTorch生态的无缝集成,开发者无需大幅修改原有代码即可实现分布式推理,它对Intel、AMD等非NVIDIA硬件的支持更为友好,适合异构算力环境。
选型决策矩阵
| 维度 | FasterTransformer | vLLM | DeepSpeed Inference |
|---|---|---|---|
| 极致延迟优化 | 优秀 | 良好 | 一般 |
| 高并发吞吐量 | 良好 | 优秀 | 良好 |
| 开发维护成本 | 高 |
低 | 中 |
| 硬件兼容性 | 主要NVIDIA | 主要NVIDIA | 多品牌支持 |
| 适用场景 | 实时性要求极高的B端服务 | C端高并发聊天机器人 | 混合云或异构集群 |
部署实操:从单机到集群的关键步骤
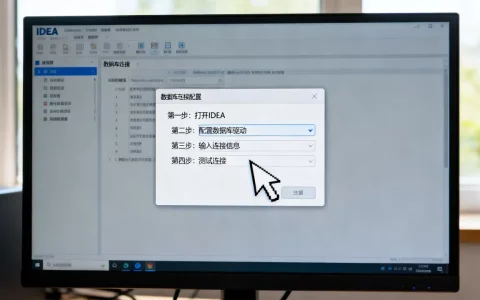
落地分布式推理并非简单的命令堆砌,而是涉及环境配置、模型加载、服务暴露的全链路工程,以下以vLLM为例,梳理标准部署路径。
环境准备与依赖安装
确保服务器安装了 compatible 的CUDA驱动和cuDNN,推荐使用Docker容器化部署,以避免环境冲突。
- 基础镜像选择:使用
nvcr.io/nvidia/pytorch作为基础镜像,预装常用库。 - 依赖安装:通过
pip install vllm安装推理引擎,注意版本需与CUDA版本匹配。 - 网络配置:若为多节点部署,需确保节点间通过RDMA或高速以太网互联,并关闭防火墙相关端口。
模型加载与并行配置
启动服务时,关键参数决定了分布式行为。
- –tensor-parallel-size:设置TP大小,如
--tensor-parallel-size 4表示使用4张卡并行计算单层。 - –pipeline-parallel-size:设置PP大小,如
--pipeline-parallel-size 2表示模型层分2组。 - –gpu-memory-utilization:控制显存使用比例,建议设为0.9,预留少量空间防止OOM。
服务暴露与负载均衡
启动后,服务默认监听8000端口,在生产环境中,需配合Nginx或Kubernetes Ingress进行负载均衡,对于分布式集群,建议使用Kubernetes Operator自动管理Pod的生命周期和弹性伸缩。
性能调优与常见陷阱规避
部署完成只是第一步,调优才能释放硬件潜能。
显存碎片化与OOM处理
长文本推理容易导致显存碎片化,vLLM的PagedAttention虽能缓解此问题,但仍需监控显存使用率,若出现OOM,可尝试减小batch size或启用量化技术(如INT8/FP8),在精度损失可接受范围内换取显存空间。
通信瓶颈的识别与解决
分布式推理的性能瓶颈往往不在计算,而在通信,若发现GPU利用率低且延迟高,需检查NCCL通信库版本及网络带宽,使用nccl-tests进行基准测试,确保网络吞吐满足需求,对于跨机架部署,务必启用RDMA,否则通信延迟将抵消并行带来的收益。
量化技术的最佳实践
近年来,INT8和FP8量化成为主流趋势,据工信部数据,采用FP8量化可使推理速度提升近一倍,同时显存占用减半,但需注意,量化并非万能,对于逻辑推理要求极高的任务,建议保留FP16/BF16精度,或采用混合精度训练后的推理优化。
大模型分布式推理常见问题解答
分布式推理与模型微调有什么区别?
分布式推理专注于“运行”阶段,旨在高效执行预训练好的模型,核心目标是降低延迟、提高吞吐量,不涉及模型权重的更新,而模型微调(Fine-tuning)发生在“训练”阶段,目的是让模型适应特定领域数据,需要反向传播更新权重,对显存和计算资源的需求更为复杂,通常涉及梯度同步和状态保存,两者虽都可用分布式技术,但优化目标和实现路径截然不同。
如何评估分布式推理系统的扩展性?
评估扩展性主要看线性加速比和显存扩展效率,线性加速比指增加GPU数量后,吞吐量是否成比例增加,理想情况下,8卡吞吐应为1卡的8倍,但由于通信开销,实际通常在6-7倍左右,显存扩展效率则关注模型参数量增加时,所需GPU数量是否线性增长,若通信开销过大导致加速比低于1.5,则说明架构存在瓶颈,需优化并行策略或升级互联硬件。
分布式推理的成本效益如何计算?
成本效益需综合硬件采购、电力消耗、运维人力及业务收益计算,虽然分布式集群初期投入较高,但通过提高并发处理能力,可显著降低单次请求的平均算力成本,将延迟从500ms降至100ms,可能带来用户留存率的大幅提升,据行业共识认为,当并发请求超过一定阈值(如每秒数千次)时,分布式推理的边际成本远低于单机推理,且能更好地应对流量峰值,避免服务降级。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/396946.html

评论列表(1条)
讲真啦,这方案是香,但成本太高了。咱们小店够用就得,别整那些花架子,钱包遭不住啊!