大模型部署故障告警配置的核心在于建立从底层资源监控到上层业务语义异常的多维感知体系,通过实时捕捉Token延迟、显存溢出及逻辑幻觉等关键指标,实现从“事后救火”到“事前预警”的转变。
在2026年的AI工程化落地场景中,大模型服务的高可用性已不再是可选项,而是企业数字化转型的底线,许多团队在初期往往只关注模型的推理准确率,却忽视了生产环境中的稳定性监控,导致一旦遇到流量洪峰或长尾场景,系统便陷入瘫痪,配置一套科学的故障告警机制,本质上是给大模型服务装上一套“神经系统”,让它能自我感知疼痛并迅速反馈。
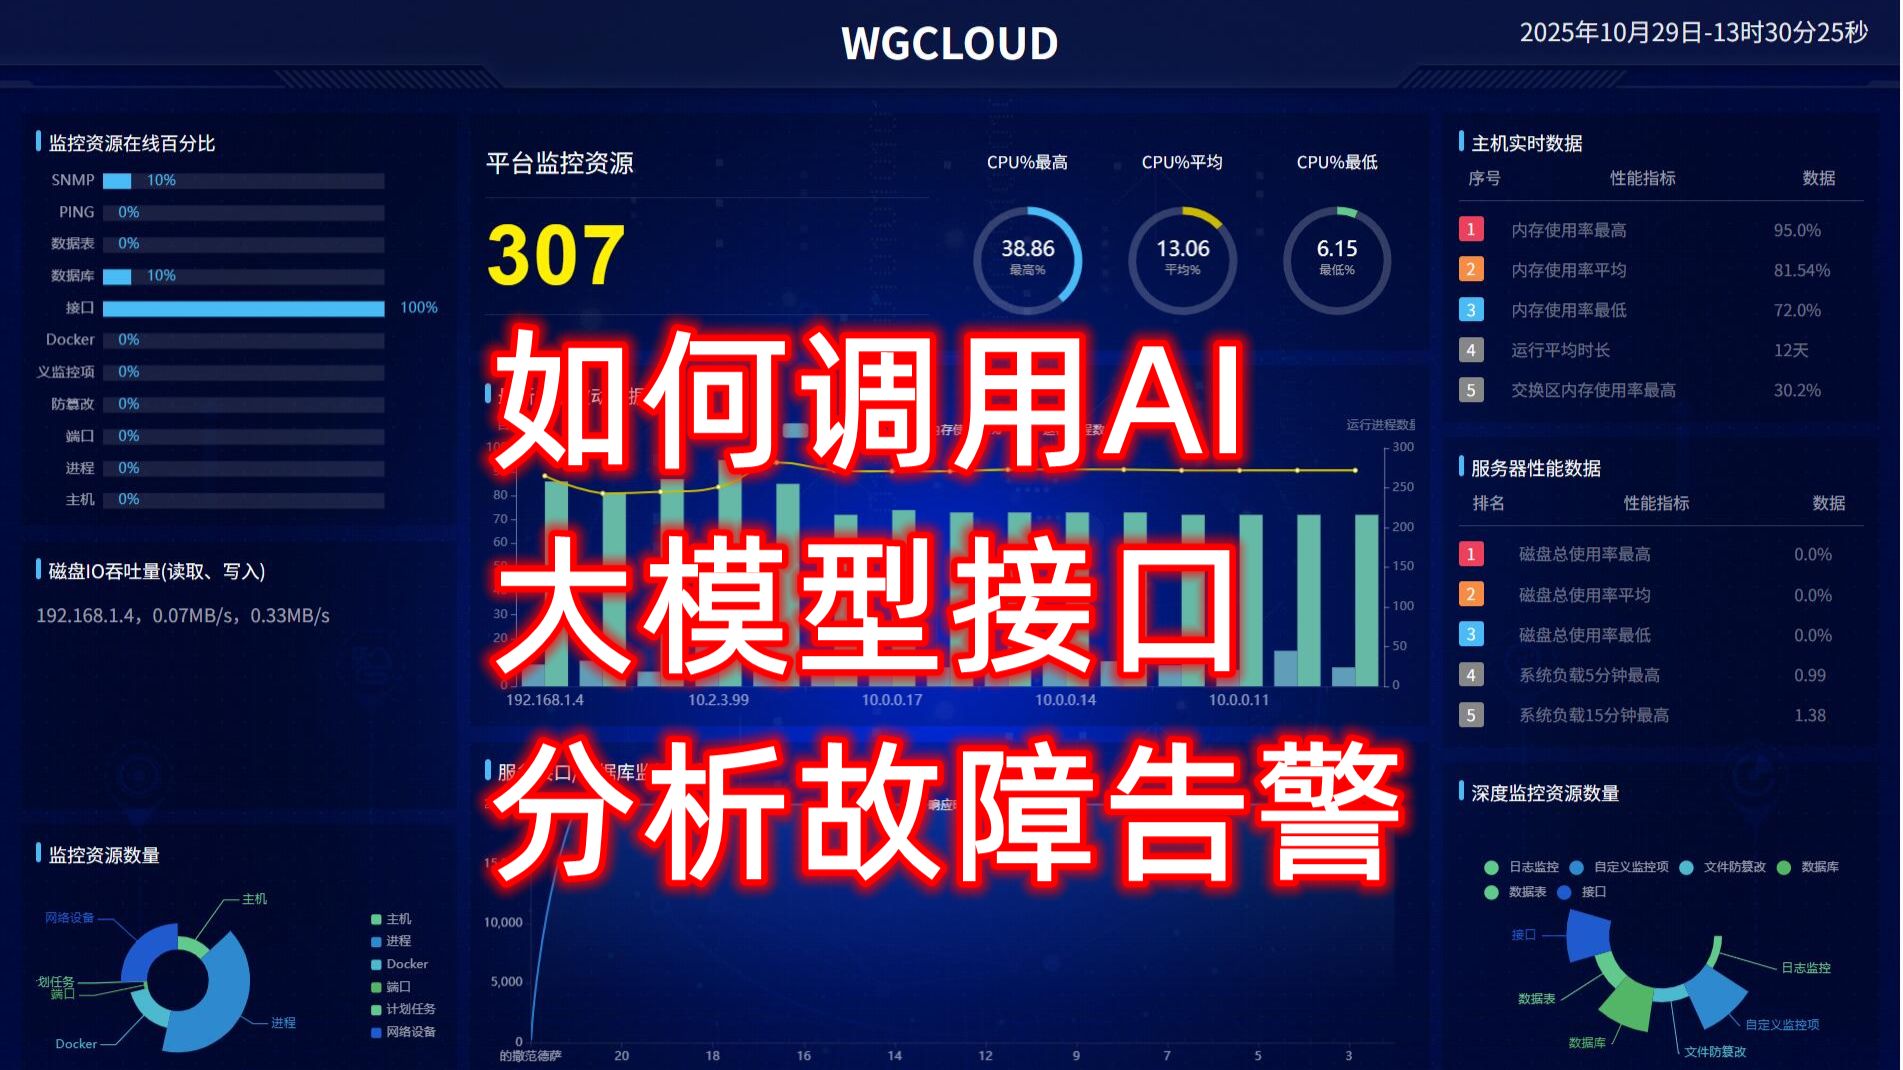

大模型部署故障告警配置的关键指标体系
要构建有效的告警系统,首先必须明确“什么需要被监控”,大模型与传统微服务不同,其资源消耗具有高度波动性,且推理过程涉及复杂的向量计算,业内专家指出,传统的CPU利用率监控已不足以反映大模型的真实健康状态,必须引入更具针对性的维度。
基础设施层监控:显存与算力瓶颈
大模型部署最直接的痛点在于GPU资源的独占性与高负载,当并发请求激增时,显存溢出(OOM)是导致服务崩溃的头号原因。
- 显存占用率:这是最基础的指标,建议设置阈值,当显存使用率超过85%时触发中级告警,超过95%时触发紧急告警。
- GPU利用率:监控GPU核心频率和计算单元活跃度,如果利用率长期低于30%,可能意味着存在I/O阻塞或数据加载瓶颈;若长期处于100%且响应时间拉长,则说明算力已达极限。
- 温度与功耗:虽然较少直接导致宕机,但高温降频会显著影响推理速度,进而引发超时告警。
服务性能层监控:延迟与吞吐量
用户感知的服务质量直接取决于服务的响应速度,在大模型部署故障告警配置中,延迟指标比传统的HTTP状态码更为关键。
- 首字延迟(TTFT):即从发送请求到接收到第一个Token的时间,对于对话类应用,TTFT超过2秒用户就会感到明显卡顿,建议将其作为核心监控项,一旦异常波动立即告警。
- 生成速度(Tokens/秒):监控每秒生成的Token数量,如果该数值突然下降,可能意味着后端出现了锁竞争或显存碎片化问题。
- 请求成功率:不仅要看HTTP 200,还要关注业务层面的错误码,模型返回“内容安全拦截”或“上下文超限”等特定错误,应单独归类统计,以便区分是模型能力问题还是业务逻辑问题。
大模型部署故障告警配置中的场景化陷阱与对策
单纯堆砌监控指标并不能解决所有问题,反而可能因为告警风暴导致运维人员麻木,不同业务场景下的故障表现差异巨大,需要定制化的监控策略。
长文本与上下文窗口溢出
随着RAG(检索增强生成)技术的普及,输入上下文长度大幅增加,许多部署故障并非来自模型本身,而是来自上下文窗口的管理不当。
- 场景描述:当用户上传超长文档或进行多轮长对话时,若未正确截断或压缩历史消息,可能导致显存瞬间爆满。
- 对策:在网关层增加上下文长度校验,监控Input Tokens和Output Tokens的分布,设置最大Token限制,一旦检测到单次请求Token数超过阈值,直接拒绝请求并返回友好提示,而非让后端服务崩溃。
幻觉与逻辑错误的隐性故障
这是大模型特有的“软故障”,服务可能正常运行,HTTP状态码全部为200,但模型输出的内容完全错误,甚至产生有害信息,这种故障难以通过传统监控发现。
- 场景描述:客服场景中,模型给出了错误的退换货政策,导致用户投诉激增。
- 对策:引入“小模型监控大模型”机制,部署一个轻量级的分类模型或规则引擎,对输出内容进行实时抽检,若检测到敏感词、逻辑矛盾或低置信度回答,立即触发告警并人工介入,建立用户反馈闭环,将“点踩”率作为重要的业务指标纳入告警体系。
大模型部署故障告警配置的技术实现路径
理论框架搭建完毕后,落地执行需要具体的技术栈支撑,2026年的主流实践倾向于云原生与可观测性平台的深度融合。
监控数据收集与聚合
推荐使用Prometheus作为指标收集器,配合Grafana进行可视化展示,对于日志和追踪数据,可采用ELK Stack或Loki。
- Exporter部署:在GPU节点部署DCGM Exporter,专门采集NVIDIA GPU的细粒度指标。
- 应用层埋点:在推理服务代码中集成OpenTelemetry SDK,自动追踪每个请求的Trace ID,关联日志、指标和追踪数据。
告警规则引擎配置
告警规则不宜过于复杂,应遵循“分级响应”原则。
- P0级(紧急):服务不可用、显存溢出、核心接口超时,通知方式:电话+短信+IM群机器人,要求5分钟内响应。
- P1级(重要):TTFT异常升高、错误率小幅上升、GPU温度过高,通知方式:IM群机器人+邮件,要求30分钟内响应。
- P2级(一般):资源利用率波动、非核心指标异常,通知方式:每日汇总报告,无需即时打扰。
自动化自愈与弹性伸缩
告警的最终目的是恢复服务,而不仅仅是通知人,在Kubernetes环境中,可以配置HPA(水平Pod自动伸缩器)和VPA(垂直Pod自动伸缩器)。
- 自动扩容:当监控到QPS超过阈值或TTFT持续升高时,自动增加推理Pod的数量。
- 优雅降级:当资源极度紧张时,自动切换到低精度模型(如从FP16切换为INT8)或限制非核心用户的请求优先级,确保核心业务不中断。
大模型部署故障告警配置的成本与效能平衡
在追求高可用性的同时,企业必须考虑成本问题,全面的监控意味着更高的存储成本和计算开销,如何平衡两者是架构师面临的挑战。
采样策略优化
全量采集所有Trace数据成本高昂,建议采用动态采样策略:
- 错误请求全量保留:所有报错请求的Trace数据必须100%保存,以便事后排查。
- 正常请求按比例采样:对于成功的请求,可根据负载情况动态调整采样率,在低负载时采样率可设为10%,在高负载时降低至1%甚至更低,仅在资源充足时回溯分析。
存储分层管理
- 热数据:最近7天的详细指标和Trace数据存储在高速SSD上,支持实时查询和告警判断。
- 温数据:7天至3个月的数据存储在普通HDD或对象存储中,用于趋势分析和报表生成。
- 冷数据:3个月以上的数据归档至低成本存储,仅在审计或深度回溯时访问。
通过这种分层存储,可以大幅降低长期存储成本,同时保证关键故障场景下的数据可追溯性。
大模型部署故障告警配置常见问题解答
大模型部署故障告警配置中,如何区分网络抖动与模型服务异常?
区分网络抖动与服务异常的关键在于观察指标的相关性,如果HTTP请求失败率飙升,但GPU利用率和显存占用率保持平稳,且TTFT(首字延迟)没有显著增加,这通常是网络层或网关层的问题,反之,如果GPU利用率满载,显存占用高,且TTFT显著延长,则极可能是模型服务本身的处理瓶颈,检查负载均衡器的健康检查日志也有助于快速定位是后端服务无响应还是网络链路中断。
大模型部署故障告警配置时,告警风暴如何处理?
告警风暴通常由底层基础设施故障引发,导致上层所有服务同时报错,处理策略包括:设置告警抑制规则,当检测到“节点宕机”或“网络分区”等底层故障时,自动抑制该节点上所有应用层的细粒度告警,只发送一条汇总告警,引入告警聚合机制,将同一时间段、同一原因的多个相似告警合并为一条,建立告警分级制度,确保只有真正影响业务的P0级告警能触达运维人员,避免疲劳。
大模型部署故障告警配置中,如何监控模型输出的内容质量?
质量监控属于业务层监控,无法仅靠基础设施指标完成,建议采用“双模型”架构:一个用于生产推理,另一个轻量级模型用于实时质检,质检模型可以基于规则(如敏感词过滤)或基于学习(如语义相似度、逻辑一致性评分)对输出内容进行打分,当质检分数低于设定阈值时,触发告警并记录日志,供后续人工审核和模型迭代使用,这种机制能有效捕捉模型幻觉和合规风险,是2026年企业级大模型部署的标准实践。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/395756.html