在显存受限且追求高性价比微调的场景下,QLoRA通过4-bit量化技术,能以极低的资源消耗达到接近全参数微调的效果,是绝大多数中小团队落地大模型的首选方案;而LoRA虽精度略高,但对硬件要求苛刻,更适合拥有充足算力资源的头部机构进行极致优化。
如今大模型应用落地已成常态,但许多开发者在微调环节常常陷入纠结:到底该用传统的LoRA,还是更节省资源的QLoRA?这不仅是技术选型问题,更是成本与效果的博弈,业内专家指出,两者的核心差异在于对显存的占用方式以及量化带来的精度折损,对于大多数非顶尖科研场景,QLoRA凭借其在效率上的巨大优势,已经成为事实上的行业标准。

QLoRA与LoRA的核心机制差异解析
要理解两者的区别,首先得看清它们底层是如何工作的,LoRA(Low-Rank Adaptation)的核心思想是“旁路注入”,它冻结预训练模型的所有权重,只在注意力机制等关键层中注入可训练的低秩分解矩阵,这种方法保留了原始模型的完整性,训练时只需更新这些新增的小矩阵。
相比之下,QLoRA(Quantized LoRA)是在LoRA基础上的进一步革新,它在LoRA之前增加了一个关键的步骤:将基础大模型进行4-bit量化,这意味着原本需要32位或16位浮点数存储的模型权重,被压缩到了4位,这种压缩极大地减少了显存占用,使得在单张消费级显卡上微调70B甚至更大规模的模型成为可能。
量化带来的精度与效率权衡
量化并非简单的数据压缩,它涉及复杂的数值映射,QLoRA采用了一种名为NF4(Normal Float 4)的特殊数据类型,针对大模型权重的正态分布特性进行了优化,这种设计确保了在大幅降低显存需求的同时,精度损失被控制在极小范围内。
- 显存占用对比:在微调7B参数模型时,LoRA通常需要至少24GB显存才能流畅运行,而QLoRA仅需约10-12GB显存。
- 训练速度:由于数据量减少,QLoRA的数据加载和计算速度通常比LoRA快20%-30%,尤其是在数据密集型任务中优势明显。
- 精度折损:在多数通用任务中,QLoRA与全精度LoRA的准确率差异小于1%
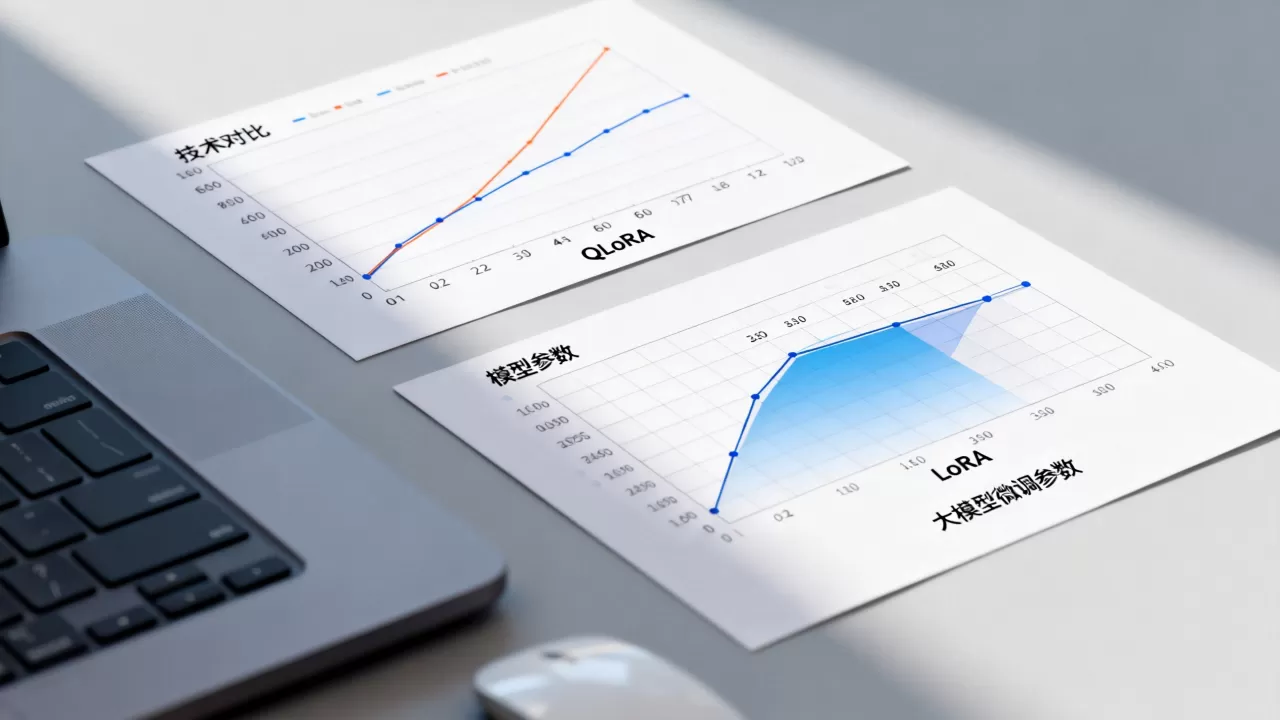
,但在极其复杂的逻辑推理或特定领域知识问答中,LoRA可能保持微弱优势。
硬件需求与部署成本深度对比
对于企业而言,算力成本是决定技术选型的关键因素,LoRA和QLoRA在硬件门槛上的巨大差异,直接影响了项目的ROI(投资回报率)。
显存预算与显卡选择
如果你正在考虑搭建微调环境,硬件清单的制定至关重要,以下是基于当前主流硬件环境的典型配置需求:
| 模型规模 | LoRA推荐显存 | QLoRA推荐显存 | 典型消费级显卡支持情况 |
|---|---|---|---|
| 7B (如Llama-3-8B) | 24GB+ | 8-12GB | QLoRA可在RTX 3090/4090上运行,LoRA需双卡或A100 |
| 13B (如Qwen-14B) | 48GB+ | 20-24GB | QLoRA可在单张RTX 4090上运行,LoRA需多卡集群 |
| 70B (如Llama-3-70B) | 多卡A100/H100 | 单张A100 80G或双卡4090 | QLoRA实现了单卡微调超大模型的突破 |
- LoRA的瓶颈:由于需要加载完整精度的基座模型,LoRA对显存的要求呈线性增长,对于70B以上的模型,往往需要多张专业级GPU组成集群,硬件投入动辄数十万。
- QLoRA的普惠性:QLoRA通过量化技术,让单张RTX 4090甚至更低的消费级显卡也能微调大型模型,这种“降维打击”极大地降低了大模型应用的门槛。
训练时间与能源成本
除了硬件购买成本,运行期间的电费和时间成本也不容忽视,由于QLoRA减少了内存带宽的压力和计算量的冗余,其训练周期通常更短,据统计,在相同数据集上,QLoRA的训练能耗比LoRA低15%-25%,对于需要频繁迭代模型的企业,这种累积的成本节约非常可观。
实战场景:何时选择QLoRA,何时坚持LoRA?
技术没有绝对的优劣,只有场景的适配,根据行业共识认为,不同业务需求对应不同的最佳实践。
QLoRA的最佳适用场景
- 资源受限的个人开发者或初创团队:如果你没有A100/H100等高端算力,QLoRA是唯一可行的微调路径。
- 快速原型验证:在MVP(最小可行性产品)阶段,需要快速验证模型效果,QLoRA的高效性让你能更快获得反馈。
- 多任务并行微调:当需要同时微调多个不同领域的小模型时,QLoRA的低显存占用允许你在同一台服务器上并行运行多个实例,提高资源利用率。
- 边缘设备部署前置:如果最终目标是部署到资源有限的边缘设备,使用QLoRA进行微调往往能更好地保持模型的轻量化特性。
LoRA的不可替代场景
- 极致精度要求:在医疗诊断、法律条文解析等对细节极其敏感、容错率极低的垂直领域,LoRA保留的完整精度可能带来更稳定的输出。
- 超大规模连续预训练:如果涉及的是基础模型的持续预训练(Continual Pre-training),而非仅仅是对齐微调,LoRA通常能更好地保留原有知识,避免灾难性遗忘。
- 复杂逻辑推理增强:对于需要极强链式推理能力的数学或代码生成任务,部分研究表明,全精度微调在解决复杂多步推理时表现更为稳健。
实操指南:如何快速上手QLoRA微调
对于想要尝试QLoRA的开发者,目前的工具链已经非常成熟,以下是一个标准的操作路径,帮助你快速启动项目。
环境准备与依赖安装
确保你的Python环境版本在3.10以上,并安装必要的库,推荐使用bitsandbytes库来处理量化操作,以及peft库来管理LoRA适配器。
pip install transformers peft accelerate bitsandbytes
加载量化模型
在加载模型时,关键参数是load_in_4bit=True,这会指示Hugging Face Transformers库使用NF4格式加载权重。
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.float16
)
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-3-8b",
    quantization_config=bnb_config,
    device_map="auto"
)
配置LoRA参数
配置LoRA的秩(rank)、alpha和dropout,对于大多数任务,r=16或r=32是不错的起点。
from peft import LoraConfig, get_peft_model
config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, config)
model.print_trainable_parameters()
训练与保存
使用Trainer API进行训练,注意设置fp16=True或bf16=True以加速训练并节省显存,训练完成后,保存的将是LoRA适配器权重,而非整个模型,这进一步减小了存储负担。
常见问题解答
QLoRA微调后的模型推理速度会变慢吗?
推理速度主要取决于模型架构和硬件加速,与微调方法关系不大,QLoRA在训练阶段使用量化,但在推理阶段,你可以选择将模型反量化回16位或32位精度进行部署,这样推理速度与原始模型无异,如果直接加载量化模型进行推理,速度反而可能因内存带宽减少而略有提升,但精度需重新评估。
QLoRA是否支持多GPU分布式训练?
支持,QLoRA完全兼容DeepSpeed和FSDP等分布式训练框架,在多卡环境下,你可以利用张量并行或流水线并行来进一步加速训练,由于QLoRA降低了单卡显存压力,你甚至可以用更少的卡实现同样的模型规模,或者用同样的卡训练更大的模型。
QLoRA微调的数据集有什么特殊要求?
QLoRA对数据集的要求与LoRA基本一致,主要取决于你的任务类型,无论是指令微调(SFT)还是偏好优化(DPO),都需要高质量的结构化数据,由于QLoRA显存占用低,你可以使用更大的Batch Size或更长的序列长度,从而在相同时间内处理更多数据,这反而有助于提升模型泛化能力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/394458.html