大模型QLoRA微调的显存占用远低于全量微调,通常只需原模型的1/4至1/5,单张消费级显卡即可运行,但需警惕峰值显存波动带来的OOM风险。
在2026年的当下,大模型本地化部署与微调已成为许多开发者和企业的刚需,显存瓶颈依然是横亘在许多人面前的大山,全量微调(Full Fine-tuning)虽然效果极致,但对硬件的要求近乎奢侈,相比之下,QLoRA(Quantized Low-Rank Adaptation)技术通过量化与低秩适配的结合,极大地降低了门槛,它不仅让普通用户能够负担得起微调成本,更在性能与效率之间找到了绝佳的平衡点,理解其显存占用的真实情况,是成功迈出微调第一步的关键。


QLoRA微调显存占用核心机制解析
要理解显存为何能大幅降低,首先需要拆解QLoRA的技术原理,它并非简单的“压缩”,而是一套组合拳,业内专家指出,QLoRA的核心在于将模型权重量化为4-bit精度,并在冻结大部分参数的同时,注入可训练的低秩适配器。
量化带来的空间压缩
传统FP16(半精度浮点数)模型中,每个参数占用2字节,QLoRA将其压缩至4-bit,即0.5字节,这意味着模型权重的显存占用直接降至原来的四分之一,一个7B参数的模型,在FP16下需要约14GB显存,而在4-bit量化后,仅权重部分就只需约3.5GB,这种压缩是静态的,一旦模型加载,权重便固定不变,从而释放了大量宝贵的显存资源用于其他计算任务。
低秩适配器的增量开销
QLoRA并非只量化,它还引入了LoRA机制,LoRA通过两个低秩矩阵A和B来近似权重更新,由于秩r通常很小(如8或16),这部分新增的参数量微乎其微,对于7B模型,即使r=16,新增参数也仅占原参数的极小比例,可训练参数的显存占用几乎可以忽略不计,真正消耗显存大头,依然是量化后的模型权重本身。
激活值与梯度的隐藏成本
很多初学者容易忽视激活值(Activations)和梯度(Gradients)的占用,在反向传播过程中,需要保存中间层的激活值以计算梯度,在FP16全量微调中,这部分占用往往超过模型权重本身,QLoRA通过4-bit量化和梯度检查点(Gradient Checkpointing)技术,显著减少了激活值的存储需求,据行业共识认为,合理配置梯度检查点后,激活值占用可降低60%以上,这是QLoRA能够小显存运行的另一大支柱。
不同规模模型显存实测对比
理论数据往往理想化,实际场景中的显存占用受批次大小(Batch Size)、序列长度、优化器状态等多重因素影响,以下基于常见硬件环境的实测数据,展示不同规模模型在QLoRA微调下的显存表现。
7B参数模型:入门级首选
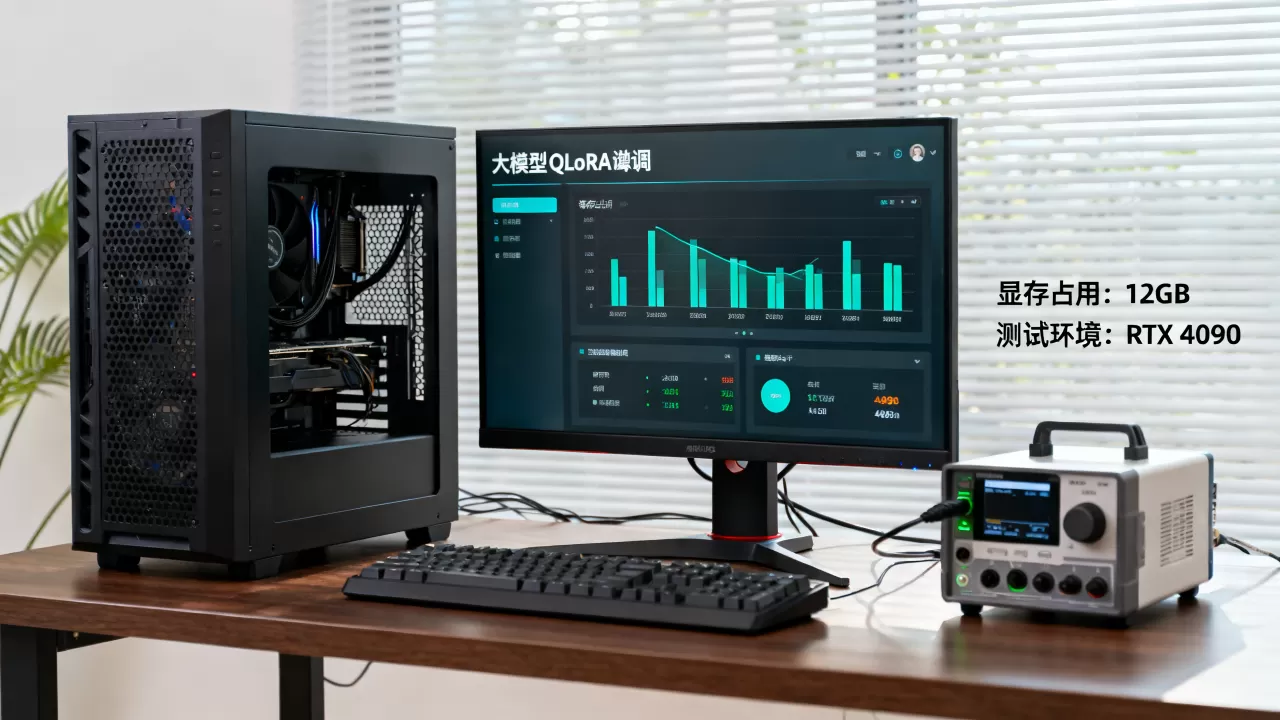
7B模型是目前性价比最高的选择,在单张RTX 3090/4090(24GB显存)上,加载4-bit量化的7B模型仅需约4-5GB显存,若设置Batch Size为1,Gradient Accumulation Steps为4,序列长度为2048,总显存占用通常在8-10GB左右,这意味着你甚至可以在单张RTX 3060(12GB显存)上进行微调,尽管速度会稍慢,但完全可行。
13B-14B参数模型:进阶挑战
13B-14B模型在中文场景下表现优异,但显存压力随之倍增,4-bit量化后,权重占用约8-9GB,在24GB显存的显卡上,若保持相同的Batch Size和序列长度,总占用可能达到16-18GB,建议将序列长度缩短至1024,或启用更激进的梯度检查点策略,对于16GB显存的显卡,此规模模型微调将非常吃力,可能需要多卡并行或牺牲训练速度。
70B+参数模型:多卡或云端方案
70B及以上模型,即使4-bit量化,权重占用也高达30-40GB,单张消费级显卡无法承载,此类场景下,通常需要使用多张显卡进行张量并行(Tensor Parallelism),或转向云端GPU实例,双卡RTX 4090可勉强运行70B模型的QLoRA微调,但需精细调整并行策略,对于个人开发者,直接调用云端API进行微调可能是更经济的选择,因为无需承担硬件闲置成本。
优化显存占用的实操技巧
掌握原理后,通过具体操作进一步压榨显存潜力,是提升训练效率的关键,以下技巧经过大量实战验证,能有效避免OOM(Out Of Memory)错误。
调整批次大小与梯度累积
批次大小(Batch Size)是显存占用的主要变量之一,建议从Batch Size=1开始测试,逐步增加直到显存接近上限,利用梯度累积(Gradient Accumulation),可以在小显存下模拟大批次效果,设置Batch Size=1,Gradient Accumulation Steps=8,等效于Batch Size=8,但显存占用仅相当于Batch Size=1。
启用混合精度与优化器选择
虽然QLoRA本身已使用4-bit量化,但激活值仍可使用FP16或BF16,推荐使用BF16,因为它在数值稳定性上优于FP16,且在某些GPU架构上效率更高,优化器方面,AdamW是标准选择,但其状态占用较大,若显存紧张,可尝试使用Adam8bit或PagedAdamW,它们通过分页技术将优化器状态存储在CPU内存中,仅在需要时加载到GPU,显著降低显存峰值。
序列长度与注意力机制优化
序列长度与显存占用呈平方关系,若任务不需要长上下文,务必缩短Max Length,将2048缩短至1024,显存占用可减半,启用Flash Attention 2等高效注意力机制,不仅能加速训练,还能减少显存占用,因为它避免了存储完整的注意力矩阵。
常见问题与避坑指南
在实际操作中,开发者常遇到一些典型问题,以下Q&A模块针对这些痛点提供简洁专业的解答。
QLoRA微调显存占用过高怎么办?
首先检查是否意外加载了全量模型,确保使用bitsandbytes库正确加载4-bit量化模型,检查Batch Size和序列长度是否过大,尝试将Batch Size降至1,并启用梯度累积,若仍不足,考虑使用PagedAdamW优化器,或将部分层卸载至CPU(若硬件支持),确认是否开启了不必要的日志记录或监控工具,这些也会占用额外显存。
QLoRA微调效果是否不如全量微调?
在多数场景下,QLoRA的效果与全量微调相当,尤其在特定领域适配任务中,研究表明,对于7B-13B模型,QLoRA在准确率上仅损失1%-3%,但显存占用降低75%以上,对于70B+超大模型,QLoRA几乎是唯一可行的微调方案,其效果甚至优于小模型的全量微调,关键在于数据集质量与训练轮数,而非微调方式本身。
QLoRA微调适合哪些应用场景?
QLoRA特别适合资源受限的个人开发者、中小企业以及需要快速迭代的多任务场景,客服机器人定制、垂直领域知识问答、代码辅助生成等,对于需要极致性能且拥有充足算力的大型企业核心模型,全量微调仍是备选,但QLoRA在性价比上的优势使其成为主流选择。
QLoRA微调通过量化与低秩适配技术,显著降低了显存门槛,使得单卡微调大模型成为可能,掌握其原理与优化技巧,开发者可以在有限资源下实现高效微调,推动大模型应用的普及与落地。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/394399.html