准备大模型全参数微调数据集的核心在于构建高质量、高纯度且领域垂直的结构化数据,通过清洗去重、格式对齐与指令增强,确保模型能精准学习特定任务的逻辑与风格。
全参数微调(Full Fine-Tuning)不同于参数高效微调,它需要更新模型的所有权重,这意味着数据的质量直接决定了模型的“智商”上限,如果数据像垃圾食品,模型就会变成“臃肿且低效”的专家,业内专家指出,数据质量对最终效果的影响权重往往超过算法本身的优化,准备数据集不是简单的文件收集,而是一场精密的数据工程战役。
明确业务场景与数据边界
在动手之前,必须想清楚你要让模型学会什么,全参数微调成本高昂,通常用于垂直领域深度适配,如医疗问诊、法律条文解析或特定代码生成。
定义核心任务类型
不同的任务需要不同的数据形态,如果是问答系统,你需要大量的“问题-答案”对;如果是代码助手,你需要“代码-注释”或“代码-修复建议”对。
- 指令跟随类:适用于通用助手,数据格式为“指令+输入+输出”,强调模型的听话程度。
- 逻辑推理类:适用于数学或科学领域,数据需包含详细的思维链(CoT),展示推导过程而非仅给结果。
- 风格模仿类:适用于创意写作或客服,数据需包含特定的语气、用词习惯和情感色彩。
确定数据规模与质量平衡
全参数微调对数据量的需求较大,但“少而精”远胜于“多而杂”,对于大多数垂直场景,1万至10万条高质量数据往往能带来显著的效果提升,盲目追求百万级数据不仅增加算力成本,还可能引入噪声,导致模型“灾难性遗忘”通用知识。
数据收集与清洗实战步骤
原始数据通常是杂乱无章的,这一步的目标是去粗取精,剔除无效信息。
多源数据采集策略
数据来源决定了模型的视野广度,建议从以下渠道获取:
- 公开数据集:如Hugging Face上的通用数据集,作为基础语料。
- 内部文档:公司的知识库、FAQ、技术文档,这是构建垂直领域壁垒的关键。
- 网络爬取:针对特定行业论坛、博客的高质量讨论帖,注意去除广告和无关评论。
自动化清洗流水线
清洗是耗时最长的环节,你需要建立一套自动化的过滤机制。
基础过滤规则
- 长度过滤:剔除过短(无意义)或过长(信息密度低)的文本。
- 重复检测:使用MinHash或SimHash算法去除重复样本,确保数据多样性。
- 敏感信息脱敏:利用正则表达式或NER模型,自动识别并替换手机号、身份证、邮箱等隐私信息。
语言与格式标准化
确保所有数据使用统一的编码(UTF-8)和语言规范,对于混合语言数据,需进行语种识别,剔除非目标语言的片段。
数据格式化与指令构建
大模型通常以JSON或JSONL格式读取数据,你需要将清洗后的文本转化为模型可理解的“指令-输入-输出”三元组。
构建高质量的指令模板
指令是引导模型行为的关键,一个优秀的指令应当清晰、无歧义,并提供必要的背景信息。
- 角色设定:明确告诉模型“你是一个资深律师”,而非模糊的“请回答法律问题”。
- 任务描述:具体说明需要做什么,如“提取合同中的违约责任条款”。
- 输出约束:规定输出格式,如“仅输出JSON格式”或“不超过50字”。
思维链(CoT)数据增强
对于复杂任务,直接给出答案效果有限,建议引入思维链数据,即在答案前添加推理过程,在数学题中,先列出公式,再代入数值,最后得出结果,这种数据能显著提升模型的逻辑推理能力。
数据格式示例
以下是一个标准的JSONL格式示例,每行一条数据:
{"instruction": "请总结以下新闻的核心观点", "input": "新闻内容...", "output": "核心观点是..."}
数据评估与迭代优化
数据准备不是一次性的工作,而是一个闭环迭代过程。
人工抽检与标注一致性
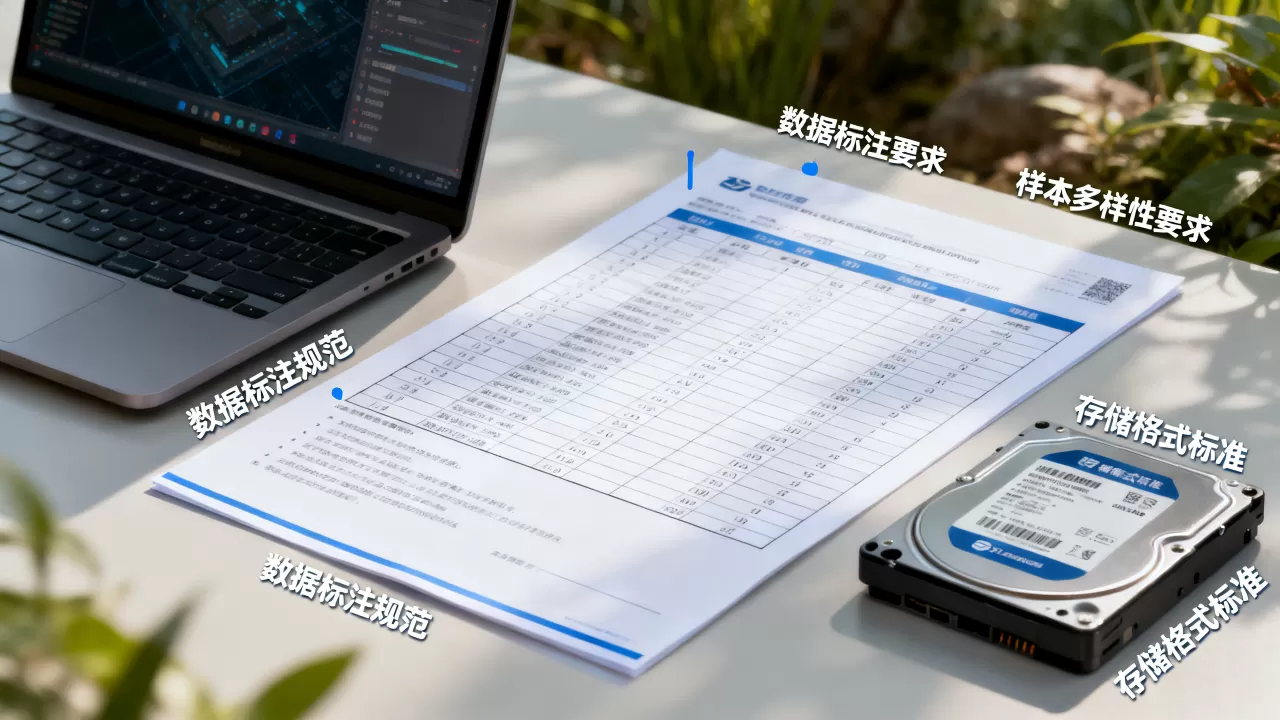
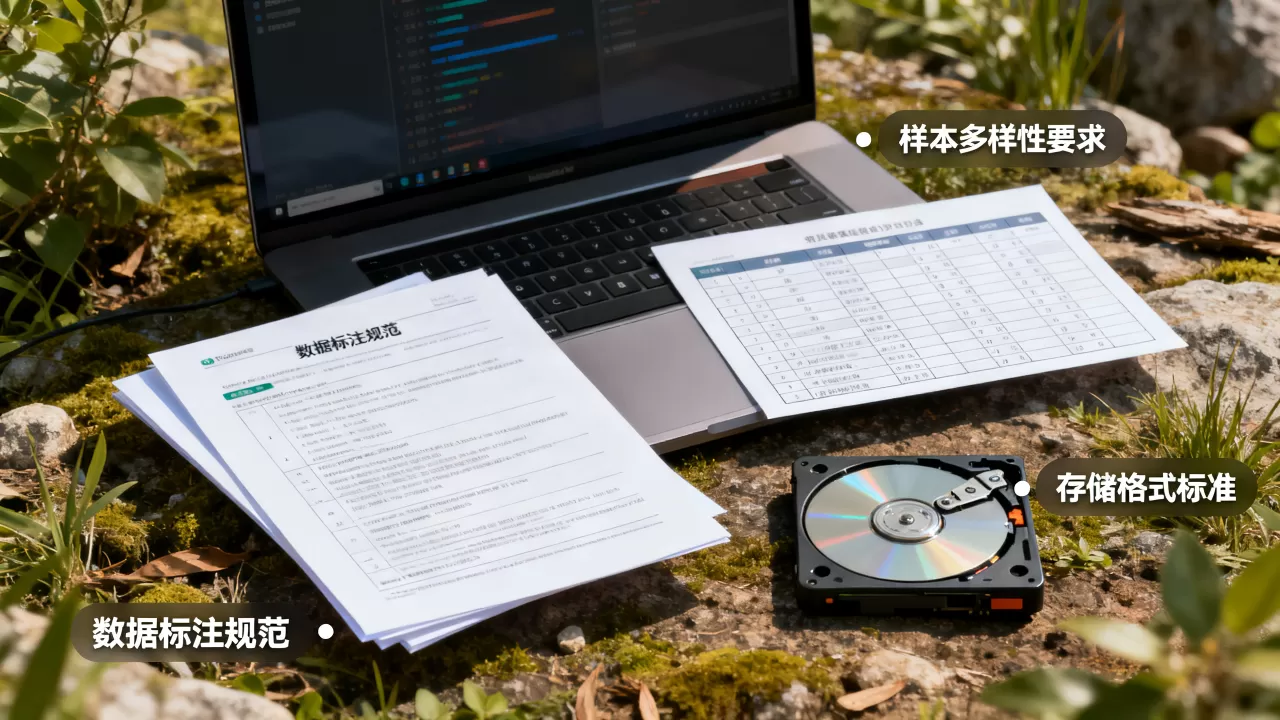
即使有自动化清洗,人工抽检依然不可或缺,建议抽取5%-10%的数据进行人工复核,重点检查指令的清晰度、答案的准确性以及格式的规范性,如果多人标注同一数据,需计算标注者间的一致性系数(Kappa系数),确保数据标注标准统一。
小规模试训与效果验证
在投入全量算力之前,先使用1%-5%的数据进行小规模微调实验,通过评估模型在验证集上的表现,如BLEU分数、ROUGE分数或人工评分,判断数据的有效性,如果效果不佳,需回溯数据源头,检查是否存在噪声或指令设计缺陷。
常见误区与避坑指南
在准备过程中,许多团队容易陷入以下误区,导致资源浪费。
数据越多越好
全参数微调对数据质量极度敏感,低质量数据不仅无法提升性能,反而会导致模型过拟合噪声,降低泛化能力,据统计,80%的效果提升来自20%的高质量数据
,应优先打磨核心数据,而非盲目扩充数量。
忽视数据分布
如果训练数据中某类样本占比过高,模型会偏向该类样本,导致其他类别表现下降,需确保数据在不同类别、不同难度、不同风格上的分布均衡,在客服数据中,需平衡常见问题和罕见问题的比例。
缺乏领域特异性
通用数据无法解决垂直领域的专业问题,法律模型需要大量的法条引用和判例分析,通用新闻数据对此帮助有限,必须确保数据中包含足够的领域专有名词、术语和上下文逻辑。
Q&A:大模型全参数微调数据集怎么准备
全参数微调与LoRA微调在数据准备上有何区别?
全参数微调需要更高质量、更完整的数据集,因为所有参数都在更新,对噪声更敏感,LoRA微调由于只更新少量参数,对数据噪声有一定的容忍度,且可以使用更多样化、甚至部分低质量数据进行训练,全参数微调更依赖数据的精确性和一致性,而LoRA更依赖数据的多样性。
如何判断数据集是否已经准备充分?
可以通过小规模试训来验证,如果模型在验证集上的指标(如准确率、流畅度)达到预期,且人工评估无明显缺陷,则数据准备充分,检查数据分布是否覆盖所有目标场景,以及是否存在明显的长尾问题未解决。
处理非结构化数据(如PDF、图片)的最佳实践是什么?
首先使用OCR或文档解析工具将非结构化数据转换为文本,对于PDF,建议使用专门的解析库(如Unstructured或PyMuPDF)保留层级结构,对于图片,需结合OCR和图像描述生成模型提取文字信息,转换后,需人工校验关键信息的准确性,特别是表格和公式部分,确保数据格式正确无误。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/394355.html