

AI能源大模型正通过实时数据融合与强化学习算法,将传统电网的被动响应转变为主动预测与优化调度,显著提升了新能源消纳率并降低了整体运营成本。
AI能源大模型如何重构电力调度逻辑
过去的电网调度像是一个经验丰富的老电工,靠直觉和经验处理突发状况,现在的AI能源大模型则像是一个拥有超级算力的“数字大脑”,它不再依赖单一的历史数据,而是能够同时处理气象卫星图像、用户用电习惯、设备传感器读数等海量异构数据,这种转变并非简单的技术升级,而是底层逻辑的重构。
业内专家指出,这种重构的核心在于对“不确定性”的管理,风电和光伏的波动性是电网稳定的最大敌人,而AI大模型通过多模态数据融合,能够提前数小时甚至数天精准预测发电量变化。
从被动响应到主动预测的跨越
传统模式下,当风速骤减导致发电量下降时,电网往往需要紧急调用备用火电机组来填补缺口,这个过程存在时间滞后,且成本高昂,AI能源大模型则完全不同,它通过深度学习算法,能够识别出微小气象变化与电网负荷之间的复杂非线性关系。
具体而言,模型会执行以下操作路径:
- 数据采集层:接入国家级气象数据、分布式光伏逆变器实时状态、电动汽车充电桩负荷数据。
- 特征工程层:利用自然语言处理技术解析新闻事件对用电高峰的影响,例如高温预警或大型节假日安排。
- 预测推演层:基于Transformer架构,生成未来24小时至7天的负荷与发电概率分布图。
这种主动预测能力,使得调度中心可以从“救火队员”转变为“战略指挥官”。
多能互补场景下的协同优化
在包含风电、光伏、储能和火电的混合能源系统中,AI大模型扮演着“总指挥”的角色,它需要在毫秒级时间内决定每一度电的来源和去向。
以某大型工业园区为例,该园区安装了屋顶光伏和大型储能电池,当午后光伏出力激增时,AI模型并非简单地记录数据,而是立即执行以下决策逻辑:
- 优先消纳:将多余光伏电力直接供给园区内高耗能生产线。
- 储能充电:若生产负荷不足,指令储能系统以最高效率充电,避免弃光。
- 动态定价:根据实时电网供需,调整内部微电网的交易电价,引导用户错峰用电。
这种精细化操作,让每一度电的价值最大化,同时也减轻了主电网的调峰压力。
AI能源大模型在实际应用中的价值体现
许多企业开始关注AI能源大模型在工业节能中的应用案例,因为对于高耗能行业而言,电费支出是巨大的成本负担,AI大模型的价值不仅体现在宏观电网的稳定,更体现在微观企业的降本增效上。
降低运营成本的实操路径
对于拥有自备电厂或大型用电设施的企业,引入AI能源管理系统并非遥不可及,以下是常见的实施步骤:
- 第一步:数据治理,清理历史用电数据,填补缺失值,统一不同设备的数据格式,这是基础,数据质量直接决定模型效果。
- 第二步:模型训练,利用过去三年的用电数据和生产计划,训练专属的负荷预测模型。
- 第三步:策略部署,将预测结果与电价峰谷平谷数据结合,自动生成最优用电策略。
据统计,经过优化的能源管理系统,通常能使企业的综合用电成本降低10%-20%,这一比例在大型制造业中尤为明显,因为它们的用电负荷具有明显的周期性规律,易于被AI捕捉。
提升新能源消纳率的场景分析
在AI能源大模型助力光伏消纳的场景中,痛点往往在于“看天吃饭”,当光伏发电过剩时,电网可能无法完全接纳,导致弃光现象,AI大模型通过精准预测未来几小时的天气变化和负荷走势,可以提前调整储能系统的充放电策略。
在夏季午后,光伏出力达到峰值,而空调负荷尚未完全启动,AI模型会预判到两小时后负荷将急剧上升,因此提前将储能系统充满,并在负荷高峰到来时放电,这种“移峰填谷”的操作,既避免了弃光,又减少了高峰时段的购电成本。
技术挑战与未来发展趋势
尽管前景广阔,但AI能源大模型的落地并非一帆风顺,数据孤岛、模型可解释性不足、算力成本高昂等问题,依然是行业面临的现实挑战。
数据孤岛与标准化难题
能源行业的数据分散在发电、输电、配电、用电各个环节,且格式各异,不同厂商的设备协议不兼容,导致数据难以打通,解决这一问题,需要行业层面推动数据标准的统一。
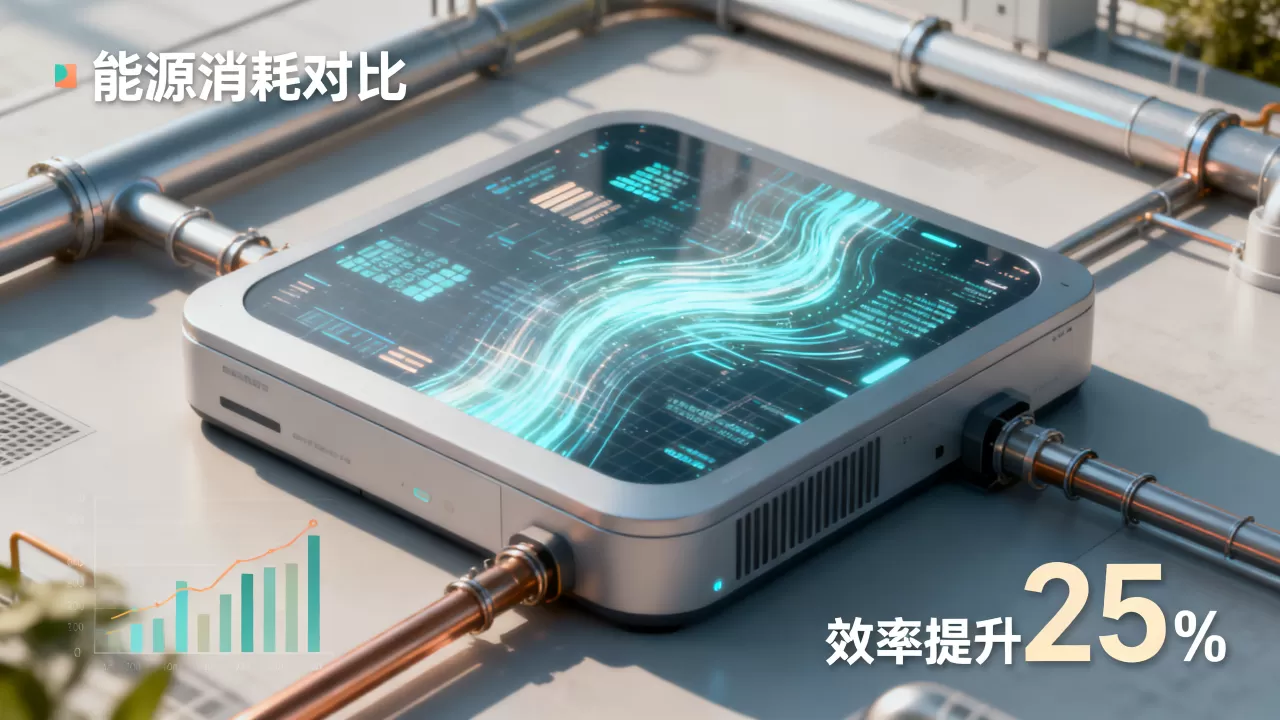
越来越多的企业开始采用边缘计算技术,在设备端进行初步的数据清洗和特征提取,再将关键信息上传至云端大模型,这种“云边协同”架构,既保证了数据的实时性,又减轻了云端算力压力。
模型可解释性与信任建立
电力调度关乎国家安全和社会稳定,决策容错率极低,调度员往往不敢完全信任AI的建议,为了解决这个问题,AI模型正在向“可解释AI”方向发展。
模型不仅给出预测结果,还会提供决策依据,当建议降低某条线路负荷时,模型会明确指出:“基于未来3小时降雨概率增加80%,为防止设备过载,建议降低负荷。”这种透明的决策逻辑,有助于建立人机信任。
常见问题解答(AI能源大模型)
AI能源大模型的部署成本如何?
部署成本因规模而异,对于小型分布式能源系统,可采用SaaS模式,按年付费,初期投入较低,对于大型电网或工业园区,通常需要私有化部署,涉及服务器采购、软件授权及定制开发费用,近年来,随着开源模型的成熟,基础模型的训练成本已大幅下降,但针对特定场景的精细化调优仍需投入专业人力。
AI能源大模型能完全替代人工调度吗?
短期内不会完全替代,AI擅长处理海量数据和复杂模式识别,但在突发极端事件、政策调整或涉及安全伦理的决策上,仍需人工介入,未来的人机协作模式将是“AI提供建议,人工最终决策”,特别是在关键节点上,人类专家的经验和直觉仍是不可或缺的安全网。
如何评估AI能源大模型的效果?
主要看三个指标:预测准确率、调峰削峰效果、经济性收益,预测准确率通常要求达到90%以上,调峰效果需量化为减少的备用容量或降低的弃风弃光率,经济性收益则直接体现为电费支出的减少或辅助服务市场的收益增加。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/389170.html

评论列表(1条)
说到这个我饿了,调度电网像做菜火候掌控。不过话说回来,这“数字大脑”要是能顺便帮我把冰箱里的剩菜也优化一下,推荐你去试试