Spring大模型AI并非单一软件,而是基于Spring生态构建的AI应用开发框架,通过集成LangChain4j等库,让Java开发者能以最低成本将大语言模型能力嵌入企业级后端系统。
为什么Java生态需要Spring大模型AI方案
在2026年的技术语境下,企业级应用开发正经历从“功能驱动”向“智能驱动”的转型,对于绝大多数中大型企业而言,Java依然是后端开发的绝对主力,传统的大模型集成方式往往需要引入Python微服务,导致架构复杂、运维成本高昂且数据流转效率低下,Spring大模型AI解决方案的核心价值,在于它打破了这一壁垒,让Java开发者无需切换语言栈,即可在熟悉的Spring Boot环境中直接调用大模型能力。
业内专家指出,这种原生集成方式能显著降低技术债务,过去,企业需要维护两套代码库、两套部署流程,现在只需一个Jar包依赖,即可实现模型调用、向量检索和提示词管理的标准化,这种一致性不仅提升了开发效率,更确保了企业数据在内存中的安全流转,避免了跨语言调用带来的序列化开销和潜在的安全漏洞。
传统集成痛点与Spring原生优势对比
为了更直观地理解差异,我们可以对比两种常见的集成路径,传统方案通常采用“Java前端 + Python AI后端”的分离架构,而Spring大模型方案则采用“全栈Java”架构。
| 对比维度 | 传统Python微服务方案 | Spring大模型AI原生方案 |
|---|---|---|
| 开发语言 | Java + Python | 纯Java/Kotlin |
| 部署复杂度 | 高,需维护Docker多容器 | 低,单一Jar包或镜像 |
| 数据一致性 | 弱,依赖API网络传输 | 强,内存直接访问Bean |
| 事务管理 | 困难,跨服务事务难保证 | 容易,利用Spring @Transactional |
| 学习曲线 | 陡峭,需掌握两套生态 | 平缓,复用现有Spring知识 |
多数情况下,企业选择Spring大模型AI方案,是因为其能够无缝接入现有的Spring Security认证体系,这意味着用户身份验证、权限控制可以直接复用已有的Spring Security Filter链,无需为AI模块单独开发一套鉴权逻辑,这种“开箱即用”的特性,是Python方案难以比拟的。
核心组件与技术栈解析
构建一个健壮的Spring大模型AI应用,离不开几个关键组件的协同工作,这些组件共同构成了从提示词工程到模型推理的完整链路。
模型抽象层:统一接口调用
Spring AI提供了统一的抽象层,屏蔽了不同大模型厂商(如OpenAI、Anthropic、本地部署的Llama等)的API差异,开发者只需配置一个ChatClient Bean,即可在代码中切换底层模型,而无需修改业务逻辑。
具体操作步骤如下:
- 在
pom.xml中引入spring-ai-openai-spring-boot-starter依赖。 - 在
application.yml中配置API Key和模型名称。 - 在Service层注入
ChatClient。 - 调用
.prompt("你的问题").call()方法获取响应。
这种解耦设计使得技术选型变得极其灵活,当某家模型厂商涨价或出现服务不稳定时,只需修改配置文件中的模型ID,即可平滑迁移至备选方案,极大降低了供应链风险。
向量数据库集成:实现记忆与检索
大模型本身没有长期记忆,要实现“企业知识库问答”,必须结合向量数据库,Spring AI原生支持多种向量存储后端,如PostgreSQL(通过pgvector)、Redis、Elasticsearch等。
在实操中,开发者通常使用VectorStore接口来管理嵌入向量,将PDF文档切片后,通过EmbeddingModel
生成向量并存储,当用户提问时,系统先检索相关片段,再将其作为上下文注入提示词,从而生成基于事实的回答,而非模型幻觉。
据统计,采用RAG(检索增强生成)架构的企业应用,其回答准确率比纯大模型方案高出显著比例,Spring AI的RetrievalAugmentedFunction注解简化了这一过程,开发者只需定义一个方法,框架会自动完成检索、拼接和调用。
提示词工程:结构化与模板化
提示词的质量直接决定输出效果,Spring AI支持Thymeleaf和Mustache模板引擎,允许开发者将提示词与业务数据分离,这种模板化方式不仅便于版本控制,还能实现动态变量替换。
在生成销售报告时,提示词模板可以包含{{sales_data}}和{{customer_name}}占位符,在运行时,Spring会自动将Java对象序列化为JSON并注入模板,这种方式比硬编码字符串更安全、更易于维护,尤其适合复杂的企业级Prompt管理场景。
落地场景与最佳实践
Spring大模型AI并非空中楼阁,它在多个垂直领域已有成熟落地案例,理解这些场景,有助于开发者快速定位自身需求。
智能客服与内部知识库
这是目前最普遍的应用场景,企业将产品手册、FAQ、历史工单存入向量数据库,构建私有知识库,当用户提问时,系统检索最相关的文档片段,结合大模型生成自然语言回答。
实操建议:
- 数据预处理:确保文档切片大小适中,通常500-1000字为宜,避免上下文丢失。
- 元数据过滤:在向量检索时,利用元数据(如文档类型、发布时间)进行预过滤,提高检索精度。
- 引用溯源:在回答末尾标注来源文档链接,增强用户信任度。
代码辅助与DevOps自动化
除了面向用户的功能,Spring大模型AI还可用于提升研发效率,集成GitHub Copilot类似的代码补全功能,或自动生成单元测试用例。
在DevOps场景中,AI可以分析CI/CD日志,识别构建失败的原因,并给出修复建议,这种“智能运维助手”能显著缩短故障排查时间,开发者只需编写一个
CodeCompletionService,调用ChatClient的流式响应接口,即可实现实时代码建议推送。
数据分析与自然语言查询
将自然语言转换为SQL或API调用,是另一个高价值场景,用户可以用口语询问“上个月销售额最高的前五个产品是什么?”,系统将其转化为查询语句,执行后返回结果。
需要注意的是,这种场景对安全性要求极高,必须实施严格的权限控制,防止SQL注入或数据泄露,Spring Security可以与Spring AI结合,确保只有授权用户才能执行特定类型的查询,且查询结果经过脱敏处理。
常见问题解答
Spring大模型AI与LangChain4j有什么区别
Spring AI是Spring官方推出的标准化框架,旨在提供统一的企业级集成方案,强调与Spring Boot生态的深度整合,如自动配置、依赖注入和事务管理,LangChain4j则是更轻量级的Java版LangChain实现,侧重于灵活性和社区插件生态,对于大型传统企业,Spring AI因其标准化和安全性更受青睐;对于初创团队或需要高度自定义的场景,LangChain4j可能更合适,两者并非互斥,Spring AI底层甚至兼容部分LangChain4j的组件。
本地部署大模型是否支持Spring大模型AI
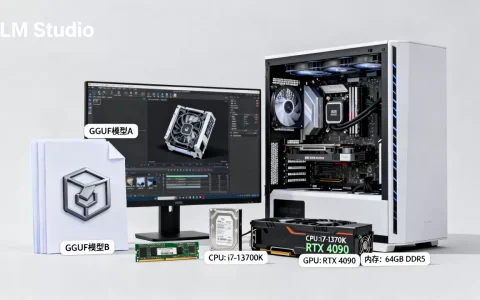
完全支持,Spring AI通过抽象层支持多种模型后端,包括本地运行的Ollama、LM Studio或vLLM,开发者只需在配置文件中指定本地API地址(如http://localhost:11434),即可将本地模型作为ChatClient的底层实现,这种方式适合对数据隐私有极高要求、无法使用云端API的企业场景,且能显著降低长期运营成本。
如何评估Spring大模型AI项目的投资回报率
评估ROI需从效率提升和成本节约两个维度考量,效率方面,可对比AI辅助开发带来的代码生成速度提升比例,以及智能客服解决率的增长幅度,成本方面,主要计算云端API调用费用与本地部署硬件成本的差额,以及因减少人工干预而节省的人力成本,多数情况下,当AI模块处理的事务量达到一定规模后,边际成本会迅速下降,投资回报周期通常在6-12个月之间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/388905.html