AI大模型并非魔法,其核心本质是基于海量数据训练的神经网络,通过预测下一个字来理解并生成内容,掌握其原理能帮你更高效地利用工具而非被工具替代。
很多人觉得大模型高深莫测,仿佛背后有个全知全能的“大脑”在思考,剥去那些晦涩的技术外衣,它更像是一个读过图书馆所有书籍、记忆力超群但缺乏生活常识的超级实习生,你给它的指令越清晰,它给出的答案就越精准,理解它是如何工作的,不仅能让你写出更好的提示词,还能帮你避开那些看似专业实则无效的“伪需求”。
大模型的工作原理拆解:从数据到智能
要搞清楚AI大模型算法讲解,首先得明白它是怎么“学”会的,这个过程可以分为三个主要阶段:预训练、微调和对齐,这三个阶段环环相扣,缺一不可。
预训练:建立基础认知
预训练是大模型最基础也是耗时最长的阶段,想象一下,让一个婴儿在图书馆里泡上十年,只读书不交流,这就是预训练,在这个阶段,模型会阅读互联网上公开的海量文本,包括书籍、文章、代码、对话记录等。
它做的唯一一件事就是“填空”,比如看到“床前明月”,它需要计算出下一个字是“光”的概率最高,通过这种自监督学习,模型逐渐掌握了语言的语法、常识、逻辑甚至部分推理能力,业内专家指出,预训练数据的质量直接决定了模型的智商上限,数据越干净、越多样,模型的基础能力就越强。
指令微调:学会听从指挥
如果只有预训练,模型就像一个满腹经纶但不懂礼貌的书呆子,你问它“今天天气如何”,它可能给你背一段关于气象学的定义,而不是告诉你“今天下雨”,指令微调(SFT)就是解决这个问题的关键。
在这个阶段,工程师会准备大量的“问题-答案”对,教模型如何以人类期望的方式回答问题,这就像给实习生制定操作手册,告诉他:“当用户问价格时,直接给出数字,不要讲历史背景。”通过这种方式,模型学会了遵循指令,具备了初步的交互能力。
人类反馈强化学习:塑造价值观
这是让模型变得“好用”且“安全”的最后一步,模型在微调后可能会产生幻觉,或者给出有害、偏激的回答,这时,人类标注员会对模型生成的多个答案进行打分和排序。
模型会根据这些反馈不断调整自己的参数,试图获得更高的奖励分数,这个过程类似于训练宠物,做对了给奖励,做错了给纠正,经过数千次的迭代,模型逐渐学会了哪些话该说,哪些话不该说,从而形成了符合人类价值观的行为准则。
提示词工程:如何与大模型高效对话
理解了原理,接下来就是实战,很多人觉得AI不好用,往往不是模型的问题,而是提问的方式不对,掌握提示词工程(Prompt Engineering),就是掌握与AI沟通的艺术。
结构化提示词的构建方法
一个高质量的提示词通常包含四个核心要素:角色、背景、任务和约束,不要只说“帮我写篇文章”,而要说“你是一位资深科技记者(角色),正在为35岁以下职场人撰写指南(背景),请写一篇关于远程办公效率的文章(任务),要求语气轻松,包含三个具体案例,字数在800字左右(约束)”。
这种结构化的思考方式,能极大降低模型的理解成本,你可以尝试使用以下模板来优化你的日常提问:
- 角色设定:明确AI的身份,如“你是Python专家”或“你是心理咨询师”。
- 上下文信息:提供必要的背景资料,如“我正在准备一场关于区块链的演讲”。
- 具体任务:清晰描述你需要AI做什么,如“列出演讲大纲”或“解释哈希函数的概念”。
- 输出格式:指定结果的呈现方式,如“使用表格对比”、“分点陈述”或“生成Markdown代码”。
常见误区与避坑指南
在实际操作中,有几个常见的误区需要避免,首先是“思维跳跃”,不要假设AI知道你没说出来的背景信息,其次是“指令冲突”,不要在同一个提示词中要求AI既简洁又详细,这会让模型无所适从,最后是“缺乏迭代”,第一次回答不满意时,不要直接放弃,而是通过追问来修正结果,请简化第二段,并增加一个实际案例”。
技术选型与场景应用:不同需求怎么选
面对市面上琳琅满目的AI工具,如何选择最适合你的那一个?这取决于你的具体使用场景和对成本、隐私的要求。
开源模型与闭源模型的对比
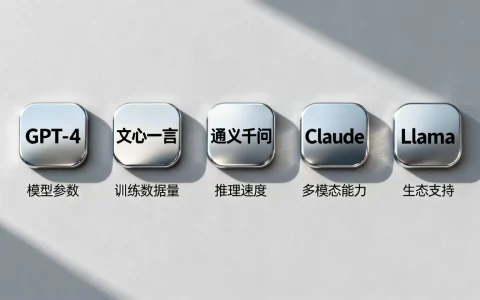
目前市场上主要分为开源模型(如Llama系列、Qwen系列)和闭源模型(如GPT-4、Claude系列),开源模型允许用户下载并在本地部署,适合对数据隐私要求极高或需要深度定制的企业用户,闭源模型则通过API调用,拥有更强大的推理能力和更稳定的服务,适合大多数个人用户和中小企业。
据工信部数据,近年来开源生态的发展速度显著加快,越来越多的企业开始采用混合部署策略,既利用闭源模型的强大能力处理复杂任务,又利用开源模型处理敏感数据。
不同行业的应用场景分析
- 内容创作:对于自媒体人和文案策划,AI可以快速生成大纲、润色文字、生成配图提示词,重点在于利用AI的广度来激发灵感,而非完全依赖其深度。
- 编程开发:程序员可以利用AI进行代码补全、Bug修复和单元测试生成,研究表明,熟练的开发者使用AI辅助后,编码效率可提升相当一部分。
- 数据分析:非技术人员可以通过自然语言查询数据库,生成图表和洞察,这降低了数据分析的门槛,让业务人员也能直接获取数据价值。
未来趋势与伦理考量
AI大模型的发展仍在加速,未来的趋势将更加注重多模态融合和垂直领域深化。
多模态能力的普及
现在的模型已经不再局限于文本,而是能够同时理解图像、音频甚至视频,这意味着未来的交互将更加自然,你可以直接上传一张照片让AI分析其中的内容,或者发送一段录音让它总结要点,这种多模态能力将彻底改变人机交互的方式,让AI真正融入生活的方方面面。
伦理与安全挑战
随着AI能力的增强,伦理问题也日益凸显,深度伪造、版权争议、算法偏见等问题需要社会各界共同关注,行业共识认为,建立完善的监管框架和技术标准是确保AI健康发展的关键,用户在使用AI时,也应保持批判性思维,对生成内容进行核实,不盲目信任AI的输出。
AI大模型算法讲解与常见问题解答
AI大模型算法讲解中常见的疑问有哪些
大模型会产生幻觉吗?如何应对?
是的,大模型确实会产生幻觉,即生成看似合理但事实错误的内容,这是因为模型本质上是基于概率预测下一个字,而非检索真实数据库,应对方法是:要求模型提供引用来源,对关键事实进行交叉验证,或在提示词中明确要求“如果不确定,请回答不知道”。
本地部署大模型需要什么配置?
本地部署对硬件要求较高,对于7B参数规模的模型,至少需要16GB显存的显卡;对于70B规模的模型,则需要多张高端显卡或专业服务器,还需要足够的内存和存储空间,对于普通用户,使用云端API通常是更经济高效的选择。
大模型的训练成本有多高?
训练一个顶级大模型的算力成本高达数千万美元,涉及数千张GPU运行数月,这解释了为什么只有少数科技巨头能够主导基础模型的研发,而大多数企业更倾向于基于开源模型进行微调或使用API服务。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/381718.html