

朱雀大模型并非单一软件,而是百度基于文心一言底层技术构建的企业级AI生态体系,其核心价值在于通过私有化部署与行业垂直优化,帮助企业在数据安全合规的前提下实现降本增效。
在2026年的AI应用市场中,企业不再盲目追求通用大模型的参数规模,而是转向寻找能够深度融入业务流、具备高安全性的专用模型,朱雀大模型正是这一趋势下的典型代表,它解决了通用大模型在特定行业场景下“懂语言但不懂业务”的痛点,对于寻求技术落地的决策者而言,理解朱雀大模型的技术架构与应用边界,是制定数字化转型战略的关键一步。
朱雀大模型的技术架构与核心优势解析
朱雀大模型依托于百度在自然语言处理领域的长期积累,其底层逻辑与文心一言一脉相承,但在企业级应用上进行了深度重构,业内专家指出,这种重构主要体现在对知识密度的提升和对安全边界的强化上。
混合专家架构带来的效率飞跃
不同于传统稠密模型,朱雀采用了先进的混合专家(MoE)架构,这意味着模型在推理时,并非激活所有参数,而是根据输入内容动态选择最相关的“专家”子网络进行处理。
- 资源利用率提升:这种机制使得模型在处理复杂任务时,计算资源消耗显著降低,响应速度更快。
- 成本优化:对于需要高频调用的企业场景,如智能客服或文档生成,这种架构能大幅降低推理成本。
企业级安全与数据隐私保护
数据安全是企业采用大模型的首要顾虑,朱雀大模型在设计之初就将安全作为核心指标,而非事后补丁。
- 私有化部署支持:企业可以将模型部署在本地服务器或私有云上,确保核心数据不出域。
- 内容过滤机制:内置多层内容安全过滤系统,有效识别并拦截违规、敏感信息,符合国内严格的监管要求。
朱雀大模型在垂直行业的落地场景对比
通用大模型往往“样样通样样松”,而朱雀大模型通过引入行业知识库和微调技术,在特定领域展现出更强的专业能力,以下通过几个典型场景,展示其实际应用能力。
金融领域的智能风控与研报生成
金融行业对数据的准确性和时效性要求极高,朱雀大模型在金融场景下的应用,主要体现在两个方面:
- 智能研报生成:模型能够自动抓取公开市场数据、新闻舆情和公司财报,结合内部历史数据,生成结构化的初步研报,这不仅节省了分析师大量的基础工作时间,还减少了人为遗漏关键信息的风险。
- 合规性审查:在处理合同、交易记录时,模型能快速识别潜在的合规风险点,如关联交易未披露、异常交易模式等,辅助风控团队进行决策。
制造业的设备故障预测与维护
在工业4.0背景下,朱雀大模型与物联网数据相结合,实现了从“被动维修”到“预测性维护”的转变。
- 多模态数据分析:模型不仅能处理文本日志,还能结合传感器传来的振动、温度等多模态数据,识别设备异常模式。
- 维修建议生成:当检测到潜在故障时,模型会基于海量维修手册和历史案例,生成具体的排查步骤和维修建议,降低对高级技工的依赖。
政务服务的智能化升级
政府机构在处理海量群众咨询和政策解读时,面临巨大压力,朱雀大模型通过构建本地化的知识库,提升了政务服务的效率和质量。
- 政策精准解读:群众可以用自然语言提问,模型能迅速从复杂的政策文件中提取关键信息,给出通俗易懂的回答。
- 办事流程引导:根据用户的具体情况,模型能自动匹配适用的办事流程,减少群众跑腿次数。
企业如何评估与接入朱雀大模型服务
对于考虑引入朱雀大模型的企业,评估过程需要严谨且系统,这不仅涉及技术选型,更关乎业务适配性和投资回报率的测算。
明确业务痛点与需求边界
在接触供应商之前,企业应首先梳理自身的业务痛点,是希望降低客服成本?还是提升研发效率?亦或是加强数据安全?明确需求有助于筛选合适的模型版本和服务等级。
- 高频场景优先:建议从高频、低风险的场景入手,如内部知识问答、文档摘要等,快速验证效果。
- 数据准备情况:评估企业内部数据的结构化程度和质量,高质量的数据是模型微调成功的基础。
技术对接与私有化部署流程
接入过程通常分为几个关键步骤,企业IT团队需提前做好准备。
- 环境评估:确定服务器配置、网络带宽及存储需求,确保满足模型运行要求。
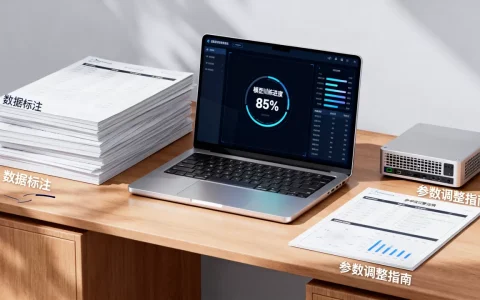
- 数据清洗与标注:对内部数据进行清洗,去除噪声,并对关键数据进行标注,用于后续的微调训练。
- 模型微调与测试:在沙箱环境中进行小规模微调,验证模型在特定任务上的表现,调整参数直至达到预期效果。
- 全量部署与监控:正式部署至生产环境,并建立实时监控机制,跟踪模型响应时间、准确率及资源消耗情况。
成本预算与长期运营考量
除了初始的授权费用,企业还需考虑长期的运营维护成本。
- 算力成本:私有化部署需要持续的硬件投入和电力消耗,需纳入长期预算。
- 人力成本:模型上线后,需要专人进行日常维护、数据更新和效果评估,这部分人力投入不容忽视。
- 迭代升级:随着技术发展和业务变化,模型需要定期迭代升级,以保持竞争力。
朱雀大模型与其他主流AI方案的对比分析
在市场上,除了朱雀大模型,还有众多开源模型和竞品闭源模型,企业如何选择,需要基于自身情况进行权衡。
与开源大模型的对比
开源模型如Llama系列等,拥有庞大的社区支持和灵活的定制能力,但对企业技术要求较高。
- 安全性:朱雀大模型在内置安全机制和合规性方面更具优势,适合对数据隐私敏感的行业。
- 服务支持:商业模型提供原厂技术支持和SLA保障,而开源模型依赖社区,问题解决周期较长。
与通用闭源模型的对比
通用闭源模型如ChatGPT等,在创意生成和多语言处理上表现优异,但在垂直领域深度和企业级服务上存在局限。
- 行业深度:朱雀大模型经过行业数据微调,在金融、制造等领域的专业术语理解和逻辑推理上更准确。
- 数据主权:通用模型的数据通常存储在云端,存在数据泄露风险,而朱雀支持私有化部署,数据完全由掌控。
朱雀大模型ai论文相关常见疑问解答
朱雀大模型与文心一言有什么区别?
朱雀大模型是百度面向企业市场推出的品牌,其底层技术源于文心一言,但在功能上更侧重于企业级应用,朱雀强调私有化部署、行业垂直优化以及更高的数据安全标准,而文心一言更偏向于面向个人用户的通用服务,朱雀是文心一言在企业场景下的深化和专业化版本。
朱雀大模型支持哪些编程语言和开发框架?
朱雀大模型主要提供API接口和SDK,支持Python、Java、C++等主流编程语言,在开发框架方面,它与PyTorch、TensorFlow等深度学习框架兼容,方便开发者进行模型微调和应用集成,百度还提供了详细的文档和示例代码,降低开发门槛。
朱雀大模型的授权模式是怎样的?
朱雀大模型通常采用按调用量计费或私有化授权许可的模式,对于大型企业,可以选择私有化部署,一次性购买授权并支付后续的维护服务费;对于中小企业,则可以通过云端API按使用量付费,灵活控制成本,具体价格因功能模块、部署方式和服务等级而异,需根据实际需求与百度商务团队沟通确定。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/379725.html

评论列表(1条)
2026年?你是从未来穿越回来的吧,这时间线都搞错,数据有问题,笑死。