

在AI大模型时代,小模型并非大模型的替代品,而是通过边缘部署、垂直领域微调及轻量化架构,在特定场景下实现更低延迟、更高隐私安全与更优成本效益的关键技术分支。
过去两年,业界对“大模型万能论”的狂热逐渐降温,转而追求“够用且好用”的实用主义,当算力成本成为企业落地的最大瓶颈,当数据隐私成为合规红线,当实时响应成为用户体验的核心指标,小模型(Small Language Models, SLMs)的价值被重新定义,它们不再是技术落后的象征,而是工程化落地的最优解。
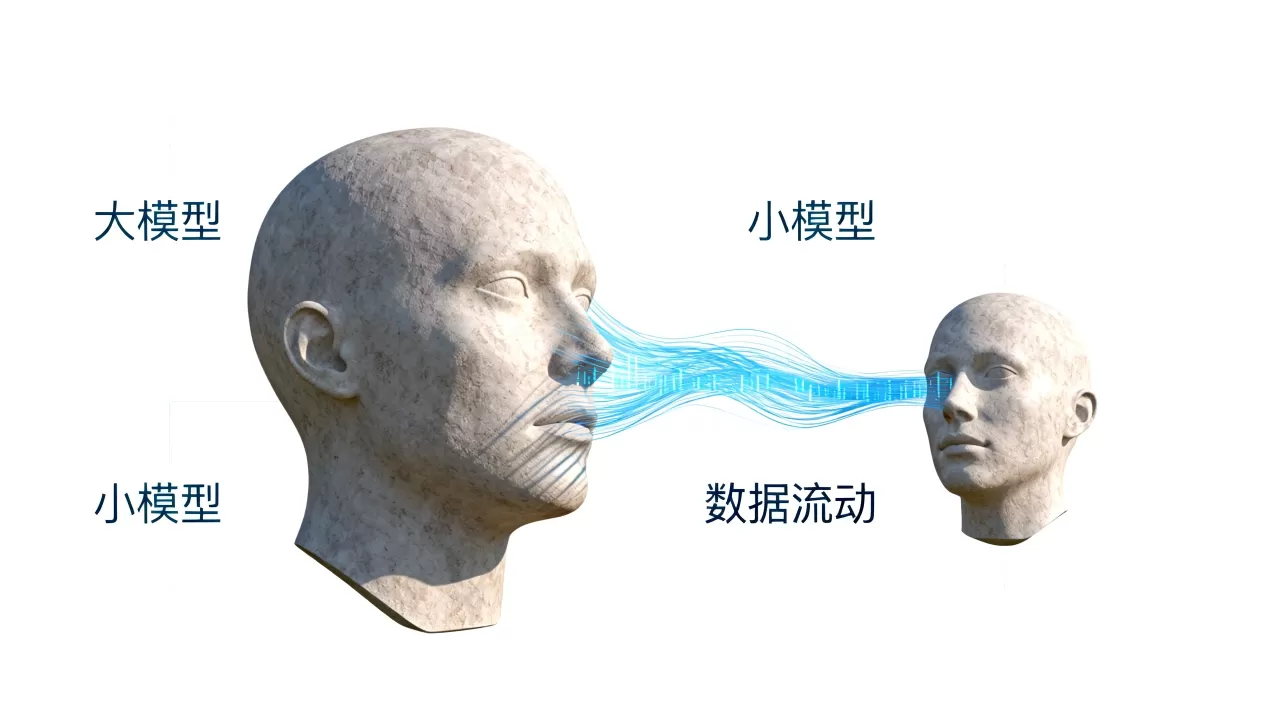
为什么选择小模型而非盲目追求大参数?
业内专家指出,模型规模的扩大并不总是带来线性收益,在大多数垂直业务场景中,参数量从百亿级降至十亿级,性能损失往往在可接受范围内,而效率提升却是指数级的。
成本与效率的极致平衡
训练和推理大模型需要昂贵的GPU集群支持,而小模型可以在普通CPU甚至移动端芯片上流畅运行。
- 推理延迟降低:小模型响应速度通常比大模型快3-5倍,这对于客服机器人、实时翻译等对时效性敏感的场景至关重要。
- 硬件门槛降低:无需高端A100或H100显卡,消费级显卡甚至嵌入式设备即可部署,大幅降低基础设施投入。
- 能耗显著减少:单次推理能耗下降70%以上,符合绿色计算趋势,尤其适合大规模并发场景。
数据隐私与本地化部署优势
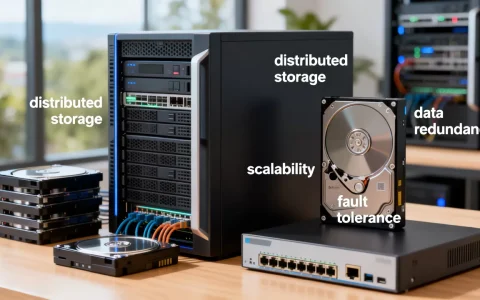
在金融、医疗、政务等敏感领域,数据出境或上云存在合规风险,小模型支持完全本地化部署,数据不出域,从根源上解决隐私泄露担忧。
- 数据隔离:所有训练和推理过程在本地服务器完成,无需连接外部API。
- 合规性强:满足GDPR、中国数据安全法等严格法规要求,避免数据滥用风险。
- 自主可控:企业拥有模型完全控制权,可根据业务变化随时调整,不受第三方服务商限制。
小模型的核心应用场景与落地策略
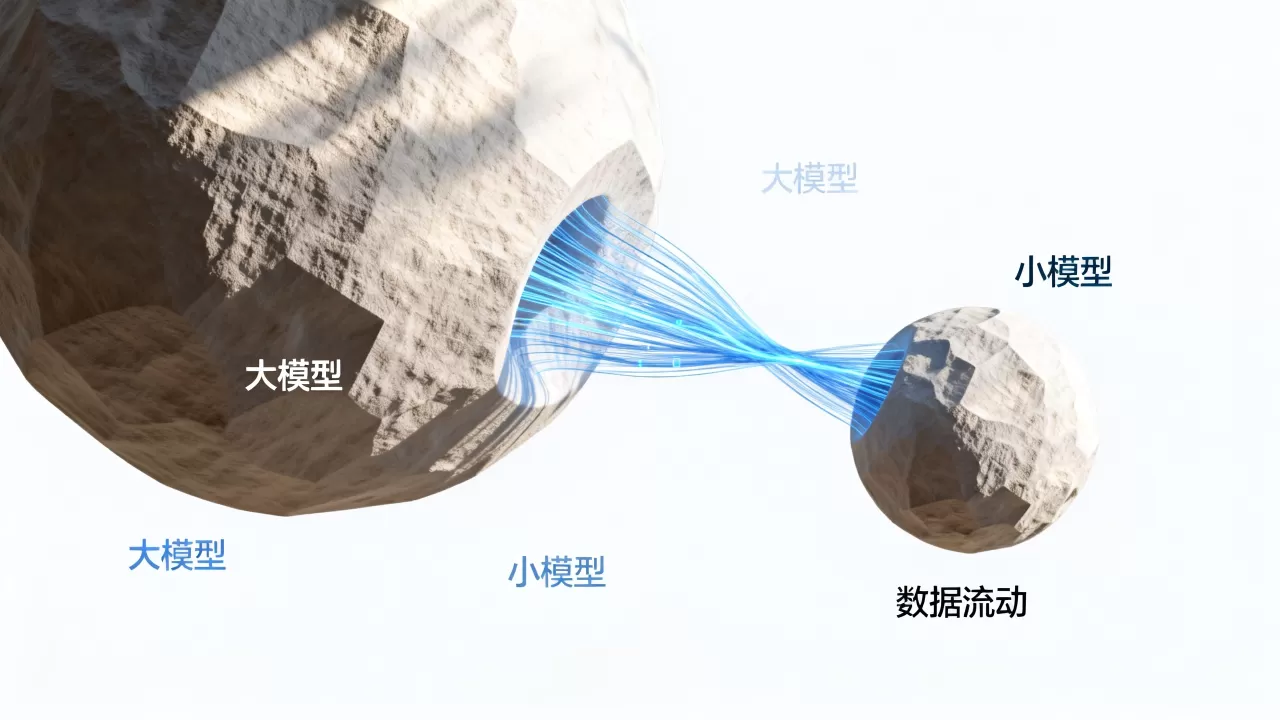
小模型并非适用于所有场景,其优势在特定领域尤为突出,理解这些场景,才能精准选型。
垂直领域知识增强
通用大模型在特定行业(如法律、医疗、编程)往往缺乏深度知识,且容易产生幻觉,通过小模型进行领域微调,可以构建高精度的专业助手。
- 法律合同审查:使用10亿参数以下的小模型,针对法律条文进行微调,准确率可达90%以上,且响应速度满足实时审查需求。
- 医疗辅助诊断:基于本地电子病历数据微调小模型,辅助医生进行初步分诊和病历生成,同时确保患者隐私。
- 代码生成与优化:针对特定编程语言或内部框架,微调小模型可提供更精准的代码补全和Bug检测,减少上下文窗口限制。
边缘设备与物联网应用
在智能家居、工业物联网、自动驾驶等边缘计算场景中,网络带宽和延迟是主要瓶颈,小模型可直接部署在终端设备,实现离线智能。
- 智能音箱语音交互:本地运行小模型进行语音识别和指令执行,无需联网,响应更快,隐私更安全。
- 工业缺陷检测:在生产线摄像头端部署视觉-语言小模型,实时识别产品缺陷,减少云端传输延迟。
- 车载智能助手:在车机芯片上运行小模型,提供离线导航、语音控制等功能,保障驾驶安全。
个性化推荐与内容生成
小模型可根据用户行为数据快速微调,提供高度个性化的内容生成和推荐服务。
- 电商营销文案:根据商品特点和用户画像,快速生成个性化营销文案,提升转化率。
- 社交媒体内容创作:基于用户历史偏好,生成符合其风格的短视频脚本或图文内容。
- 个性化学习路径:根据学生答题情况,动态调整学习内容和难度,提供定制化教育服务。
如何构建和优化小模型?实操指南
构建小模型并非简单缩小参数量,而是需要一系列工程化手段,以下是关键步骤。
模型选择与架构设计
选择合适的小模型架构是第一步,目前主流选择包括Llama-3-8B、Qwen-7B、Mistral-7B等。
- 参数量权衡:根据任务复杂度选择7B、13B或更小参数量的模型,简单任务可选1B-3B,复杂推理需7B以上。
- 注意力机制优化:使用FlashAttention等高效注意力机制,提升推理速度。
- 稀疏化技术:采用MoE(混合专家)架构,仅在推理时激活部分专家,降低计算量。
数据准备与清洗
高质量数据是小模型成功的关键,小模型泛化能力弱,更依赖高质量、高相关性的训练数据。
- 数据清洗:去除噪声、重复和低质量数据,确保训练数据纯净。
- 指令微调数据构建:构建高质量的指令-响应对,涵盖目标场景的多样性和复杂性。
- 数据增强:通过回译、同义词替换等技术扩充数据多样性,提升模型鲁棒性。
微调技术与工具链
全量微调成本高,通常采用参数高效微调技术。
- LoRA/QLoRA:低秩自适应微调,仅需训练少量参数,大幅降低显存需求,QLoRA可在单张消费级显卡上微调7B模型。
- P-Tuning:提示微调,通过优化前缀向量适应特定任务,无需更新模型权重。
- 工具链选择:使用Hugging Face Transformers、PEFT、vLLM等成熟工具链,简化开发流程。
量化与部署优化
部署阶段需进一步优化模型,以适配不同硬件环境。
- INT4/INT8量化:将模型权重从FP16量化为INT4或INT8,减少显存占用,提升推理速度,精度损失极小。
- 算子融合:使用TensorRT、ONNX Runtime等推理引擎,融合算子,提升执行效率。
- 动态批处理:根据请求负载动态调整批处理大小,最大化吞吐量。
常见误区与避坑指南
在落地小模型过程中,企业常陷入一些误区,需警惕。
小模型性能一定差
事实是,在特定领域,经过充分微调的小模型性能可媲美甚至超越未微调的大模型,关键在于数据质量和微调策略。
无需数据清洗
小模型对噪声数据更敏感,脏数据会导致模型过拟合或产生错误输出,数据清洗至关重要。
一次微调永逸
业务场景和数据分布会随时间变化,需定期更新微调数据,重新训练或增量微调,保持模型时效性。
未来趋势:小模型与大模型的协同进化
小模型不会孤立存在,而是与大模型形成协同生态。
- 模型路由:复杂任务由大模型处理,简单任务由小模型处理,通过智能路由系统优化资源分配。
- 蒸馏与知识迁移:利用大模型生成高质量合成数据,用于训练小模型,实现知识蒸馏。
- 端云协同:小模型在端侧处理实时、隐私敏感任务,大模型在云端处理复杂、长尾任务,形成互补。
据工信部数据,随着边缘计算技术的普及,小模型在终端设备的部署比例将持续上升,企业应摒弃“唯大模型论”,根据自身需求,理性选择模型规模,实现技术价值与商业效益的最大化。
AI大模型下的小模型常见问题解答
小模型在中文场景下的表现如何?
近年来,主流开源小模型如Qwen、Baichuan、Yi等在中文理解与生成能力上已接近甚至超越部分国外大模型,通过高质量的中文指令微调,小模型在中文对话、翻译等任务上表现优异,完全满足国内企业应用需求。
小模型的训练成本大概是多少?
小模型训练成本远低于大模型,使用LoRA等技术,在单张A100或消费级4090显卡上,微调7B模型仅需数小时至数天,成本可从数万元降至数百元甚至更低,具体取决于数据规模和训练轮数。
小模型是否会被大模型取代?
不会,小模型凭借低延迟、低成本、高隐私优势,在边缘计算、实时交互、垂直领域等场景具有不可替代性,未来将是大小模型协同工作的时代,各自发挥优势,而非相互取代。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/378942.html


评论列表(1条)
看到数据隐私我就破防了…以前总以为他懂我,原来只是我没把真心部署在核心层😭 为什么男生都这么会算计成本