

大模型AI底层框架是支撑人工智能从“聊天机器人”进化为“智能体”的核心基础设施,其本质是通过Transformer架构、大规模预训练及强化学习对齐技术,实现从海量数据到逻辑推理能力的跨越。
很多人对大模型的理解还停留在“能写文章、能画图”的工具层面,但实际上,支撑这些能力的是一套极其复杂且精密的底层架构,这套架构就像是一座摩天大楼的地基和承重结构,决定了上层应用能跑多快、多稳、多聪明,对于开发者、企业技术负责人以及关注技术趋势的从业者来说,理解这套框架不仅是为了跟上热点,更是为了在2026年这个AI应用爆发期找到正确的技术选型方向。
大模型AI底层框架的核心架构解析
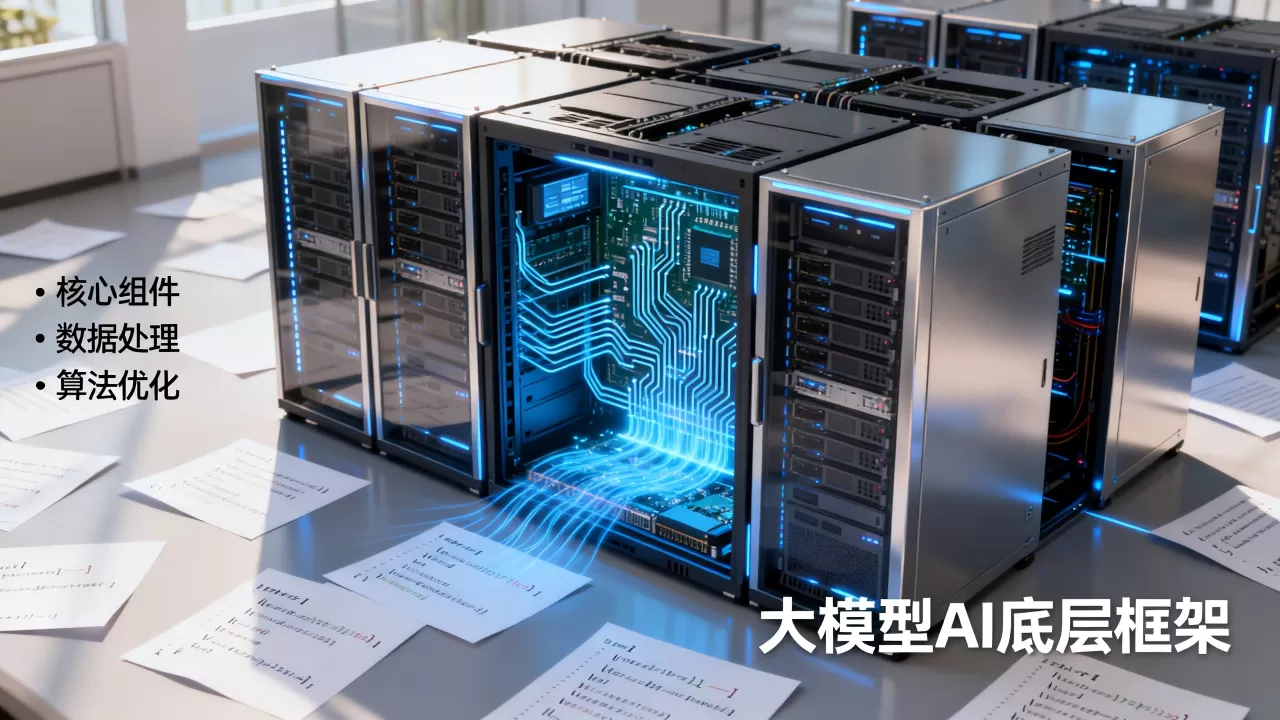
要搞清楚底层框架,我们得先拆解它的“骨架”,现在的通用大模型,绝大多数都基于Transformer架构,但这只是起点,一个完整的底层框架通常包含三个关键层级:基础模型层、对齐优化层和应用接口层。
基础模型层:数据与算力的交响
这一层是整个系统的基石,业内专家指出,基础模型的性能上限主要取决于两个因素:数据的质量和算力资源的调度效率。
- 数据工程:这不仅仅是把网页爬下来那么简单,高质量的数据清洗、去重、格式化,以及构建指令微调数据集,决定了模型是否“聪明”,据工信部相关技术白皮书显示,经过精心构建的高质量指令数据集,能显著提升模型在复杂任务上的表现。
- 算力调度:训练一个大模型需要成千上万张GPU卡协同工作,底层框架必须解决分布式训练中的通信瓶颈、显存优化等问题,使用ZeRO(Zero Redundancy Optimizer)技术来减少显存占用,或者利用混合精度训练来加速计算过程。
对齐优化层:让机器“懂人话”
预训练模型虽然博学,但往往“有问必答”,甚至胡说八道,对齐优化层的作用,就是给模型装上“刹车”和“方向盘”,让它符合人类的价值观和逻辑习惯。
- RLHF(基于人类反馈的强化学习)
:这是目前最主流的对齐方式,通过人工标注员对模型输出进行打分,训练一个奖励模型,再用这个奖励模型去优化大模型,这个过程就像教小孩走路,摔倒了(输出不好)就纠正,走稳了(输出好)就鼓励。
- DPO(直接偏好优化):相比RLHF,DPO更简单高效,它不需要单独训练奖励模型,而是直接通过对比偏好数据来优化策略模型,近年来,越来越多的开源社区倾向于使用DPO,因为它减少了训练步骤,降低了算力成本。
技术选型与部署:企业如何落地大模型?
对于企业而言,选择什么样的底层框架,直接决定了项目的成败,这里没有绝对的“最好”,只有“最适合”,我们需要对比几种主流的技术路径,看看它们各自适合什么场景。
开源框架 vs 闭源API:成本与控制的博弈
这是许多CTO在立项时最纠结的问题,开源框架如Llama、Qwen等,提供了极高的灵活性和数据隐私安全性;而闭源API如百度文心一言、阿里通义千问等,则提供了开箱即用的稳定性和强大的生态支持。
| 对比维度 | 开源框架部署 | 闭源API调用 |
|---|---|---|
| 初始投入 | 高(需购买服务器、显卡) | 低(按Token付费) |
| 数据隐私 | 极高(数据不出域) | 中(数据需传输至云端) |
| 维护成本 | 高(需专业运维团队) | 低(服务商负责维护) |
| 定制能力 | 强(可微调底层逻辑) | 弱(主要靠Prompt工程) |
私有化部署的实操路径
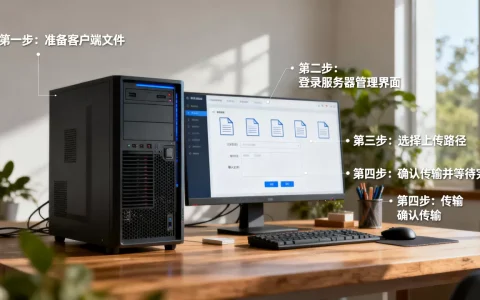
如果企业涉及金融、医疗等敏感行业,数据隐私是红线,那么私有化部署是必然选择,具体的操作路径通常包括:
- 硬件准备:至少需要配备8张A100或H100显卡,或者使用国产替代方案如华为昇腾910B集群。
- 环境搭建:使用Docker容器化部署,安装PyTorch、CUDA等基础依赖。
- 模型加载:通过Hugging Face或ModelScope下载模型权重,使用vLLM或TGI等推理加速框架进行加载。
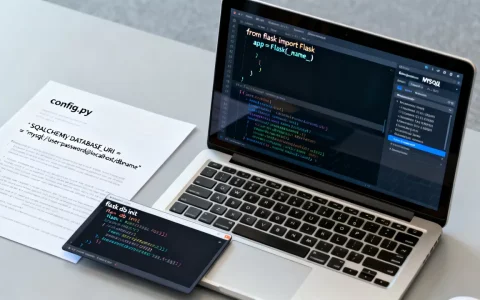
- 服务封装:使用FastAPI或Flask将模型封装为RESTful API,供前端调用。
2026年趋势:多模态与智能体的崛起
站在2026年的视角回望,大模型AI底层框架正在经历一场深刻的变革,单纯的文本生成已经无法满足需求,多模态理解和智能体(Agent)能力成为新的竞争高地。
多模态融合:从“看”到“懂”
现在的底层框架不再局限于处理文本,而是能够同时理解图像、音频、视频甚至3D点云,这种能力的提升,得益于跨模态编码器(Cross-Modal Encoder)的引入,当用户上传一张复杂的财务报表图片时,模型不仅能识别其中的文字,还能理解表格结构、数据趋势,并生成分析报告。
据行业共识认为,多模态大模型在医疗影像诊断、工业质检等垂直领域的准确率,已经接近甚至超过了人类专家水平,这意味着,底层框架必须具备更强的特征对齐能力,将不同模态的数据映射到同一个语义空间。
智能体架构:从“问答”到“行动”
智能体是大模型进化的下一个形态,它不仅能回答问题,还能调用工具、执行任务、规划步骤,底层框架需要支持Agent的核心能力:
- 规划能力:将复杂任务拆解为子任务。“帮我策划一次旅行”,框架需要自动拆解为“查询目的地天气”、“搜索机票酒店”、“生成行程单”等步骤。
- 工具调用:通过Function Calling机制,让模型能够调用外部API,比如调用地图API查询路线,调用数据库API查询库存。
- 记忆机制:引入向量数据库(Vector DB),让模型拥有长期记忆,这样,在多轮对话中,模型能记住用户之前的偏好和历史行为,提供更个性化的服务。
常见问题解答:大模型AI底层框架实战指南
大模型AI底层框架如何选择适合中小企业的方案?
中小企业通常没有足够的算力资源进行大规模预训练,因此不建议从头训练模型,最佳实践是采用“开源基座模型 + 行业数据微调 + API封装”的模式,选择参数量在7B-13B之间的开源模型(如Llama-3-8B或Qwen-7B),这类模型在消费级显卡上即可运行,使用企业的私有数据(如客服记录、产品手册)进行LoRA微调,成本极低且效果显著,通过API接口集成到现有业务系统中,这种方案既保证了数据隐私,又控制了成本,据相关技术社区统计,多数采用此方案的企业在6个月内即可实现ROI转正。
大模型AI底层框架在金融风控场景下的数据隐私如何保障?
金融场景对数据隐私要求极高,底层框架需采用联邦学习或多方安全计算技术,联邦学习允许在不共享原始数据的前提下,联合训练模型,各参与方保留数据本地,仅上传模型梯度更新,从而确保数据不出域,结合差分隐私技术,在梯度中添加噪声,进一步防止逆向工程泄露敏感信息,国内多家头部银行已采用此类架构,实现了风控模型的协同训练,同时满足了监管合规要求。
大模型AI底层框架的推理成本如何优化?
推理成本是大模型落地的一大痛点,优化策略主要集中在量化和缓存两个维度,量化技术(如INT8、FP4)可以将模型权重压缩,减少显存占用和计算量,通常能带来2-4倍的推理速度提升,且精度损失极小,缓存技术(如KV Cache)则通过复用历史对话的上下文信息,避免重复计算,对于高频调用的固定场景,还可以采用模型蒸馏技术,将大模型的知识迁移到小模型中,进一步降低推理延迟和成本。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/378858.html

评论列表(1条)
卧槽,说能进化成智能体,我昨天让 AI 帮我倒垃圾它直接给我讲量子力学,这逻辑跨越是咋跨的?