AI大模型产品研发难吗?如何从零开始构建AI大模型

AI大模型产品研发的核心在于构建从数据清洗、微调训练到推理优化的完整闭环,成功的关键并非单纯追求参数量,而是通过高质量垂直数据与高效算力调度实现场景化落地。

AI大模型研发的基础设施与数据治理

研发一款具备竞争力的AI大模型,第一步往往不是写代码,而是“喂”数据,业内专家指出,数据质量直接决定了模型的智商上限,在2026年的技术语境下,通用语料已接近饱和,真正的壁垒在于垂直领域的高质量私有数据。

LLMs-Zero-to-Hero,完全从零手写大模型,从数据处理到模型训练,细节拉满,一小时学会。 build a nanoGPT from scratch
加载中
LLMs-Zero-to-Hero,完全从零手写大模型,从数据处理到模型训练,细节拉满,一小时学会。 build a nanoGPT from scratch

数据清洗的工程化路径

原始数据如同未经提炼的矿石,直接投入训练会导致模型产生幻觉或偏见,研发团队需要建立自动化流水线,执行以下关键步骤:

  • 去重与去噪:利用MinHash算法快速识别并移除重复样本,剔除HTML标签、乱码及低质量网页内容。
  • 隐私合规过滤:通过正则表达式与NLP实体识别技术,精准抹去姓名、身份证号、银行卡号等PII(个人身份信息)数据。
  • 逻辑一致性校验:针对指令微调数据,人工或半自动标注团队需确保“指令-输入-输出”三元组的逻辑严密性,避免训练出“答非所问”的模型。

算力资源的成本博弈

算力是大模型研发的血液,对于大多数企业而言,AI大模型研发成本分析是立项前必须跨越的门槛。

  • 训练阶段:需要大规模GPU集群(如H100或国产等效芯片),显存带宽成为瓶颈,建议采用混合精度训练(FP16/BF16)以平衡速度与精度。
  • 推理阶段

    AI大模型产品研发难吗?如何从零开始构建AI大模型

    :部署时需考虑并发量与延迟要求,对于高并发场景,量化技术(如INT8/INT4)能显著降低显存占用,提升吞吐量。

据工信部相关数据显示,近年来头部云服务商的GPU实例价格波动较大,企业应建立弹性算力调度机制,闲时释放资源,忙时自动扩容,以控制总体拥有成本(TCO)。

模型微调与场景化适配策略

通用大模型虽然博学,但在特定行业往往显得“外行”,将通用模型转化为行业专家,需要通过微调(Fine-tuning)技术进行深度适配。

参数高效微调(PEFT)实战

全量微调成本高昂且易导致灾难性遗忘,目前行业共识认为,LoRA(低秩自适应)及其变体是性价比最高的选择。

  1. 准备指令数据集:构建包含数百至数千条高质量行业问答对或任务示例。
  2. 配置LoRA参数:设置秩(rank)为8或16,注意力层(attention layers)作为微调目标。
  3. 训练监控:关注验证集Loss曲线,防止过拟合,通常训练5-10个Epoch即可达到饱和。
  4. 合并权重:训练完成后,将LoRA适配器权重合并回基座模型,生成专用模型文件。

检索增强生成(RAG)的必要性

对于需要实时信息或严格事实依据的场景,单纯依靠模型内部知识是不够的。AI大模型应用场景对比显示,RAG架构在金融研报分析、法律条文检索等场景中表现优异。

  • 向量数据库构建:将企业文档切片(Chunking),嵌入向量空间,建立索引。
  • 检索策略优化

    AI大模型产品研发难吗?如何从零开始构建AI大模型

    :采用混合检索(关键词+向量),提升召回准确率。

  • 重排序(Rerank):使用轻量级重排序模型对召回结果进行打分,确保输入给LLM的上下文最相关。
  • 提示词工程:在Prompt中明确引用来源,要求模型基于给定上下文回答,严禁胡编乱造。

评估体系与商业化落地

模型开发完成后,如何证明它好用?建立科学的评估体系是连接技术与市场的桥梁。

自动化评估指标

除了传统的BLEU、ROUGE分数,2026年更关注语义理解与逻辑推理能力。

  • MMLU与GSM8K:衡量通用知识与数学推理能力。
  • 领域专属基准:构建内部测试集,涵盖典型业务Case,由专家打分或采用LLM-as-a-Judge模式进行自动化评估。
  • 安全红线测试:通过对抗性提示(Adversarial Prompts)测试模型的鲁棒性,确保其不会输出违规、有害内容。

部署与运维优化

模型上线只是开始,持续运维才是长久之计。

  • 模型压缩:使用知识蒸馏(Knowledge Distillation)将大模型能力迁移至小模型,降低推理成本。
  • 服务化封装:将模型封装为RESTful API或gRPC服务,集成鉴权、限流、日志监控模块。
  • 反馈闭环:收集用户实际使用中的Bad Case,定期重新训练模型,实现迭代优化。

据行业统计,多数成功落地的AI产品,其后期维护与迭代投入约占项目总预算的30%-40%,建立自动化的数据回流机制至关重要。
AI大模型产品研发难吗?如何从零开始构建AI大模型

常见误区与避坑指南

在AI大模型研发过程中,许多团队容易陷入以下误区:

  • 盲目追求参数规模:参数量并非越大越好,对于特定任务,7B或13B模型配合优质数据往往优于70B模型。
  • 忽视数据版权风险:使用未经授权的开源数据或受版权保护的内容进行训练,可能引发法律纠纷,务必使用合规数据源或自行采集。
  • 低估提示词工程的重要性:即使拥有最强模型,糟糕的Prompt也会导致输出不可用,提示词优化应贯穿研发全程。

AI大模型研发常见问题解答

AI大模型研发周期需要多久?

研发周期取决于目标复杂度与资源投入,基座模型预训练通常需数月甚至数年,而基于开源基座进行垂直领域微调,若数据准备充分,AI大模型研发周期可缩短至2-4周,加上数据清洗、评估与部署,完整项目通常需1-3个月。

中小企业如何选择AI大模型方案?

中小企业应优先考虑SaaS化API服务或开源微调方案,直接训练基座模型成本过高且不现实,建议先通过API调用验证业务可行性,积累数据后,再考虑使用LoRA等技术对开源模型(如Llama 3、Qwen等)进行私有化微调,以平衡成本与定制化需求。

AI大模型研发需要哪些核心技能?

核心团队需具备深度学习框架(PyTorch)开发能力、大规模分布式训练经验、NLP算法优化能力以及工程化部署能力,领域专家(Domain Expert)的介入不可或缺,他们负责定义任务边界与评估标准,确保模型输出符合业务逻辑。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/377691.html

赞 (0)
腾讯cdn欠费了怎么办?酷番云cdn欠费
上一篇 2026年6月13日 20:21
字节内部大模型AI是什么?大模型AI技术原理详解
下一篇 2026年6月13日 20:23

相关推荐

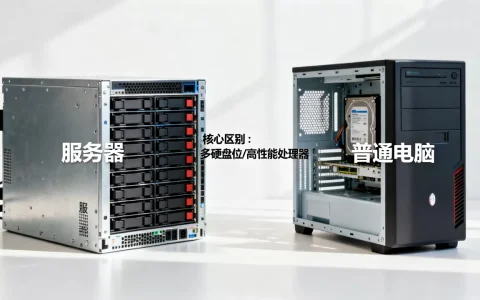
  • 服务器到底相当于一个主机吗,和普通电脑有什么区别?

    服务器本质上就是一台高性能、高稳定性的主机,但它的设计目标和工作负载与普通电脑主机完全不同, 服务器主机是专门为7×24小时不间断运行、处理大量并发请求而生的专业设备,而普通电脑主机更多是为个人桌面办公设计的,两者虽然核心硬件相似,但在可靠性、扩展性和管理能力上有着天壤之别,服务器和普通电脑主机有什么区别?硬件……

    2026年7月26日
    700
  • IDC LOL服务器如何防护安全, 支持防护本地IDC服务器吗

    对于IDC中的LOL游戏服务器,HSS(主机安全服务)完全能够通过混合云部署模式实现有效防护,关键在于安装兼容的安全代理并配置专属策略, 所谓HSS,是云服务商提供的主机安全产品,最初设计用于云服务器,但近年来已扩展至本地IDC场景,形成统一的混合云安全管理方案,HSS是否支持防护本地IDC服务器?混合云部署给……

    2026年8月21日
    300
  • informatical _

    informatical_作为面向零基础转行人群的在线编程实训平台,整体课程质量和答疑服务在行业内属于中上水平,但它的核心价值不在证书,而在项目实操和就业导向的刻意练习, 这一点在2026年的IT培训市场里依然成立,因为企业招聘越来越看重候选人能上手做什么,而不是听你背多少个概念,informatical_平台……

    2026年8月21日
    300
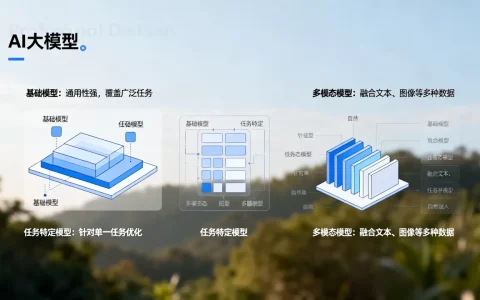
  • ai大模型有哪些类别?主流ai大模型分类及特点

    2026年AI大模型主要分为通用基础大模型、垂直行业大模型以及端侧轻量化大模型三大类,选择时需根据算力成本、数据隐私及具体业务场景进行匹配,如今提到人工智能,大家脑海里浮现的往往是能写代码、能画图甚至能聊天的“全能选手”,但如果你真的打算把这些技术落地到企业或个人项目中,会发现“大模型”这个词背后其实有着严格的……

    2026年6月15日
    5900
  • 服务器配置和性能如何选?服务器配置与性能优化技巧

    服务器配置和性能的核心在于根据业务场景精准匹配资源,避免“高配低用”或“低配高负载”,通过合理的CPU、内存、存储及网络架构优化,可实现成本与效率的最佳平衡,在数字化浪潮席卷全球的今天,服务器早已不再是冷冰冰的铁皮箱子,而是企业数字资产的“心脏”,很多站长或运维新手常陷入一个误区:认为服务器越贵、配置越高,网站……

    2026年7月5日
    19800
  • 大模型部署容灾备份方案

    大模型部署容灾备份的核心在于构建“本地高可用+异地冷备+实时同步”的三层架构,确保在单点故障或灾难发生时,业务中断时间控制在分钟级,数据丢失率为零,当企业将大模型从实验阶段推向生产环境,稳定性就不再是加分项,而是生存底线,想象一下,你的核心业务逻辑完全依赖一个千亿参数的大模型,突然服务器宕机,或者机房遭遇火灾……

    2026年6月18日
    2500
  • 服务器配置怎么算?2026年服务器配置计算公式大全

    服务器配置并非简单的硬件堆砌,而是基于业务并发量、响应延迟要求及预算约束的精准数学建模,核心公式为:所需资源=(峰值并发用户数×单次请求资源消耗)/ 服务器有效吞吐量 × 安全冗余系数,很多人认为买服务器就是看CPU核数和内存大小,这种线性思维在2026年的高并发场景下已经行不通了,真正的配置逻辑是一个动态平衡……

    2026年7月11日
    20800
  • iframe父子通信如何实现,原理是什么?

    iframe父子通信的核心方案是postMessage API,它是跨域场景下唯一标准且安全的消息传递机制,iframe父子通信怎么实现:postMessage是标准答案很多开发者第一次遇到iframe通信,是在嵌入第三方页面或微前端改造时,父子页面之间需要同步状态、传递用户行为数据,但浏览器同源策略把路堵死了……

    2026年8月7日
    500
  • 服务器加存储怎么配?服务器加存储配置方案

    服务器加存储是构建企业数字基础设施的核心组合,选择时需根据业务负载类型匹配计算与I/O性能,而非单纯追求硬件参数,在数字化浪潮席卷各行各业的今天,许多技术负责人在规划IT架构时,往往陷入一个误区:认为只要购买最顶级的服务器硬件,就能解决所有性能瓶颈,事实并非如此,服务器负责运算逻辑,存储负责数据吞吐,二者如同大……

    2026年7月6日
    13500
  • 大模型为何需要RLHF?大模型训练为什么需要人类反馈

    大模型需要人类反馈强化学习(RLHF),是因为单纯依靠海量数据预训练只能让模型“知道”事实,却无法保证它“懂”人类的意图、价值观和沟通礼仪,RLHF通过引入人类偏好作为奖励信号,将冷冰冰的概率预测转化为符合社会规范与用户期望的智能交互,为什么预训练后的模型还不够“聪明”大模型的诞生通常分为两个阶段:第一阶段是预……

    2026年6月22日
    3810

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注