本地AI大模型设备通过私有化部署,在保障数据绝对安全的同时,实现了低延迟的实时推理,是企业构建专属智能中枢的首选方案。
随着生成式人工智能技术的爆发,越来越多的企业和开发者意识到,将大模型直接托管在云端虽然便捷,但面临着数据泄露、网络延迟以及高昂的API调用成本等痛点,本地部署大模型设备因此应运而生,它不仅仅是一台服务器,更是数据主权与智能算力的物理载体,这种设备通常集成了高性能GPU、大容量内存以及预优化的推理框架,旨在让用户在本地环境中运行参数量从7B到70B不等的开源模型。
本地AI大模型设备选型与核心优势解析
选择本地部署方案并非简单的硬件堆砌,而是对算力、存储与网络环境的综合考量,业内专家指出,本地部署的核心价值在于“可控性”,这种可控性体现在数据安全、响应速度和长期成本三个维度。
数据安全与隐私保护的绝对壁垒
在金融、医疗、法律等敏感行业,数据合规是生命线,云端API调用意味着数据必须经过第三方服务器,即便有加密传输,仍存在理论上的泄露风险,而本地AI大模型设备将数据完全封闭在内部局域网中,数据不出域,彻底切断了外部攻击路径。
- 物理隔离:设备部署在企业内网,无需连接互联网即可运行核心推理任务。
- 权限管控:管理员可精确控制谁可以访问模型、哪些数据可以输入,实现细粒度的权限管理。
- 合规审计:所有交互日志本地留存,便于满足GDPR、《数据安全法》等法规的审计要求。
低延迟与高并发处理能力
云端推理受限于网络带宽和服务器负载,高峰期可能出现排队等待现象,本地设备通过高速互联总线(如NVLink)连接GPU,数据在内存与显存间的高速交换使得推理延迟降低至毫秒级,对于实时语音交互、即时翻译或工业质检等场景,这种低延迟体验是云端难以比拟的。
长期成本效益分析
虽然初期硬件投入较高,但对于高频使用场景,本地部署的边际成本极低,云端API通常按Token计费,随着调用量增加,费用呈线性甚至指数级增长,本地设备一旦购得,后续仅需支付电费和维护费用,无需为每次推理付费,据统计,对于日均调用量超过百万次的企业,本地部署在两年内即可收回硬件成本。
主流本地AI大模型设备硬件配置指南
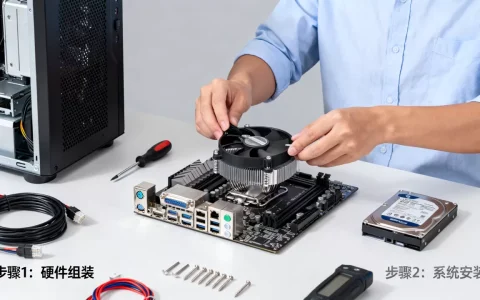
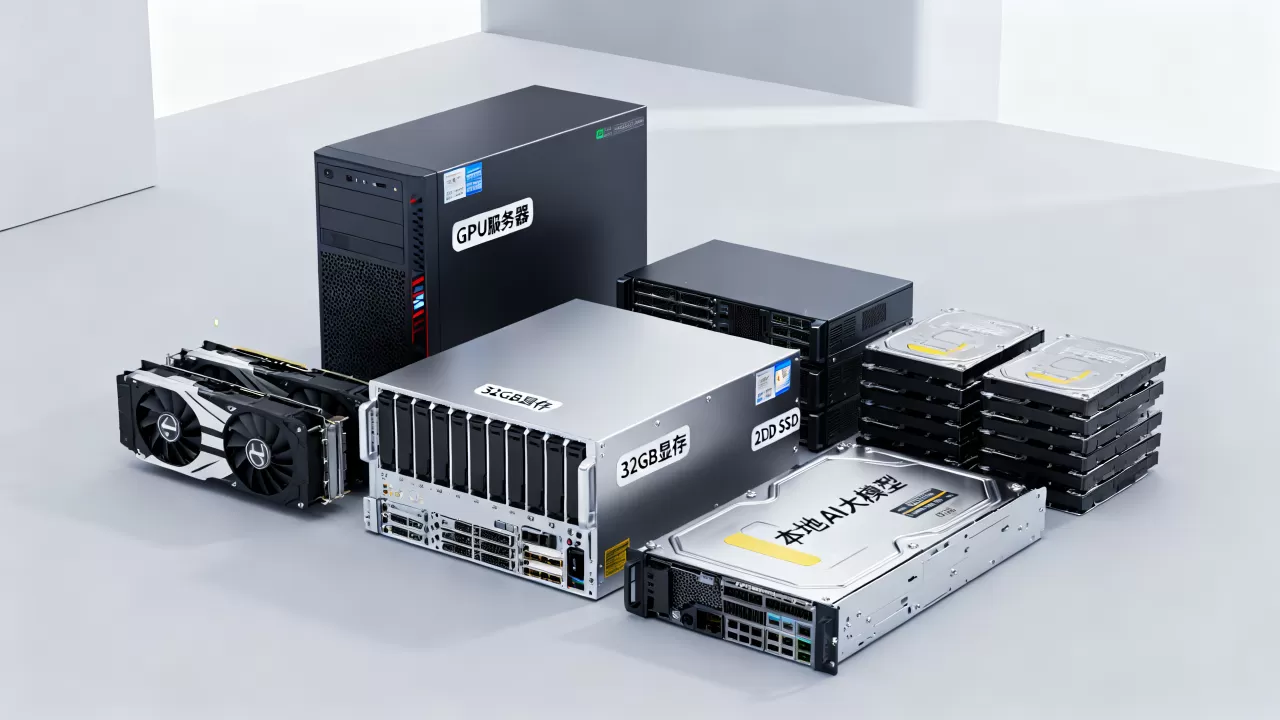
构建本地AI环境,硬件选型是关键,不同的模型参数量和量化精度对硬件资源有着截然不同的需求。
消费级显卡方案:入门级私有化部署
对于个人开发者或小型团队,单张或双张高端消费级显卡是性价比最高的选择。
- 推荐配置:NVIDIA RTX 4090 (24GB显存) 或 RTX 4080 Super。
- 适用模型:7B-13B参数量的模型(如Llama 3-8B, Qwen-7B),在INT4量化下可流畅运行。
- 优势:价格相对亲民,社区支持丰富,驱动更新频繁。
- 局限:显存容量限制了模型规模,多卡互联带宽有限,难以支撑高并发。
专业级工作站方案:中小企业首选
当需求升级到20B-70B参数量的模型,或需要更高的并发处理能力时,专业级工作站成为必要选择。
- 推荐配置:双路NVIDIA RTX 6000 Ada (48GB显存 x2) 或 A6000。
- 适用模型:33B-70B参数量的模型,INT4量化下可完整加载,INT8下可运行更小模型。
- 优势:大显存允许加载更大上下文窗口,支持更复杂的逻辑推理任务。
- 局限:初始投入较高,功耗和散热要求严格,需专用机房环境。
数据中心级方案:大型企业与机构
对于需要运行70B以上未量化模型,或需要极高吞吐量的场景,需采用数据中心级GPU集群。
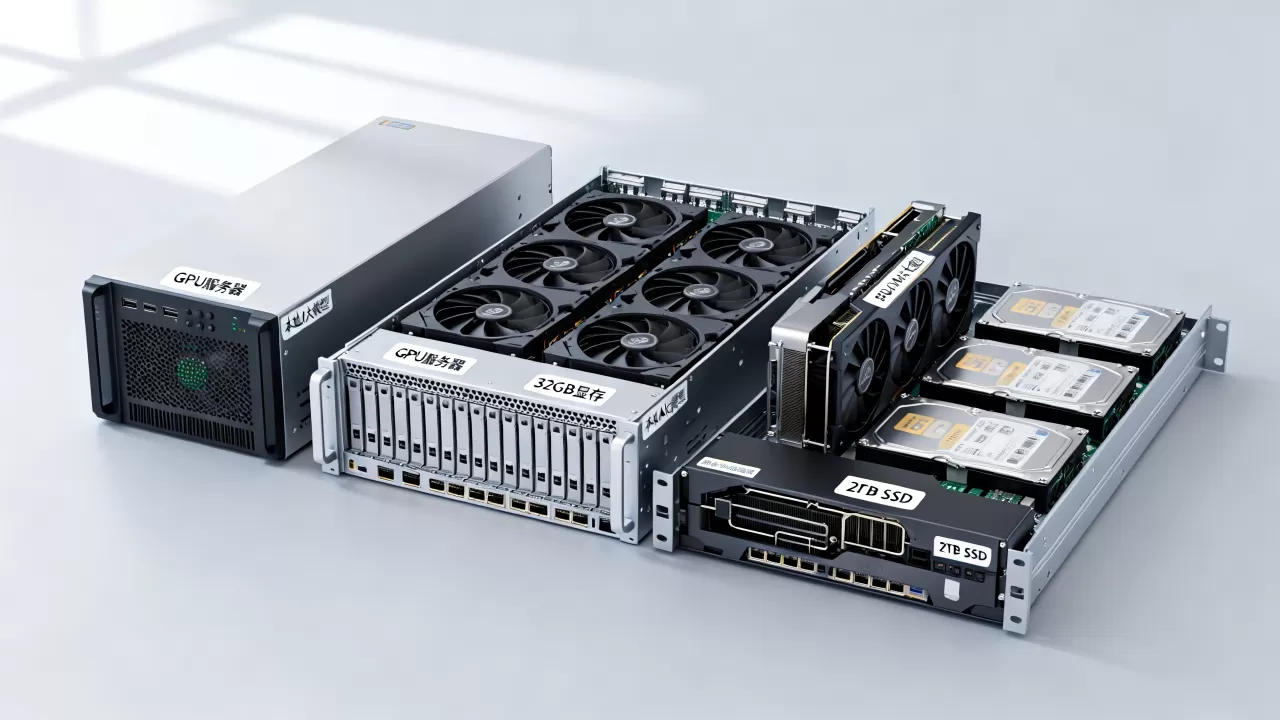
- 推荐配置:NVIDIA H100 (80GB显存) 或 A100/H800集群。
- 适用模型:70B+全精度模型,或数百亿参数量的微调模型。
- 优势:极高的算力密度和互联带宽,支持分布式推理,稳定性极强。
- 局限:成本高昂,需专业运维团队,能耗巨大。
本地AI大模型设备部署与运维实操路径
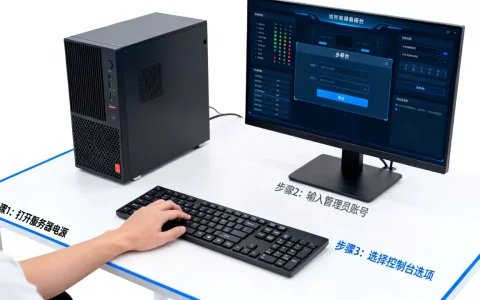
拥有硬件只是第一步,如何高效部署和运维才是发挥设备价值的核心,以下是一套标准化的部署流程。
环境搭建与框架选择
推荐使用Linux操作系统(如Ubuntu 22.04 LTS),因其对CUDA和深度学习框架支持最为完善。
- 安装CUDA与cuDNN:确保GPU驱动与深度学习库版本匹配,这是推理加速的基础。
- 选择推理引擎:
- Ollama:适合初学者,一条命令即可运行,支持模型自动下载与管理。
- vLLM:适合高并发场景,采用PagedAttention技术,吞吐量极高。
- Text Generation Inference (TGI):由Hugging Face开发,支持多种模型架构,稳定性好。
- 容器化部署:使用Docker封装应用,确保环境一致性,便于迁移和备份。
模型量化与优化技巧
为了在有限硬件上运行更大模型,量化技术不可或缺。
- INT4量化:将模型权重从16位浮点数压缩至4位整数,显存占用减少约75%,精度损失极小,是平衡性能与资源的首选。
- GGUF格式:支持CPU+GPU混合推理,即使显存不足,也可利用系统内存加载部分层,提高灵活性。
- KV Cache优化:启用PagedAttention或FlashAttention技术,显著减少显存占用并提升生成速度。
日常监控与维护
本地设备并非“装完即忘”,需定期监控运行状态。
- 显存监控:使用
nvidia-smi命令实时查看显存利用率,避免OOM(显存溢出)错误。 - 温度管理:确保机房空调或设备风扇正常工作,GPU温度过高会导致降频,影响推理速度。
- 模型更新:定期关注开源社区的新版本模型,评估是否值得升级以获得更好的性能或更低的成本。
本地AI大模型设备常见问题解答
本地AI大模型设备与云端API相比,哪个更划算?
这取决于使用频率和数据敏感度,对于低频使用、非敏感数据场景,云端API按量付费更灵活,无需前期投入,但对于高频调用、涉及核心机密数据的企业,本地设备虽然初期投入大,但长期来看,边际成本趋近于零,且能避免云端调用的潜在泄露风险,业内共识认为,日均调用量超过百万次的场景,本地部署更具经济性。
本地部署大模型需要什么样的网络环境?
本地AI大模型设备主要运行在局域网内,对外部互联网依赖较低,推理过程主要在本地硬件间进行,无需高速外网带宽,若需从Hugging Face等平台下载模型权重,或进行远程监控管理,则建议配备稳定的千兆局域网和一定的上行带宽,对于完全离线环境,需提前在联网机器下载好模型文件并通过物理介质传输。
本地AI大模型设备支持哪些主流模型?
目前主流本地设备支持绝大多数开源模型,包括Meta的Llama 3系列、阿里巴巴的Qwen(通义千问)系列、智谱的ChatGLM系列以及百川的Baichuan系列,这些模型均提供了经过优化的推理版本,兼容Ollama、vLLM等主流框架,闭源模型如GPT-4、Claude等因版权限制,无法在本地合法部署,随着开源生态的繁荣,本地可运行的模型种类正日益丰富,涵盖文本生成、代码编写、图像理解等多种任务。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/377607.html