AI大模型的演化已从单纯追求参数规模的“军备竞赛”,转向以Agent智能体、多模态融合及垂直行业落地为核心的“价值深耕”阶段,未来的竞争焦点在于谁能更低成本、更精准地解决具体业务场景中的实际问题。
回顾过去几年,人工智能的发展轨迹清晰可见,早期我们关注的是模型能不能“说话”,后来关注它能不能“画画”,现在业界更关心它能不能“干活”,这种转变并非偶然,而是技术成熟度与市场实际需求共同作用的结果,对于普通用户和企业决策者而言,理解这一演化逻辑,有助于在纷繁复杂的技术浪潮中做出更理性的选择。
从通用大模型到垂直领域专家
早期的AI大模型如同一个博览群书但缺乏专业深度的“通才”,它们能写诗、能编程、能翻译,但在医疗诊断、法律条文解析或精密制造等高度专业化领域,往往显得力不从心,这种通用性带来的副作用是幻觉率较高,且推理成本巨大。
业内专家指出,解决这一问题的关键在于“垂直化”,通过将通用大模型与特定行业的高质量私有数据进行微调(Fine-tuning),可以显著提升模型在特定任务上的准确性和专业性。
行业落地的具体路径
垂直领域的AI应用主要呈现以下三种形态:
- 知识库增强生成(RAG):这是目前企业应用最广泛的技术路径,它不改变模型本身的参数,而是将企业的私有文档、数据库作为外部知识库,让模型在回答问题时先检索相关信息,再基于这些信息进行生成,这种方式有效降低了幻觉,同时保证了数据的时效性和隐私性。
- 行业微调模型:针对金融、医疗、法律等对准确性要求极高的领域,使用经过清洗的高质量行业语料对基座模型进行二次训练,医疗大模型需要理解复杂的病历术语和诊疗指南,通用模型很难达到这一精度。
- 智能体(Agent)工作流:这是当前最前沿的方向,AI不再仅仅是一个问答机器人,而是成为一个能够自主规划、调用工具、执行任务的智能体,它可以自动完成从数据收集、分析到报告生成的全流程。
不同行业的应用差异
不同行业对AI的需求侧重点截然不同,制造业更关注生产流程优化和设备预测性维护,而零售业则侧重于个性化推荐和客服自动化,这种差异导致市场上出现了大量针对特定场景优化的模型版本。
多模态融合与具身智能的崛起
如果说垂直化解决了“懂行”的问题,那么多模态技术则解决了“感知”的问题,人类通过视觉、听觉、触觉等多种感官接收信息,早期的文本大模型只能处理文字,存在天然的感知局限。
多模态技术的突破
现在的AI大模型已经能够同时理解文本、图像、音频甚至视频,这种能力的提升带来了全新的交互体验。
- 视觉理解:模型不仅能识别图片中的物体,还能理解图片背后的逻辑关系,分析财务报表截图中的趋势,或解读医学影像中的细微病变。
- 语音交互:实时语音识别与合成的进步,使得AI助手能够进行自然、流畅的对话,甚至通过语调判断用户的情绪,提供更具同理心的回应。
- 视频生成与分析:从简单的文字生成视频,到对长视频内容进行结构化摘要,多模态技术正在重塑内容创作和监控安防等领域。
具身智能:AI拥有“身体”
当强大的大脑(大模型)遇上灵活的身体(机器人),具身智能(Embodied AI)应运而生,这不仅是科幻电影的情节,正在成为现实。
家庭服务场景
在家庭环境中,具身智能机器人可以执行复杂的家务指令,用户说“把客厅收拾一下”,机器人需要理解“收拾”的具体含义,识别杂物,规划抓取路径,并执行整理动作,这需要模型具备极强的空间推理能力和物理常识。
工业协作场景
在工厂车间,协作机器人需要与人类工人配合,大模型为机器人提供了高层级的任务规划能力,使其能够适应非结构化的工作环境,处理突发状况,而不仅仅是重复固定的机械动作。
成本控制与效率优化的关键策略
尽管AI技术日新月异,但高昂的计算成本和能耗问题依然是制约其大规模普及的主要瓶颈,对于企业而言,如何在保证效果的前提下降低使用成本,是决定项目成败的关键。
模型压缩与量化技术
为了降低推理成本,业界普遍采用模型压缩技术。
- 量化:将模型参数从高精度浮点数转换为低精度整数,可以在几乎不损失精度的情况下,大幅减少内存占用和计算量,8-bit甚至4-bit量化已成为主流。
- 剪枝:去除模型中不重要的连接和神经元,进一步减小模型体积。
- 知识蒸馏:用一个大模型(教师模型)去训练一个小模型(学生模型),让小模型学会大模型的知识,从而实现轻量化部署。
私有化部署与云端调用的平衡
企业在选择部署方式时,需要根据数据敏感度和业务需求进行权衡。
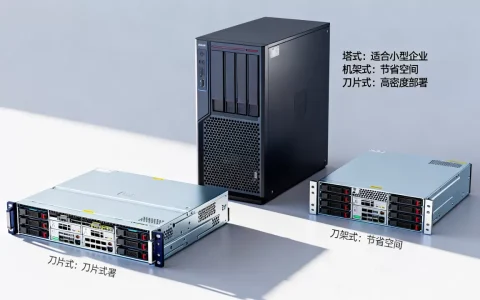
| 部署方式 | 优势 | 劣势 | 适用场景 |
|---|---|---|---|
| 公有云API调用 | 无需维护基础设施,按需付费,弹性好 | 数据隐私风险,长期调用成本可能较高 | 初创企业,非核心业务,流量波动大的场景 |
| 私有化部署 | 数据完全可控,安全性高,长期来看成本更低 | 前期投入大,需要专业的运维团队 | 金融、政务、医疗等对数据敏感的核心业务 |
据工信部数据显示,越来越多的中大型企业开始采用混合云架构,既利用公有云的弹性算力处理峰值流量,又将核心数据保留在私有环境中,以兼顾成本与安全。
未来趋势:自主智能与生态共建
展望未来,AI大模型的演化将不再仅仅是技术的迭代,更是生态的重构。
从工具到伙伴
未来的AI将不仅仅是被动执行指令的工具,而是能够主动理解用户意图、提供建议甚至发起行动的合作伙伴,这种转变要求模型具备更强的推理能力和记忆能力,能够与用户建立长期的交互关系。
开源与闭源的博弈与融合
开源社区在推动AI技术普及和创新方面发挥了巨大作用,而闭源模型则在性能和安全控制上保持领先,两者将呈现融合趋势,企业可能基于开源基座模型进行微调,同时结合闭源模型的优势能力,构建自己的专属模型。
绿色AI与可持续发展
随着模型规模的扩大,能耗问题日益突出,开发更高效的算法、利用可再生能源、优化数据中心冷却技术,将成为行业共识,绿色AI不仅是社会责任,也是降低运营成本的经济选择。
AI大模型的演化与行业应用Q&A
AI大模型的演化过程中,中小企业如何低成本接入最新技术?
中小企业无需自建庞大的算力集群,建议优先采用公有云API服务或SaaS化应用,通过选择按量付费的模式,可以避免高昂的前期硬件投入,利用RAG技术结合自身业务数据,可以在不训练大模型的情况下,快速构建具备行业知识的应用,关注开源社区的最新模型,如Llama、Qwen等,在本地轻量级设备上部署小参数模型,也是降低成本的有效途径。
多模态大模型相比传统文本模型有哪些核心优势?
多模态大模型的核心优势在于信息处理的全面性和交互的自然性,传统文本模型只能处理单一模态数据,而多模态模型能够同时理解和生成文本、图像、音频等多种信息,这使得AI能够处理更复杂的任务,如根据草图生成设计稿、通过语音指令控制智能家居等,多模态交互更符合人类习惯,降低了用户的学习成本,提升了使用体验。
AI大模型的演化对数据安全提出了哪些新挑战?
AI大模型的演化使得数据泄露的风险更加隐蔽和复杂,训练数据中可能包含敏感信息,如果模型记忆了这些数据,可能在生成过程中意外泄露,提示注入攻击(Prompt Injection)可能导致模型被恶意操控,输出有害内容或泄露系统指令,多模态数据增加了攻击面,如通过恶意图片诱导模型产生错误判断,加强数据脱敏、部署内容过滤机制、采用联邦学习等隐私计算技术,是保障数据安全的关键措施。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/376211.html