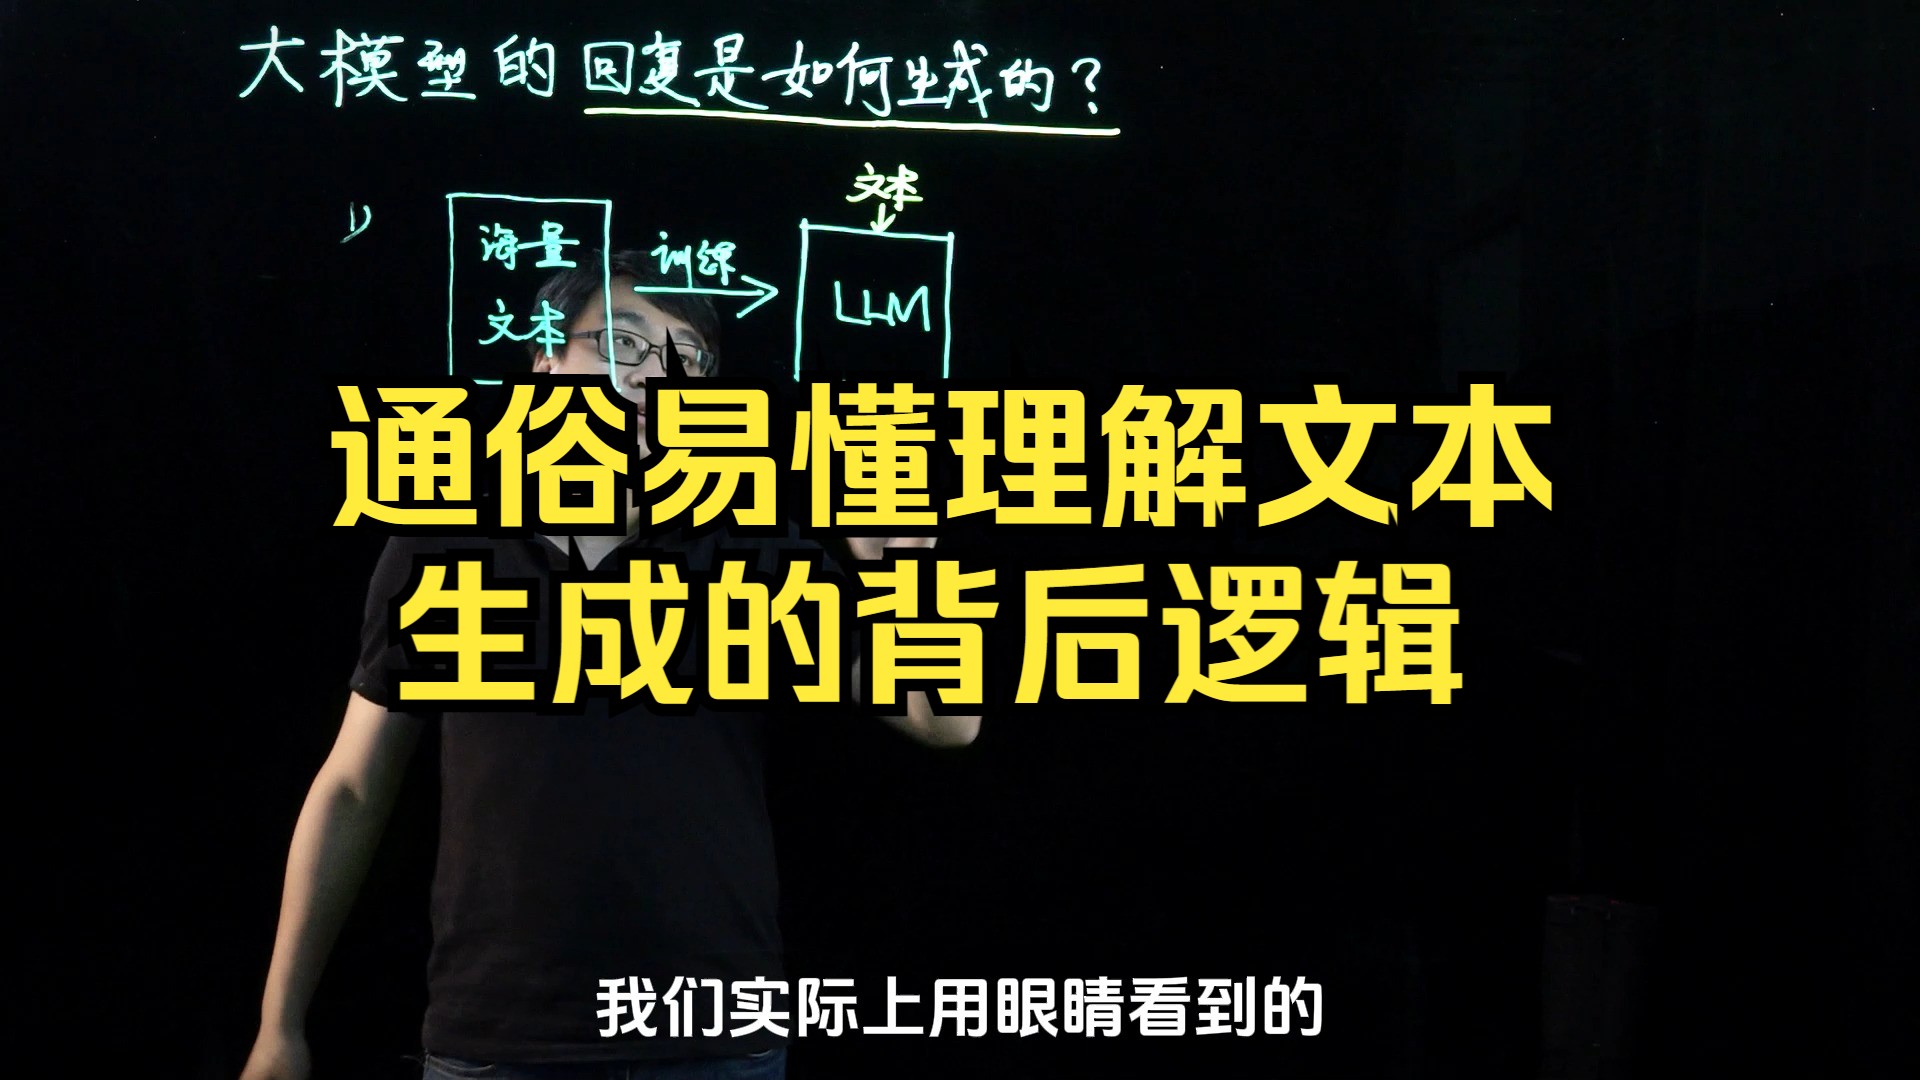
大模型AI的底层逻辑本质是基于海量数据训练的预测引擎,通过Transformer架构捕捉语义关联,以概率计算实现从“检索信息”到“生成内容”的范式转移。
很多人误以为AI像人脑一样拥有意识或真正的理解力,其实它更像是一个超级熟练的“文字接龙高手”,它并不真正知道“苹果”是什么味道,但它知道在“苹果”后面接“手机”或“好吃”的概率最高,这种基于统计学的预测机制,构成了当前所有主流大语言模型的技术基石。

Transformer架构与注意力机制揭秘
要理解大模型如何工作,必须从它的骨架Transformer架构说起,这一架构彻底改变了自然语言处理的局面,让模型能够并行处理长文本,而不是像以前的RNN那样逐字阅读。
自注意力机制的核心作用
自注意力机制(Self-Attention)是大模型的“大脑”,它让模型在处理每一个词时,都能同时关注句子中的其他所有词。
- 全局视野:传统模型只能看到上下文的一小部分,而自注意力机制让模型能一次性看清整句话的结构。
- 权重分配:模型会给不同的词分配不同的权重,比如在句子“银行位于河边”中,模型会赋予“银行”和“河边”更高的关联权重,从而区分出这里指的是金融机构还是地理实体。
- 动态理解:这种机制让模型能够根据语境动态调整对词语的理解,实现了真正的语义解析。
业内专家指出,注意力机制的引入,使得模型在处理长距离依赖关系时效率提升了数个数量级,这是大模型能够理解复杂逻辑的前提。
位置编码的重要性
由于Transformer并行处理数据,它本身不具备顺序概念,位置编码(Positional Encoding)就像给每个词发了一张带有坐标的门票,告诉模型这个词在句子中的具体位置,没有位置编码,模型就无法区分“猫追狗”和“狗追猫”的区别。
预训练与微调的技术路径对比
大模型的诞生并非一蹴而就,而是分为“预训练”和“微调”两个关键阶段,这两个阶段决定了模型的基础能力和专业表现。
预训练:构建通用知识底座
预训练阶段是模型“读书”的过程,模型在数千亿甚至万亿级的文本数据上进行无监督学习,目标是预测下一个词。
- 数据规模:数据量越大,模型的常识储备越丰富。
- 损失函数优化:通过最小化预测误差,模型不断调整内部参数,学习语言规律、事实知识和推理逻辑。
- 通用能力形成:经过预训练,模型具备了翻译、问答等通用能力,但此时它可能胡编乱造,缺乏特定领域的严谨性。
指令微调:让模型学会“听话”
预训练后的模型虽然博学,但不会按照人类指令行事,指令微调(SFT)通过高质量的人机对话数据,教会模型如何遵循指令。
- 格式规范:让模型学会区分“问题”和“回答”,并采用清晰的结构输出。
- 价值观对齐:通过人类反馈强化学习(RLHF),纠正模型的偏见和不良输出,使其更符合人类价值观。
- 场景适配:针对不同行业进行微调,如医疗、法律或编程,提升垂直领域的准确率。
近年来,许多企业开始关注大模型本地化部署成本,因为微调过程需要巨大的算力支持,这直接影响了企业的落地策略。
推理过程中的概率与温度参数
当用户输入提示词后,大模型是如何生成回复的?这背后是一个复杂的概率采样过程。
Token预测机制
模型将输入文本拆解为Token(词元),然后逐个预测下一个Token的概率分布。
- Softmax函数:将模型的原始输出转化为概率值,确保所有可能性的总和为1。
- Top-K与Top-P采样:为了避免模型总是选择概率最高的词导致回答单调,采样技术会引入随机性,Top-K限制候选词的数量,Top-P则累积概率阈值,保留高概率的词。
温度参数(Temperature)的影响
温度参数控制着模型输出的随机性和创造性。
- 低温度(如0.2):模型倾向于选择概率最高的词,回答更加确定、保守,适合事实性问答。
- 高温度(如0.8):模型会考虑概率较低的词,回答更具创意和多样性,适合创意写作。
用户在选择大模型API接口价格时,往往需要根据应用场景调整温度参数,以平衡成本与效果。
幻觉问题与事实性校验
大模型最大的痛点之一是“幻觉”,即模型自信地输出错误信息,这是因为模型本质上是基于概率生成文本,而非检索数据库。
幻觉产生的根源
- 训练数据偏差:如果训练数据中包含大量错误信息,模型会学习到这些错误。
- 过度泛化:模型在缺乏具体知识时,会尝试用相似的模式进行推测,导致产生看似合理但事实错误的内容。
- 注意力分散:在处理超长文本时,模型可能忽略关键约束条件,导致逻辑断裂。
减少幻觉的实操策略
- 检索增强生成(RAG):将大模型与外部知识库结合,先检索相关事实,再让模型基于事实生成回答,这是目前解决幻觉最有效的方法之一。
- 思维链(Chain of Thought):引导模型分步推理,而不是直接给出答案,通过展示推理过程,可以显著提高复杂任务的准确性。
- 自我反思机制:让模型在生成答案后,自己检查逻辑漏洞和事实错误,并进行修正。
对于追求高准确率的企业级AI应用开发,引入RAG架构已成为行业标准做法,因为它能确保输出内容的可追溯性和真实性。
未来趋势:从生成到行动
大模型的发展正从单纯的文本生成向多模态理解和智能体行动演进。
多模态融合
未来的模型将不再局限于文本,而是能够同时处理图像、音频、视频甚至3D模型,这种融合将极大地拓展AI的应用边界,从聊天机器人转变为全能助手。
智能体(Agent)化
大模型将具备规划、记忆和工具使用能力,它们不仅能回答问题,还能自主调用API、执行代码、操控软件,完成复杂的任务流程。
- 任务分解:将复杂目标拆解为多个子任务。
- 工具调用:根据任务需求,自动选择并调用计算器、搜索引擎或数据库。
- 自我迭代:在执行过程中根据反馈调整策略,提高成功率。
这种转变意味着AI将从“被动回答”走向“主动服务”,深刻改变我们的工作方式。
大模型底层逻辑常见问题解答
大模型真的理解语言吗?
大模型并不具备人类意义上的“理解”或“意识”,它通过统计规律捕捉词语之间的共现关系,模拟出理解的表象,它知道“国王”和“王后”在语义空间中距离很近,但并不知道它们的社会角色,这种基于概率的模拟,在大多数应用场景下足以替代人类的理解,但在需要深层逻辑推理或情感共鸣的场景中,仍显不足。
为什么大模型会一本正经地胡说八道?
这是因为大模型的目标是生成流畅且符合语法的文本,而非确保事实绝对正确,在训练过程中,模型学习了大量文本的模式,当遇到未知或模糊问题时,它会基于概率填补空白,从而产生看似合理但事实错误的“幻觉”,要解决这个问题,必须结合外部知识检索或人工校验机制,不能单纯依赖模型自身的知识储备。
小公司如何低成本使用大模型?
小公司可以通过使用开源模型进行本地微调,或采用API调用结合RAG技术来降低成本,开源模型如Llama或Qwen系列提供了强大的基础能力,无需从头训练,通过构建私有知识库,利用RAG技术增强模型的事实准确性,可以避免高昂的定制开发费用,选择按需付费的API服务,相比自建算力集群,能显著降低初期投入和运维难度。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/376136.html