

自己部署AI大模型并非高不可攀的技术黑箱,只要掌握硬件选型、环境配置与模型量化技巧,普通开发者完全可以在本地构建高效、隐私安全的专属AI助手。
随着生成式人工智能技术的爆发,云端API虽然便捷,但数据隐私泄露风险和高昂的调用成本让越来越多的企业和个人转向本地化部署,这不仅是技术趋势,更是数据主权意识的觉醒,通过本地部署,你可以彻底掌控数据流向,实现零延迟响应,并根据特定业务场景微调模型。
部署前的硬件评估与选型指南
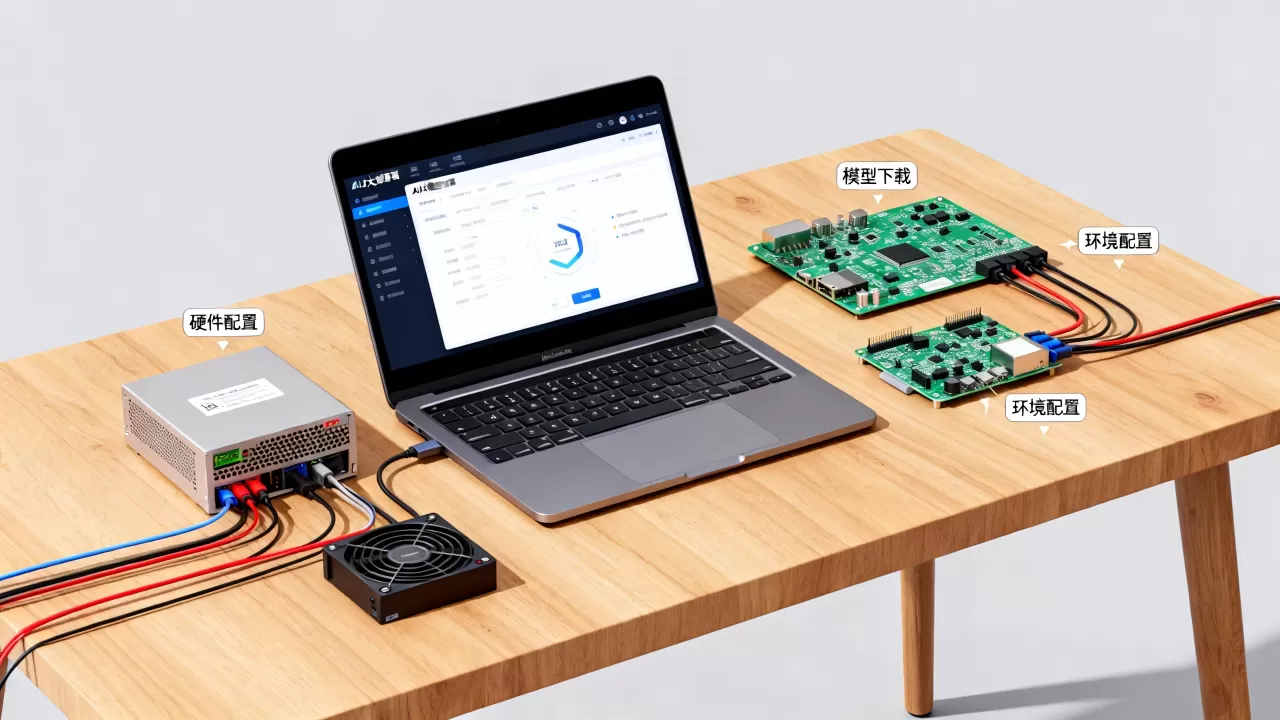
本地部署的核心瓶颈在于算力,不同于云端无限扩展的资源,本地硬件决定了你能运行多大的模型以及推理速度有多快,业内专家指出,显存(VRAM)容量是决定模型规模的硬指标,而内存带宽则直接影响推理效率。
GPU显存与模型规模的对应关系
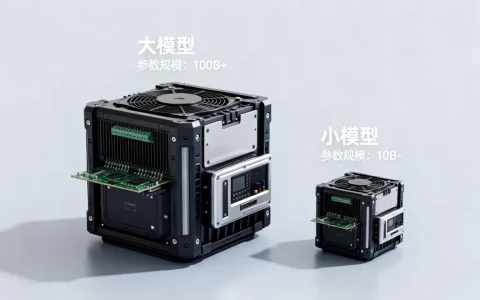
选择显卡时,必须明确模型参数量与显存占用的线性关系,16-bit精度的模型每10亿参数约占1GB显存,而8-bit量化后约占0.5GB。
- 入门级体验(4GB-8GB显存):适合运行7B以下的小参数模型,如Llama-3-8B的量化版本或Qwen-7B,这类配置适合个人学习、简单文本生成和代码补全。
- 主流进阶(12GB-24GB显存):这是目前性价比最高的区间,RTX 3090/4090拥有24GB显存,可以流畅运行13B-30B参数的模型,甚至通过模型并行技术尝试运行70B模型的量化版。
- 专业级生产(48GB+显存):对于需要处理长上下文或高精度任务的企业,多卡并联或使用A100/H100等专业卡是必要选择。
内存与存储的辅助作用
除了GPU,系统内存(RAM)和硬盘读写速度也不容忽视,在加载大型模型时,如果显存不足,系统会自动将部分层卸载到系统内存中,此时DDR4/DDR5的高带宽至关重要,NVMe SSD的高速读写能显著缩短模型加载时间,建议预留至少50GB的高速存储空间用于存放模型权重文件。
主流开源框架对比与选择策略
市面上存在多种大模型推理框架,它们各有侧重,对于初学者,选择错误框架可能导致性能损耗或兼容性问题,行业共识认为,Ollama和LM Studio是目前最友好的入门工具,而vLLM和Text Generation Inference(TGI)更适合高并发生产环境。
Ollama:极简主义的胜利
Ollama以其“一条命令启动”的特性迅速占领市场,它内置了模型管理功能,支持Mac、Linux和Windows。
- 安装便捷:下载客户端后,终端输入
ollama run llama3即可自动下载并运行。 - 模型库丰富:支持Llama 3、Mistral、Qwen等主流开源模型。
- 适用场景:个人开发者快速验证想法、本地知识库搭建。
LM Studio:可视化操作的标杆
如果你不喜欢命令行,LM Studio提供了图形化界面,它允许你浏览Hugging Face上的模型,直接预览对话效果,并调整温度、Top-P等生成参数。
- 优势:界面直观,支持GGUF格式模型的本地加载,无需编写代码。
- 劣势:在高并发请求下性能略逊于后端专用框架。
vLLM:高性能推理引擎
对于需要搭建API服务的企业,vLLM是首选,它引入了PagedAttention技术,显著提高了显存利用率和吞吐量,据统计,vLLM在LLM推理吞吐量上比传统框架高出数倍,适合处理大量并发请求。
实操步骤:从零搭建本地AI环境
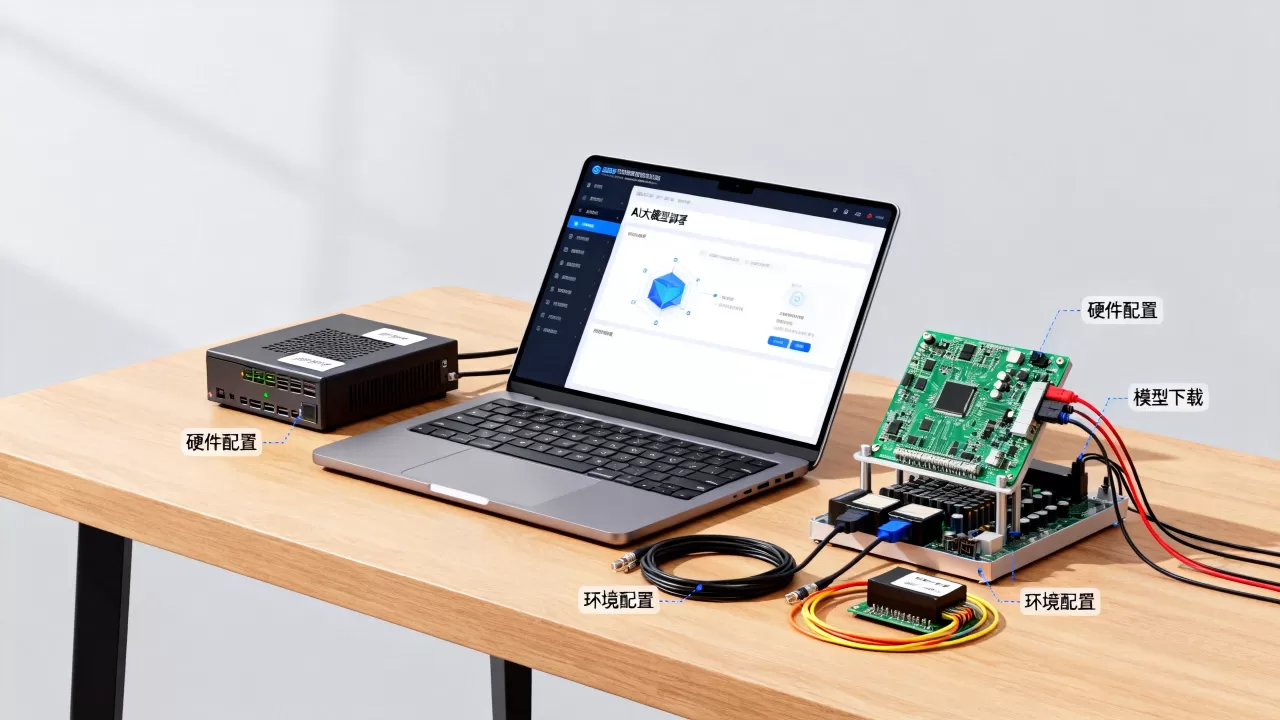
理论准备就绪后,接下来是具体的落地执行,以Windows环境下使用Ollama为例,展示完整的部署流程。
第一步:环境准备与驱动检查
确保你的NVIDIA显卡已安装最新版本的CUDA驱动,打开命令提示符,输入nvidia-smi,若能正常显示显卡信息和驱动版本,说明硬件环境就绪。
第二步:安装Ollama并拉取模型
访问Ollama官网下载对应操作系统的安装包,安装完成后,打开终端执行以下命令:
ollama pull qwen2.5:7b
该命令会自动从服务器下载量化后的Qwen2.5-7B模型,下载速度取决于网络状况,通常几分钟内即可完成。
第三步:启动服务与API调用
Ollama默认在后台运行,并提供RESTful API接口,你可以使用curl命令进行测试:
curl http://localhost:11434/api/generate -d '{
  "model": "qwen2.5:7b",
  "prompt": "请简要解释量子计算的优势",
  "stream": false
}'
返回的JSON数据中包含模型生成的文本,证明部署成功。
模型量化与性能优化技巧
在资源有限的情况下,模型量化是平衡性能与精度的关键手段,量化通过降低数据精度来减少显存占用和计算量。
常见量化格式解析
- FP16/BF16:全精度或半精度,质量最高,但显存占用大。
- INT8:将权重压缩为8位整数,显存占用减半,精度损失极小,是大多数场景的最佳平衡点。
- GGUF/GGML:Ollama和LM Studio常用的格式,支持CPU和GPU混合推理,灵活性极高。
优化建议
- 选择合适的量化等级:对于代码生成任务,建议使用INT4或INT5量化;对于创意写作,INT8或FP16能保持更好的逻辑连贯性。
- 启用GPU加速:确保框架配置中正确识别了GPU设备,避免模型在CPU上运行导致速度缓慢。
- 调整上下文窗口:过长的上下文窗口会消耗大量显存,根据实际需求,将上下文限制在4K或8K以内,可显著提升响应速度。
常见问题解答(FAQ)
自己部署ai大模型需要多少钱
部署成本主要取决于硬件投入,若已有高性能游戏电脑,仅需支付电费,成本几乎为零,若需专门购买显卡,RTX 4090价格约在1.5万-2万元人民币之间,可支撑主流模型的流畅运行,对于企业级应用,服务器集群初期投入可能在数万元至数十万元不等,但长期来看,相比按Token计费的云端API,当调用量达到一定规模后,本地部署更具经济性。
本地部署与云端API相比有什么优缺点
本地部署的核心优势在于数据隐私和安全,数据不出本地,彻底杜绝泄露风险,无网络延迟,响应速度极快,且无调用次数限制,缺点在于初始硬件投入高,维护复杂,且模型更新需手动操作,云端API则无需硬件投入,随时可用最新最强模型,但存在数据隐私顾虑,且长期调用成本较高,受网络波动影响。
如何提升本地大模型的推理速度
提升推理速度主要依靠硬件升级和软件优化,硬件上,增加显存容量和带宽是最直接的方法,软件上,使用vLLM等高性能推理框架,启用模型量化(如INT4/INT8),并合理设置批处理大小(Batch Size),关闭不必要的后台程序,确保GPU独占运行,也能显著降低延迟。
本地部署AI大模型已从极客玩具转变为实用工具,通过合理的硬件选型、框架选择和参数优化,每个人都能拥有专属的智能助手。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/375538.html

评论列表(1条)
写得真好!不过本地部署对显卡要求太高了吧,我这种只有集显的打工人只能云围观了…