AI大模型微调课程的核心价值在于通过低成本的技术手段,让通用大模型具备特定行业的专业知识与业务逻辑,从而解决企业落地AI应用时的“幻觉”与“合规”痛点,目前主流的微调方案包括全量微调、LoRA及Q-LoRA,其中LoRA因显存占用低、训练速度快成为中小企业的首选。
随着生成式人工智能技术的爆发,企业不再满足于直接调用通用大模型的接口,而是渴望拥有“懂行”的私有模型,这种需求催生了AI大模型微调课程的火热,但市面上课程质量参差不齐,许多初学者往往在环境配置和数据准备阶段就卡壳,本文将剥离营销话术,从技术选型、实操流程到成本评估,为你梳理一条清晰的学习路径。
为什么你需要学习AI大模型微调课程
通用大模型虽然博学,但在垂直领域往往显得“外行”,医疗领域的术语混淆、法律条款的误读,以及金融数据的隐私泄露风险,都是直接调用API无法解决的,业内专家指出,微调的本质是让模型“迁移学习”,将通用语言能力转化为特定领域的专业能力。
解决通用模型的局限性
通用模型缺乏对特定行业术语、内部业务流程以及企业私有数据的理解,通过微调,你可以:
- 提升回答准确率:让模型只基于你提供的知识库回答,减少胡编乱造。
- 统一输出风格:规范模型的语气、格式,使其符合品牌调性。
- 降低推理成本:微调后的小参数模型可以在本地部署,无需每次请求都调用昂贵的云端API。
职业发展的新红利
在2026年的就业市场中,单纯会调用API的工程师已不再稀缺,而掌握模型底层逻辑、具备数据清洗与微调能力的AI工程师成为稀缺资源,学习AI大模型微调课程不仅是技术升级,更是职业护城河的构建。
主流微调技术路线对比与选择
选择正确的微调技术是成功的关键,目前主流的微调方式分为全量微调和参数高效微调(PEFT),其中LoRA是最常被提及的技术。
全量微调 vs LoRA微调
全量微调需要更新模型的所有参数,效果最好但成本极高;LoRA(低秩适配)则通过注入少量可训练参数来模拟全量微调的效果。
| 特性 | 全量微调 | LoRA微调 | Q-LoRA微调 |
|---|---|---|---|
| 显存需求 | 极高(需多卡集群) | 中等(单卡可跑) | 低(消费级显卡可跑) |
| 训练速度 | 慢 | 快 | 较快 |
| 效果损失 | 无 | 极小(<1%) | 极小 |
| 适用场景 | 顶级科研机构、超大规模企业 | 中小企业、垂直领域应用 | 个人开发者、资源受限团队 |
如何选择适合你的方案
如果你拥有A100/H100集群且预算充足,全量微调是上限最高的选择,但对于绝大多数企业和个人开发者,AI大模型微调实战教程中推荐的LoRA或Q-LoRA是性价比最高的起点,Q-LoRA通过4-bit量化技术,甚至能在24GB显存的RTX 3090/4090上运行70亿参数级别的模型,极大地降低了入门门槛。
实操指南:从零开始构建微调数据集
数据质量决定模型上限,许多初学者误以为微调就是“喂数据”,其实数据构造才是核心难点,一个高质量的微调数据集通常包含输入(Instruction)、上下文(Context)和输出(Output)三部分。
数据清洗与格式化
原始数据往往是杂乱无章的文本,需要经过严格的清洗流程:
- 去重与过滤:移除重复样本、乱码、非目标语言的文本。
- 格式转换:将数据转换为模型支持的格式,如Alpaca格式或ChatML格式。
- Alpaca格式示例:
{
  "instruction": "请总结以下文章的核心观点",
  "input": "文章内容...",
  "output": "核心观点是..."
}
- Alpaca格式示例:
- 数据增强:利用现有数据生成更多变体,如改写问题、增加噪声等,以提升模型泛化能力。
标注工具与流程
对于非结构化数据,人工标注必不可少,推荐使用Label Studio或Doccano等开源工具进行标注,标注过程中需遵循“少样本多轮次”原则,先标注少量数据验证流程,再大规模铺开,据统计,较大比例的微调失败案例源于数据标注不一致,因此建立统一的标注规范至关重要。
训练环境与代码实操路径
搭建稳定的训练环境是实操的第一步,推荐使用基于Linux的服务器或高性能云平台,安装PyTorch、Transformers、Accelerate等核心库。
环境配置清单
- 操作系统:Ubuntu 20.04或更高版本。
- Python版本:3.10及以上。
- 关键库:
transformers:Hugging Face的核心库。peft:参数高效微调库,支持LoRA。bitsandbytes:用于量化模型,降低显存占用。flash-attn:加速注意力机制计算。
核心训练命令解析
以使用QLoRA微调Llama-3模型为例,核心代码逻辑如下:
- 加载基座模型:使用
bitsandbytes进行4-bit量化加载。 - 配置LoRA参数:设置秩(rank)、缩放因子(alpha)等超参数。
- 加载数据集:使用
datasets库加载并预处理数据。 - 启动训练:调用
Trainer类进行训练,监控Loss变化。
from peft import LoraConfig, get_peft_model
config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(base_model, config)
成本评估与避坑指南
学习AI大模型微调价格及实施成本,是决策前的必要环节,很多初学者低估了隐性成本,导致项目中途搁浅。
显存与算力成本
- 显存:微调7B模型,LoRA至少需要24GB显存,Q-LoRA可降至12-16GB,若使用云端GPU,按小时计费,单次训练成本可能在几十至几百元不等。
- 时间:数据准备通常占整个项目周期的60%以上,训练本身可能只需几小时到一天。
常见误区
- 数据越多越好,高质量的小数据集(几百到几千条)往往比低质量的大数据集效果更好。
- 微调能解决所有问题,如果基座模型本身缺乏某领域知识,微调只能“记忆”数据,无法“推理”新知识,此时需结合RAG(检索增强生成)技术。
- 忽视评估环节,训练完成后,必须使用验证集评估模型在特定任务上的表现,而非仅看Loss下降。
AI大模型微调课程常见问题解答
零基础可以学习AI大模型微调课程吗
零基础学习存在一定门槛,主要难点在于Python编程基础、Linux命令行操作以及深度学习基本概念,建议先掌握Python基础语法和PyTorch基本用法,再进入微调课程,课程通常会提供预配置的环境镜像,降低环境搭建难度,但代码理解能力仍需具备。
微调后的模型如何部署到生产环境
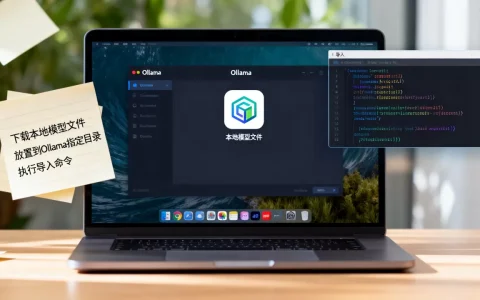
微调后的模型通常保存为LoRA权重文件,需与基座模型合并后才能独立部署,推荐使用vLLM或TGI(Text Generation Inference)等高性能推理框架进行部署,这些框架支持高并发请求和动态批处理,能显著提升推理速度,对于资源受限场景,也可使用Ollama等本地化工具快速部署。
微调与RAG技术哪个更适合企业应用
两者并非对立,而是互补,RAG适合需要实时性、数据频繁更新且对幻觉零容忍的场景,如客服问答;微调适合需要统一风格、处理复杂逻辑推理且数据相对静态的场景,如代码生成、创意写作,业内共识认为,最佳实践是结合使用:用RAG提供准确事实,用微调优化表达逻辑。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/373518.html