个人博客数据库设计的核心在于根据流量规模选择合适的数据结构,对于大多数独立博客,单表或简单的双表关联足以满足需求,无需过度追求复杂的分布式架构。
搭建个人博客时,许多开发者容易陷入“过度设计”的陷阱,试图用处理千万级并发的方案来支撑日均几十次的访问,这种思维误区不仅增加了维护成本,还可能导致系统脆弱,数据库设计的本质是平衡性能、成本与开发效率,对于个人博客这一特定场景,数据量小、读写并发低,但内容结构灵活多变,因此设计重点应放在数据模型的扩展性和查询效率上,而非高可用性集群。
明确博客数据模型的核心实体与关系
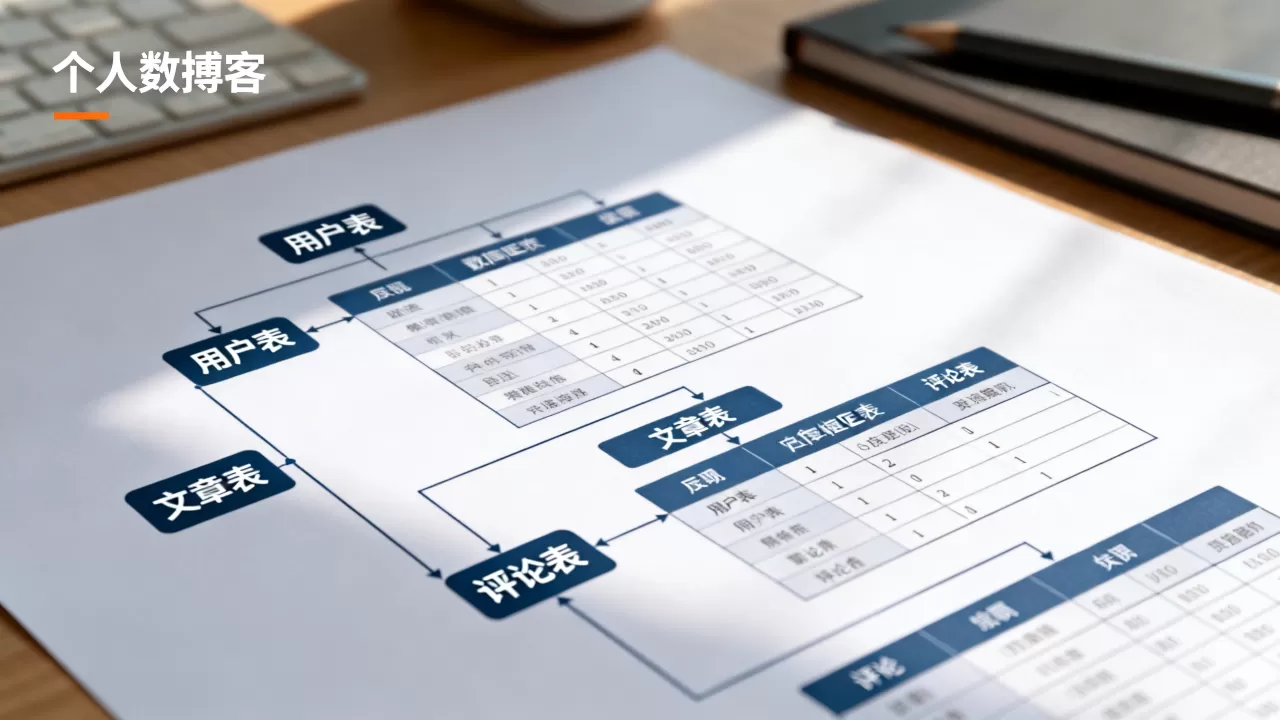
在设计初期,必须厘清博客系统中的核心实体,一个标准的个人博客通常包含文章、分类、标签、用户和评论五大核心模块,这些实体之间存在着明确的逻辑关系,理解这些关系是构建数据库的基础。
文章与分类标签的关联逻辑
文章是博客的核心内容载体,而分类和标签则是文章的元数据属性,分类通常具有层级结构,且数量相对固定;标签则更加灵活,数量庞大且无层级限制,业内专家指出,在处理这种多对多关系时,采用中间表是最佳实践。
具体而言,我们需要建立三张核心表:articles(文章表)、categories(分类表)和 tags(标签表),为了实现文章与标签的多对多关联,必须创建一张关联表 article_tags,这种设计允许一篇文章拥有多个标签,一个标签也能被多篇文章引用,如果采用将标签ID以逗号分隔的形式存储在文章表中,虽然查询简单,但会导致数据冗余,且难以进行高效的标签统计和去重操作。
评论系统的嵌套与性能权衡
评论系统往往被初学者忽视,但它直接影响用户体验和数据库负载,评论具有明显的树状结构,即评论可以嵌套回复,在数据库设计中,常见的有两种方案:邻接表模型和闭包表模型。
对于个人博客而言,邻接表模型(即在评论表中增加
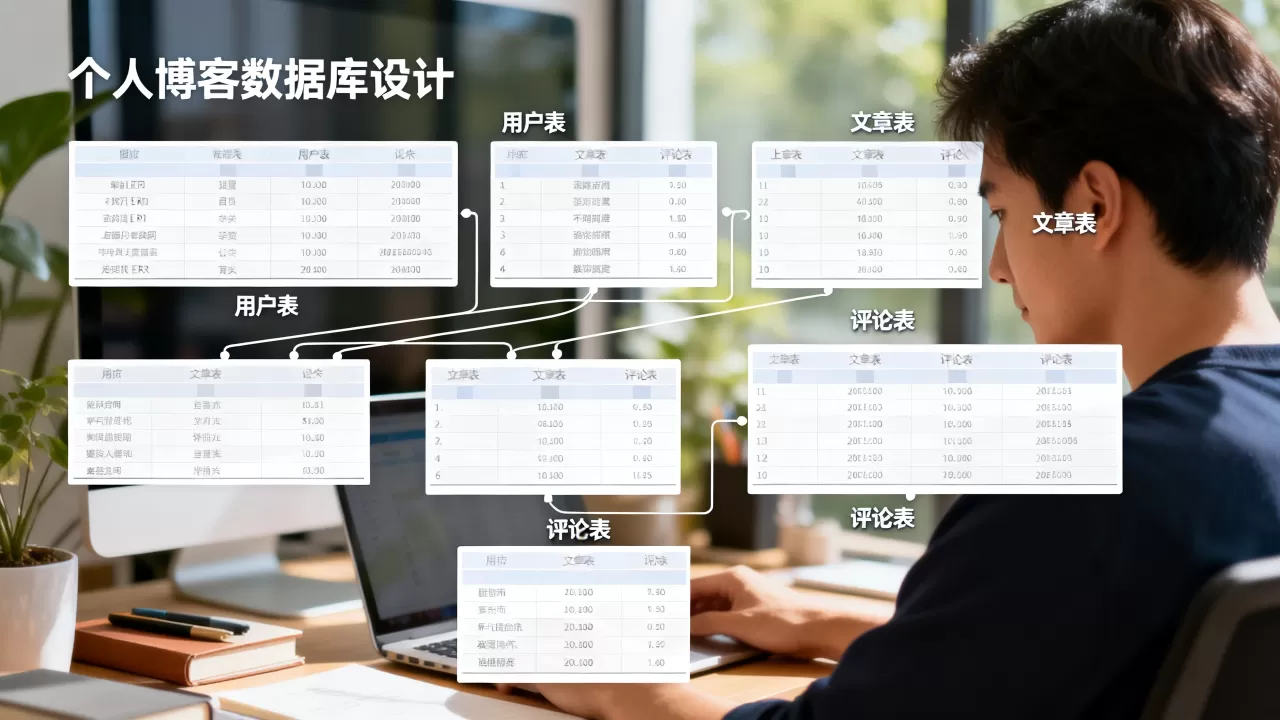
parent_id 字段指向父评论ID)更为实用,虽然查询深层嵌套评论时需要递归或多次查询,但由于个人博客的评论深度通常不超过3-4层,这种性能损耗几乎可以忽略不计,相比之下,闭包表模型虽然查询高效,但插入和更新操作复杂,维护成本高,更适合大型社交平台。
针对个人博客场景的表结构设计细节
有了宏观的实体关系,接下来需要落实到具体的字段设计和数据类型选择,这里需要深入探讨个人博客数据库设计中的常见误区与优化策略,特别是关于字段类型选择和索引策略。
主键策略:自增ID与UUID的抉择
主键的选择直接影响数据库的性能和安全性,许多开发者倾向于使用自增整数(Auto Increment Integer)作为主键,因为其在InnoDB引擎中表现优异,插入速度快,索引紧凑,自增ID存在一个显著缺陷:它暴露了网站的文章数量级,且容易被恶意遍历。
另一种选择是使用UUID(通用唯一识别码),UUID具有不可预测性,安全性更高,且便于分布式部署,但对于个人博客,数据量有限,自增ID的缺点并不明显,据统计,多数情况下,使用带前缀的自增ID(如 A10001)或简单的雪花算法生成的长整型ID,既能保证唯一性,又能兼顾性能,建议初学者直接使用数据库自带的自增主键,除非有特殊的SEO或隐私需求。
字段类型优化:节省空间与提升速度
数据库字段的类型选择看似微小,实则影响巨大,文章状态字段应使用 TINYINT 而非 VARCHAR;浏览量字段应使用 INT 而非 BIGINT,因为个人博客的浏览量极少超过21亿,对于文章内容字段,如果内容长度不确定且可能较长,使用 TEXT 类型是合适的,但需注意 TEXT 类型无法直接建立全文索引(MySQL 5.6之前),在较新版本中可使用 FULLTEXT 索引。
时间字段的标准化处理
时间字段在所有业务系统中都至关重要,建议统一使用
DATETIME 或 TIMESTAMP 类型,并始终存储为UTC时间,在应用层进行展示时,再根据用户时区进行转换,这样做的好处是避免夏令时切换带来的混乱,且便于跨时区的数据统计和分析。
索引策略与查询性能优化实战
数据库设计的最终目的是服务于查询,对于个人博客,读多写少的特性决定了索引策略的重要性,合理的索引可以显著提升列表页加载速度和搜索效率,而不当的索引则会拖慢写入速度并占用额外存储空间。
核心查询场景的索引设计
个人博客的主要查询场景包括:首页文章列表、文章详情页、标签归档页和搜索功能,针对这些场景,我们需要设计相应的复合索引。
- 首页文章列表:通常按发布时间倒序排列,并限制返回数量,在
articles表上建立(status, created_at DESC)的复合索引是最高效的,这能避免全表扫描,直接定位到最新发布的已发布文章。 - 标签归档页:用户点击某个标签查看相关文章时,查询条件为
tag_id和status。article_tags表上应建立(tag_id, article_id)的联合索引,以便快速定位属于该标签的文章ID列表。 - 全文搜索:对于关键词搜索,不要使用
LIKE '%keyword%',这会导致全表扫描,应使用MySQL的FULLTEXT索引,或者引入Elasticsearch等专业搜索引擎,对于小型博客,FULLTEXT索引足以应对日常需求。
避免索引失效的常见陷阱
在设计索引时,需注意函数操作和隐式类型转换会导致索引失效,对时间字段使用 YEAR(created_at) 进行查询,会使索引无法生效,正确的做法是使用范围查询,如 created_at >= '2026-01-01' AND created_at < '2026-02-01',对于 VARCHAR 类型的字段,前缀索引是一个有效的优化手段,特别是当字段值很长但前缀唯一性足够时。
扩展性与维护:面向未来的设计考量
个人博客的生命周期可能长达数年,随着内容积累,数据量会逐渐增长,虽然目前可能不需要考虑分布式架构,但预留扩展空间是明智之举。
读写分离的预备设计
当博客流量达到一定规模,主库的写压力可能会影响读性能,可以考虑引入读写分离,在数据库设计阶段,确保所有写操作都指向主库,读操作可以路由到从库,这要求应用层具备简单的路由逻辑,但数据库结构本身无需大幅改动。
数据归档策略
随着文章数量增加,历史文章的访问频率会显著降低,可以考虑将一年前的文章归档到冷存储或单独的归档表中,这种策略不仅优化了热数据的查询性能,还便于备份和恢复,在表结构上,可以预留 is_archived 字段,或者使用分区表(Partitioning)按年份进行物理分割。
个人博客数据库设计常见问题解答
个人博客数据库设计需要多高的服务器配置?
对于日均PV低于1000的博客,普通的1核2G云服务器配合MySQL 5.7或8.0版本完全足够,无需购买高性能数据库实例,重点应放在代码优化和缓存策略上,当并发量显著提升时,再考虑升级配置或引入Redis缓存。
个人博客数据库设计是否必须使用ORM框架?
ORM框架能简化开发流程,提高代码可读性,但在复杂查询场景下可能产生低效SQL,对于个人博客,建议使用轻量级ORM或原生SQL结合查询构建器,关键查询语句应手动编写并经过 EXPLAIN 分析,以确保索引生效,过度依赖ORM可能导致性能瓶颈,特别是在处理关联查询时。
个人博客数据库设计如何防止SQL注入攻击?
防止SQL注入的最佳实践是使用预处理语句(Prepared Statements)或参数化查询,无论使用何种编程语言或数据库驱动,都应避免直接将用户输入拼接到SQL字符串中,现代ORM框架通常默认启用参数化查询,但仍需警惕动态生成的SQL片段,启用WAF(Web应用防火墙)和最小权限原则(数据库用户仅授予必要权限)也是重要的安全补充措施。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/371307.html