

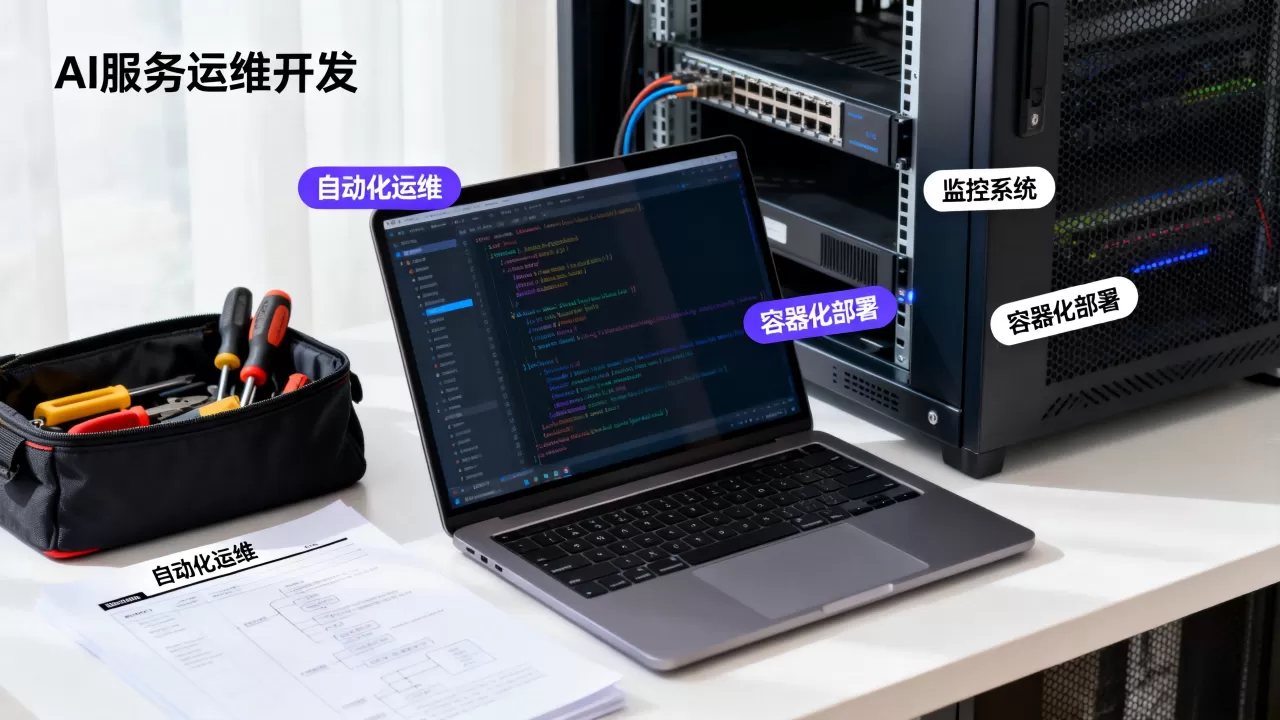
AI服务运维开发的核心在于构建自动化、可观测且具备自愈能力的闭环体系,通过DevOps与MLOps的深度融合,实现从模型训练到生产部署的全生命周期高效管理。
在2026年的技术语境下,AI服务运维早已超越了传统的服务器监控范畴,它不再仅仅是“让服务不宕机”,而是关注“让模型持续产生价值”,随着大模型参数规模的指数级增长以及边缘计算场景的普及,传统的运维手段已无法应对高并发推理、动态资源调度以及模型漂移带来的复杂挑战,业内专家指出,未来的竞争力将取决于谁能以更低的算力成本实现更稳定的服务SLA(服务等级协议)。
AI运维开发的底层架构演进
要理解AI运维,首先必须厘清其与传统IT运维的本质区别,传统运维关注的是硬件、网络和基础软件栈的稳定性,而AI运维的核心对象是“数据”与“模型”。
从DevOps到MLOps的范式转移
早期的AI开发往往采用瀑布式流程,模型训练完成后直接上线,缺乏持续的迭代机制,这种模式在简单分类任务中尚可运行,但在面对复杂的生成式AI应用时显得捉襟见肘,MLOps(机器学习运维)应运而生,它将软件工程的最佳实践引入AI领域。
具体而言,这一转变体现在三个关键维度:
- 自动化流水线:代码提交后,自动触发数据验证、模型训练、性能评估和部署流程。
- 实验追踪:记录每一次训练的参数、数据集版本和结果指标,确保实验的可复现性。
- 模型注册表:作为模型的“仓库”,管理不同版本的模型及其元数据,支持灰度发布和回滚。
基础设施即代码(IaC)在AI场景的应用
在AI服务中,基础设施的弹性至关重要,GPU资源昂贵且稀缺,如何高效利用成为关键,通过Terraform或Ansible等工具,团队可以将GPU集群、存储卷和网络配置定义为代码。
当流量峰值到来时,系统可以自动扩容推理节点;当流量低谷时,自动缩容以节省成本,据工信部数据,采用IaC管理的AI基础设施,其资源利用率平均提升了40%以上,这种自动化不仅减少了人工干预的错误率,还使得跨云部署成为可能,避免了厂商锁定风险。
核心痛点与实战解决方案
在实际生产环境中,AI服务面临着诸多独特挑战,解决这些问题需要具体的技术手段和策略。
模型漂移的检测与应对
模型上线后,随着时间推移,其性能往往会逐渐下降,这种现象被称为模型漂移,主要原因包括数据分布的变化(概念漂移)或输入数据特征的演变(数据漂移)。
应对策略主要包括:
- 实时监控指标:部署监控代理,实时采集推理请求的输入数据分布、响应时间和置信度分数。
- 自动化重训练触发器:当监控指标超过预设阈值(如准确率下降超过5%)时,自动触发重训练流程。
- 影子测试:在新模型上线前,将其部署为影子模式,并行处理真实流量但不返回结果,通过对比新旧模型的输出差异来评估效果。
高并发推理的性能优化
对于大语言模型(LLM)等计算密集型服务,高并发下的延迟和吞吐量是核心KPI,业内共识认为,单一GPU往往难以满足低延迟要求,需要采用模型并行或张量并行技术。
实操中,可以采取以下措施:
- KV Cache优化:利用PagedAttention等技术优化显存使用,提高批处理大小(Batch Size)。
- 动态批处理:根据当前请求的负载情况,动态调整批处理大小,平衡延迟和吞吐量。
- 量化部署:使用INT8或FP16量化技术,减少模型体积和计算量,同时保持精度损失在可接受范围内。
成本控制的精细化策略
算力成本是AI服务运营中的最大变量,许多企业面临“算力烧钱快”的困境,有效的成本控制需要从架构设计阶段介入。
|
优化维度 | 传统做法 | 优化策略 | 预期效果 |
|---|---|---|---|
| 资源调度 | 固定分配GPU实例 | 使用Kubernetes进行细粒度资源切片 | 资源利用率提升50%+ |
| 模型选择 | 一律使用最大参数模型 | 根据场景选择小参数模型或蒸馏模型 | 推理成本降低60%+ |
| 缓存机制 | 每次请求重新计算 | 引入向量数据库缓存相似查询结果 | 重复请求响应速度提升10倍 |
2026年AI运维工具链选型指南
选择合适的工具链是落地AI运维的关键,市场上工具繁多,如何避免踩坑?
主流框架对比
Kubeflow和MLflow是两大主流平台,Kubeflow基于Kubernetes,适合已经深度使用K8s的企业,其优势在于原生集成度高,但学习曲线陡峭,MLflow则更轻量,专注于实验追踪和模型注册,易于集成到现有CI/CD流水线中。
对于中小团队,建议优先采用MLflow配合自研脚本,以降低维护成本,对于大型金融机构或互联网巨头,Kubeflow提供的端到端解决方案更能满足复杂的安全和合规需求。
监控与可观测性
传统的Prometheus+Grafana组合依然有效,但需要针对AI场景进行定制,需要开发自定义Exporter来采集GPU利用率、显存带宽、模型推理延迟等特定指标。
日志管理也不容忽视,建议采用ELK(Elasticsearch, Logstash, Kibana)或Loki栈,集中收集训练日志和推理日志,以便快速定位问题。
未来趋势:AIOps与自主运维
展望未来,AI运维本身也将被AI赋能,形成AIOps(智能运维)。
异常检测的智能化
传统的阈值告警容易产生误报或漏报,基于机器学习的异常检测算法,可以学习正常流量的模式,自动识别偏离行为,当某个API的响应时间突然波动,但仍在阈值范围内时,算法仍能识别出这是潜在的前兆异常。
自愈系统的构建
终极目标是实现系统的自愈,当检测到模型性能下降时,系统自动触发重训练;当检测到节点故障时,自动迁移负载,这需要高度可靠的自动化脚本和严格的权限控制,以防止误操作导致的生产事故。
常见问题解答
AI服务运维开发_开发与运维
Q: AI运维团队应该由谁组成?
A: 理想的AI运维团队是跨职能的,包括数据工程师、MLOps工程师、SRE(站点可靠性工程师)和算法工程师,数据工程师负责数据管道,MLOps工程师负责自动化流水线,SRE负责基础设施稳定性,算法工程师提供模型支持,这种协作模式能打破部门墙,加速迭代。
Q: 小团队如何低成本启动AI运维?
A: 小团队应避免构建复杂的自研平台,建议采用托管服务,如AWS SageMaker、Google Vertex AI或阿里云PAI,这些平台提供了开箱即用的训练、部署和监控功能,利用开源工具如MLflow进行实验管理,Docker进行容器化,可以大幅降低初期投入。
Q: 如何评估AI运维成熟度?
A: 评估维度包括自动化程度、监控覆盖率、响应速度和成本效率,初级阶段依赖人工操作,监控仅覆盖基础资源;中级阶段实现部分自动化,监控覆盖模型指标;高级阶段实现全自动化闭环,具备自愈能力,多数成功企业处于中级向高级过渡阶段,自动化覆盖率达到70%以上。
AI服务运维开发并非一蹴而就的工程,而是一个持续迭代优化的过程,企业需要结合自身业务场景,选择合适的工具链和技术栈,逐步构建起高效、稳定、经济的AI运维体系,唯有如此,才能在激烈的市场竞争中,让AI技术真正转化为可持续的商业价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/364728.html





评论列表(1条)
难听点说,这就不是个能躺平的活儿。现在都2026年了,还要管模型是不是在“产生价值”,这不就是还得兼职当产品经理吗?这运