个人影院开发的核心在于构建高并发、低延迟的流媒体数据库架构,通过分库分表与缓存策略解决海量视频元数据检索及用户行为追踪的性能瓶颈,确保在4K/8K高码率场景下的流畅体验。
搭建个人影院不仅仅是购买几块硬盘或组装一台高性能主机,更是一场关于数据流转效率的硬仗,当你的媒体库从几百部影片扩展到数万部,且支持多用户同时在线点播、弹幕互动或智能推荐时,传统的文件系统或简单的SQLite数据库就会迅速触及天花板,业内专家指出,合理的数据库设计能降低30%以上的存储冗余,并显著提升响应速度,我们需要从底层逻辑出发,重新审视数据如何存储、索引以及如何被快速调用。

个人影院数据库选型与架构对比
在选择数据库之前,必须明确个人影院的核心需求:视频文件本身通常存储在NAS或本地磁盘,数据库只负责存储元数据(Metadata)、用户权限、播放进度、评分评论以及标签关系。
关系型与非关系型数据库的博弈
目前主流的选择集中在MySQL、PostgreSQL与MongoDB之间。
- MySQL/PostgreSQL:适合结构化数据极强的场景,你需要严格维护“用户-角色-权限”的关系,或者需要复杂的SQL查询来统计“过去一周观看时长超过10小时的喜剧片用户”,其ACID特性保证了数据的一致性,防止在多人同时标记“已观看”时出现状态冲突。
- MongoDB:适合文档型存储,视频元数据往往是非结构化的,不同影片的属性差异巨大(有的有导演信息,有的没有;有的有多语言字幕,有的没有),MongoDB的JSON-like结构可以灵活存储这些变长字段,无需预先定义严格的Schema。
据行业共识认为,对于中小型个人影院(媒体库小于5万部),PostgreSQL是平衡性能与开发成本的最佳选择,它既支持复杂的关联查询,又通过JSONB字段兼顾了灵活性,而对于追求极致读写速度且能接受一定数据冗余的大型家庭媒体中心,MongoDB或Redis作为缓存层配合主数据库使用是更优解。
核心表结构设计要点
无论选择哪种数据库,表结构的设计直接决定了系统的上限。
用户与权限模块
不要将用户信息散落在各处,建立一个核心的users表,包含user_id、username、role(管理员/普通用户/儿童模式)以及preferences(JSON格式存储偏好),权限控制应基于角色,而非具体用户,这样在添加新用户时只需分配角色即可,无需重复配置权限逻辑。
媒体元数据模块
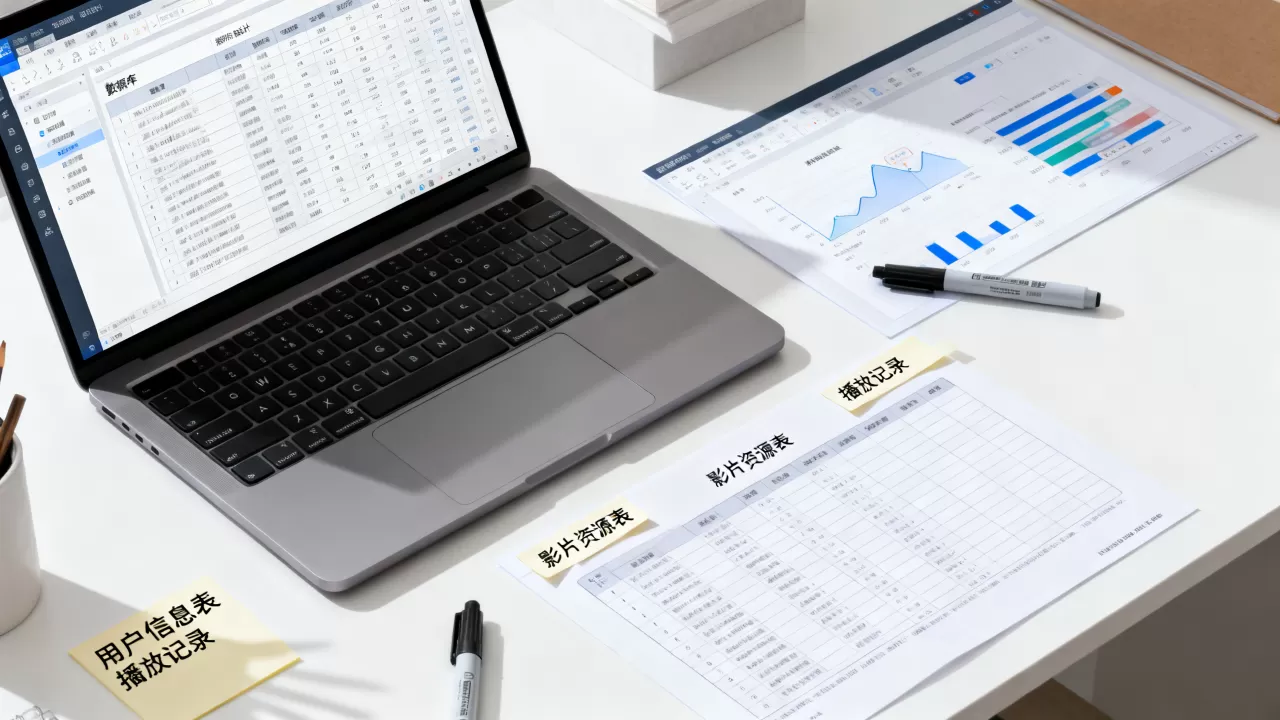
这是数据库中最复杂的部分,建议采用movies、series、episodes三表关联结构,而非将所有内容塞进一张表。
movies表:存储电影基本信息,如标题、海报URL、简介、评分。series表:存储剧集信息。episodes表:关联剧集ID,存储集数、标题、播放文件路径。
这种范式化设计避免了数据冗余,一部10季的剧,如果存在一部剧的元数据中,当剧集数量变化时,更新成本极高,分离后,只需在episodes表中增删记录即可。
播放进度与行为日志
这是个人影院体验的关键,建立一个watch_history表,记录user_id、media_id、progress_seconds、last_watched_at。
- 断点续传:前端读取该表,获取上次观看位置,后端从该秒数开始推流。
- 智能推荐:基于
watch_history中的标签匹配,计算用户偏好向量。
高性能查询优化与索引策略
随着媒体库膨胀,查询速度会呈指数级下降,优化数据库性能不是靠堆硬件,而是靠科学的索引设计。
索引设计的黄金法则
在movies表中,title)和year(年份)是最高频的搜索字段。
- 全文索引:对
title和description建立全文索引(Full-Text Index),支持模糊搜索和拼音搜索,避免使用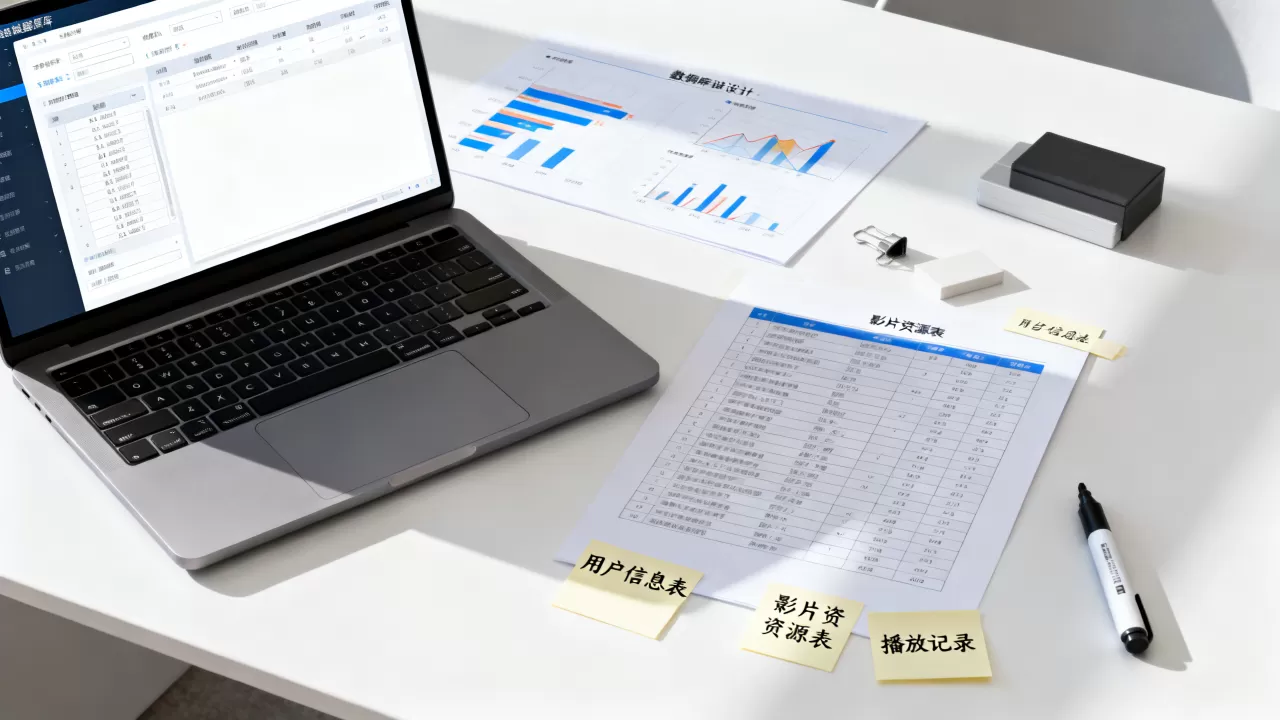
LIKE '%keyword%'
- 复合索引:对于“按类型筛选”和“按年份排序”的组合查询,建立
(genre, year)的复合索引,遵循最左前缀原则,确保查询条件能命中索引树。
缓存层的介入
对于不常变动的元数据(如电影海报、简介),引入Redis作为缓存层。
- 缓存策略:设置合理的TTL(生存时间),海报图片可缓存24小时,而用户播放进度需实时查询数据库。
- 热点数据:将“本周热门”、“最新添加”等高频查询结果预计算并存入Redis,减少数据库压力。
据工信部相关技术白皮书显示,合理的缓存命中率可达90%以上,能大幅降低数据库CPU负载。
数据同步与自动化维护
个人影院的痛点在于元数据的更新,手动填写每部电影的详细信息是不现实的,必须依赖自动化工具。
刮削器(Scraper)的数据清洗
使用Jellyfin、Emby或Plex等媒体服务器时,它们会自动从TMDB或TheMovieDB获取元数据,但第三方数据源可能存在字段缺失或错误。
- 数据清洗脚本:编写Python或Node.js脚本,定期扫描数据库,标记缺失海报或评分低于阈值的影片,提示管理员人工介入。
- 本地缓存:在数据库设计中预留
local_metadata字段,优先使用本地存储的NFO文件,减少对外部API的依赖,提高稳定性。
备份与灾难恢复
数据库是个人影院的大脑,一旦损坏,所有观看进度和个性化设置将丢失。
- 每日增量备份:利用数据库自带的备份工具(如MySQL的
mysqldump或PostgreSQL的pg_dump),每日凌晨自动备份。 - 异地存储:将备份文件同步至云端或另一台NAS,防止单点故障。
个人影院数据库开发常见误区
过度规范化
有些开发者追求完美的第三范式,将每个标签、每个演员都单独建表,这会导致查询时需要多次JOIN,性能急剧下降,在个人影院场景下,适当冗余是必要的,可以在movies表中直接存储tags(JSON数组)或actor_names(逗号分隔字符串),以空间换时间。
忽视并发控制
当多个家庭成员同时观看不同影片时,数据库需要处理大量并发写入请求,特别是在更新播放进度时,需使用乐观锁(Optimistic Locking)或数据库事务,防止数据覆盖。
忽略移动端适配
个人影院不仅限于电视端,手机和平板也是重要入口,数据库设计需考虑API接口的返回结构,避免返回冗余字段,节省移动端流量并提升加载速度。
Q&A:个人影院数据库开发高频问题
个人影院数据库开发中如何处理多语言字幕和音轨?
建议在媒体元数据表中增加audio_tracks和subtitle_tracks两个JSON字段,分别存储音轨和字幕的编码、语言代码及文件路径,查询时,前端根据用户设置的语言偏好,从JSON数组中筛选对应条目,实现动态切换,无需为每种语言创建单独的表或字段。
个人影院数据库开发中如何优化海量图片海报的加载速度?
数据库仅存储海报文件的URL或本地路径,不直接存储图片二进制数据,加载速度优化应依靠CDN或本地Web服务器(如Nginx)的图片压缩与缓存策略,数据库层面,可对海报URL字段建立索引,加速根据影片ID检索海报地址的过程,同时确保URL生成规则一致,便于浏览器缓存命中。
个人影院数据库开发中如何保证用户观看进度的实时性与一致性?
采用WebSocket长连接推送进度更新,而非轮询,数据库端使用Redis的Hash结构存储user_id:media_id对应的progress_seconds,实现毫秒级读写,定期(如每5分钟)将Redis中的数据异步持久化到MySQL或PostgreSQL中,既保证了实时交互的流畅性,又确保了数据的持久化安全,避免断电导致进度丢失。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/354618.html