

突破与挑战并存
远场语音识别技术正深刻改变人机交互方式,成为智能家居、车载系统、会议设备等场景的核心入口。当前全球远场语音识别技术发展迅猛,中国凭借庞大应用场景和创新算法快速追赶,但声学环境复杂性与语义理解深度仍是全球共同面临的攻坚重点。
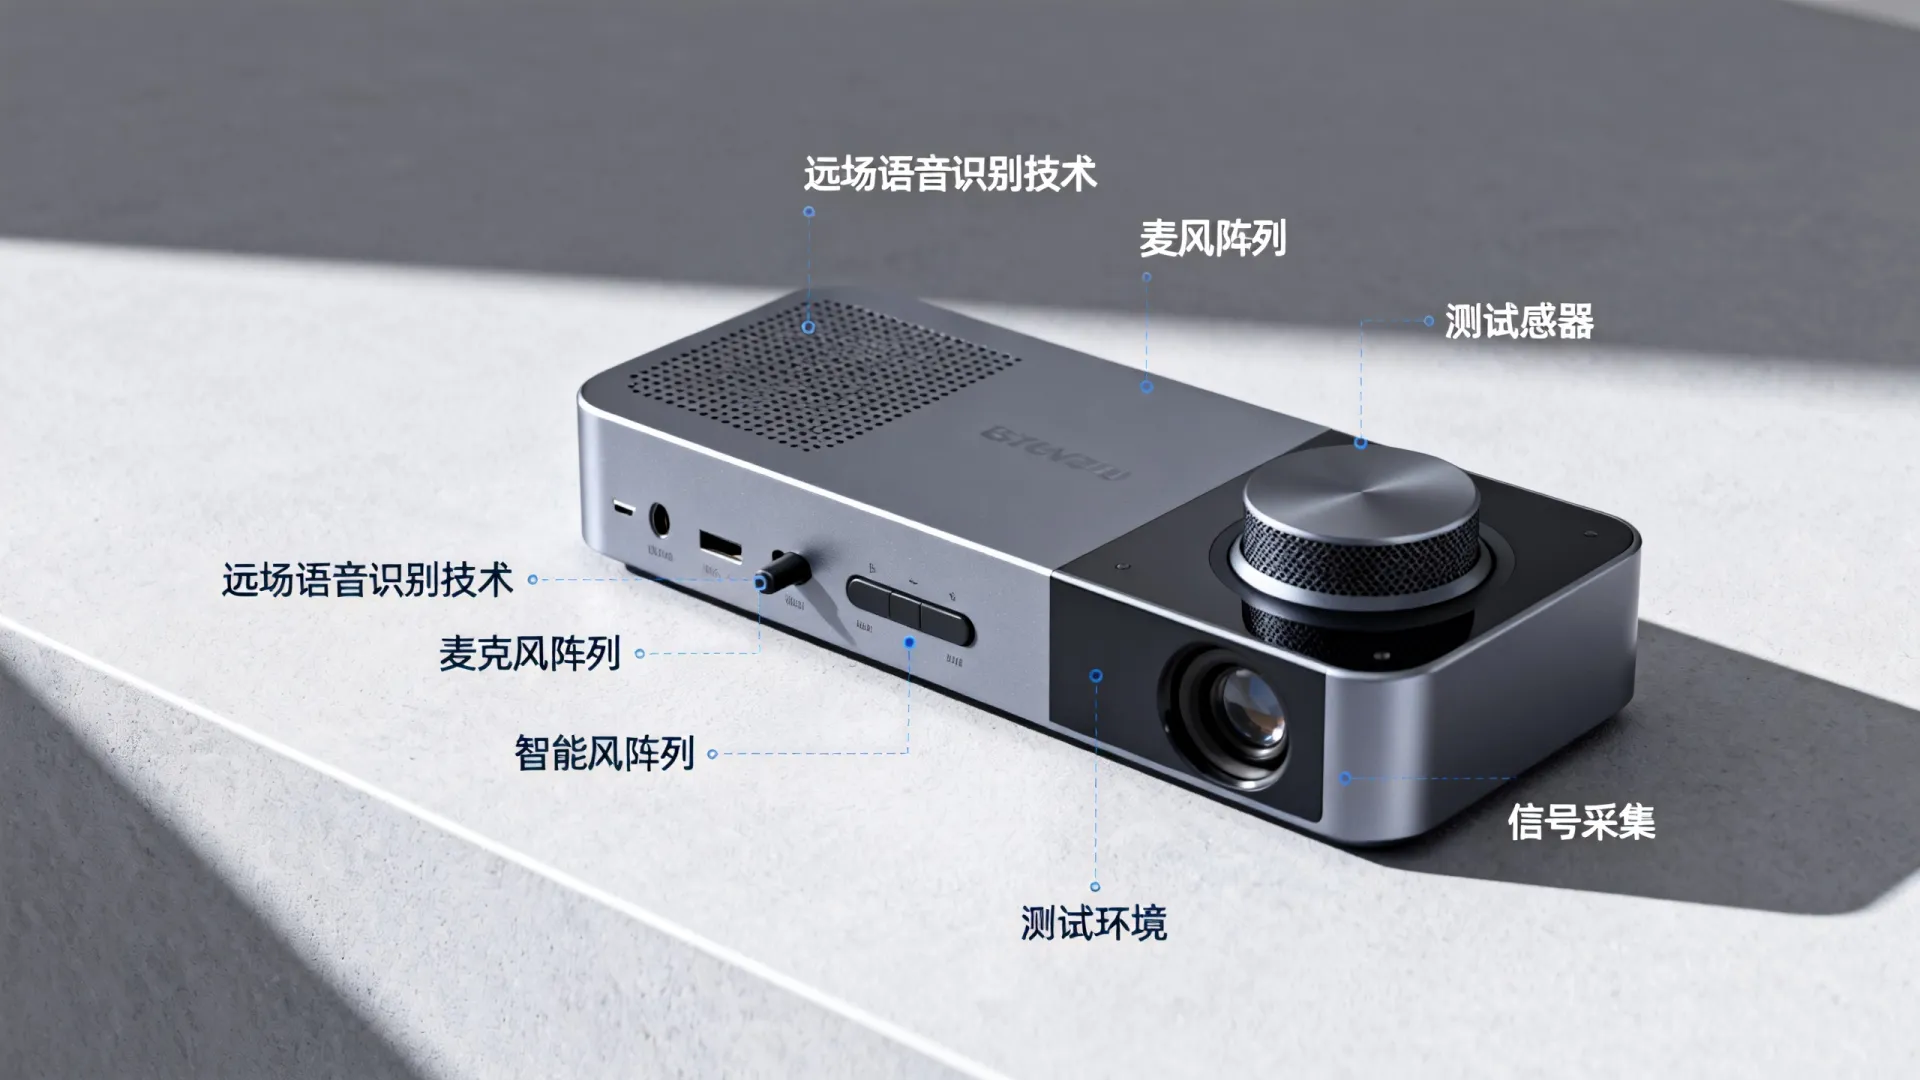
全球技术格局:创新驱动,应用深化
- 北美技术引领: 以谷歌、亚马逊、苹果为代表,依托深厚AI基础研究(如Transformer架构演进)、海量多语言数据积累及强大云计算能力,在远场鲁棒性(抗噪、回声消除)和自然语言理解(NLU)方面保持领先,其语音助手已深度集成至操作系统与亿级终端。
- 中国加速追赶: 以百度、科大讯飞、阿里云等为引领,结合本土海量用户数据与复杂场景(方言、家庭噪声环境),在中文远场识别准确率上达到国际先进水平,百度DuerOS、科大讯飞开放平台赋能众多硬件厂商,推动技术下沉与规模化应用,麦肯锡报告指出,中国智能语音市场增速显著高于全球平均水平。
- 欧洲研究见长: 高校与研究所(如剑桥、INRIA)在基础声学模型、低资源语言识别、隐私保护技术方面有深厚积累,为产业界提供重要理论支撑。
核心挑战:远场场景的复杂性
远场识别需克服远超近场的独特难题:
- 复杂声学干扰:
- 噪声污染: 空调声、电视声、厨房噪音等稳态与非稳态噪声大幅降低信噪比。
- 混响效应: 声波在室内多次反射形成混响,导致语音模糊失真。
- 回声干扰: 设备自身播放的音频(如音乐)被麦克风二次采集。
- 鸡尾酒会问题: 多人同时说话时,准确分离并识别目标说话人语音。
- 语义理解深度不足: 当前技术对复杂上下文推理、隐含意图理解、多轮深度对话仍显吃力,尤其在远场语音质量受损时表现更不稳定。
关键技术突破与解决方案
应对挑战,国内外前沿方案聚焦以下方向:
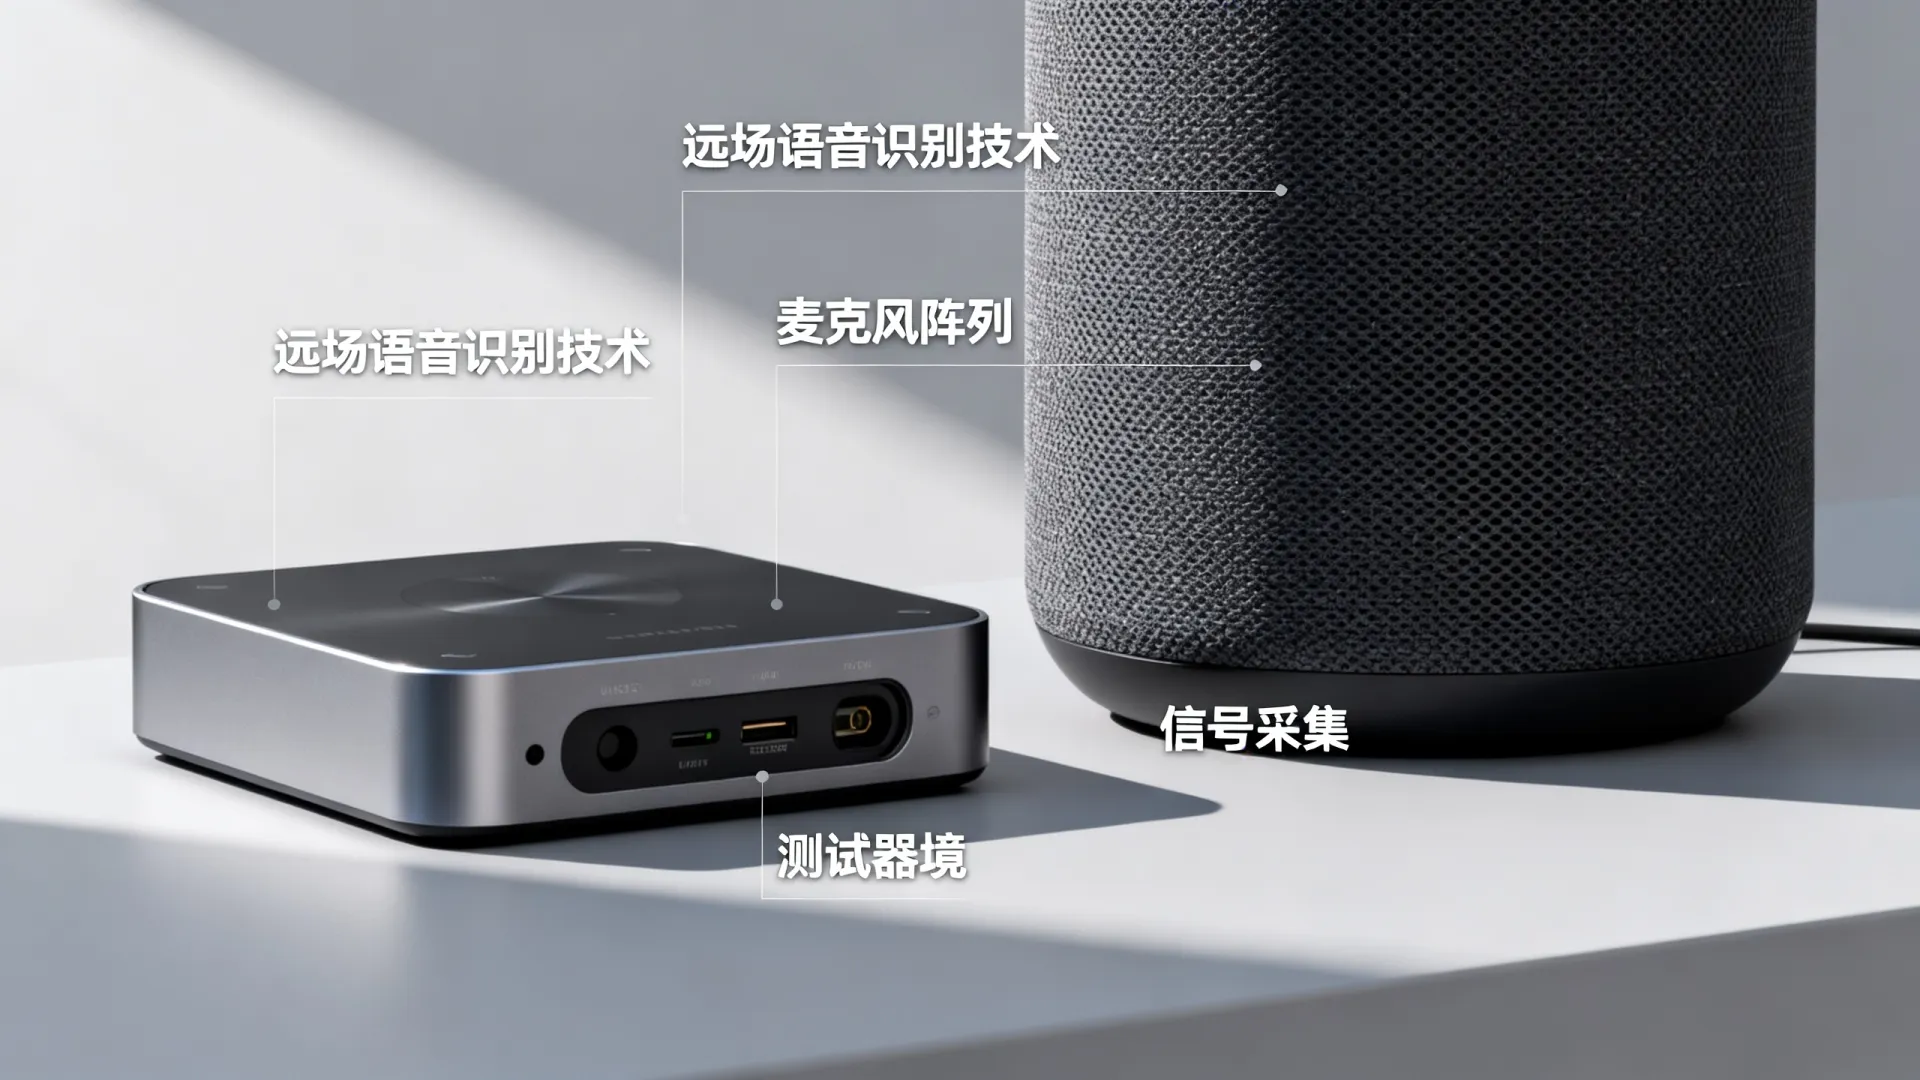
- 前端声学增强:
- 先进麦克风阵列: 采用环形、线性阵列,结合波束成形(Beamforming)技术精准聚焦目标声源,抑制环境噪声与干扰说话人,自适应波束成形可动态跟踪说话人位置。
- 深度神经网络前端: 应用DNN、CNN等模型直接处理多通道麦克风信号,进行语音分离(如DPCL++、Conv-TasNet)、去混响(如WPE)、回声消除,效果显著优于传统信号处理方法。
- 后端识别与理解增强:
- 端到端建模: 使用Transformer、Conformer等架构构建端到端(E2E)模型,直接映射语音特征到文本或语义,简化流程并提升精度。
- 上下文感知与个性化: 融合对话历史、用户画像、设备状态等上下文信息,提升意图识别准确率,设备端轻量化模型可学习用户发音习惯与常用词汇。
- 多模态融合: 结合视觉信息(如唇动、人脸朝向)辅助判断说话人及意图,提升复杂场景鲁棒性。
- 计算架构优化:
- 云+端协同: 复杂模型运行在云端保证效果,轻量化模型部署在设备端保障低延时与隐私场景需求,边缘计算重要性日益凸显。
- 模型压缩与加速: 应用知识蒸馏、量化、剪枝等技术,在保证精度的前提下大幅降低模型计算量和存储需求,适应终端设备。
未来趋势:更智能、更普适、更可信
- 自适应能力升级: 模型动态适应不同口音、噪声环境、房间声学特性,实现“无感”交互。
- 认知智能深化: 融合大语言模型(LLM)能力,实现更深层次语义理解、知识推理与创造性对话。
- 隐私安全强化: 本地化处理敏感语音、联邦学习、差分隐私等技术保障用户数据安全与隐私合规。
- 多模态无缝融合: 语音与视觉、触觉等多模态信号深度协同,构建更自然、高效的人机交互体验。
远场语音识别技术相关问答
Q1:当前远场语音识别最大的技术瓶颈是什么?
最大的瓶颈在于极端复杂声学环境下的鲁棒性与深度语义理解的结合,虽然前端声学处理技术(如先进波束成形和深度语音分离)已大幅提升抗噪能力,但在高混响、强干扰(如多人高声谈话叠加背景音乐)的“鸡尾酒会”场景中,准确分离并识别目标语音仍具挑战,即使语音被清晰拾取,对用户复杂、模糊或隐含意图的精准理解(尤其需上下文推理时),现有技术仍有明显局限,这需要声学模型与语义大模型的更深度协同优化。
Q2:普通用户选择远场语音交互设备时,最应关注哪些技术指标?
应重点关注:
- 唤醒率与误唤醒率: 设备能否被轻松唤醒(高唤醒率),同时避免被无关声音频繁误触发(低误唤醒率)。
- 远场识别准确率: 在3-5米距离、有适度背景噪音(如风扇声)时,识别常用指令的准确度,可测试设备在播放音乐时能否有效执行暂停/切歌指令。
- 响应速度: 从说完指令到设备开始执行动作的延迟感是否明显。
- 多轮对话能力: 能否理解上下文相关指令(如先问“天气如何?”,再问“明天呢?”)。
- 隐私开关与本地处理能力: 是否有物理麦克风静音键,以及是否支持本地处理常见指令(不依赖云端),这对隐私敏感用户尤为重要。
您在使用智能音箱或车载语音时,是否遇到过令人困扰的识别失败场景?您认为未来技术最应优先解决哪方面的体验痛点?欢迎分享您的见解!
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/34764.html




评论列表(5条)
远场语音识别确实让生活更智能了,但隐私问题让人不安——它总在监听,会不会泄露家庭私密对话?这得好好想想边界在哪。
@kind693fan:kind693fan说得太对了,隐私这块儿确实让人揪心。我之前看科技论坛讨论过,现在很多设备其实只在唤醒词后才启动识别,数据尽量本地处理不上云。不过我觉得用户还是得自己多注意设置,比如定期关掉麦克风,毕竟安全第一。
读了这篇关于远场语音识别的文章,挺有共鸣的。作为一个对技术规模效应特别敏感的人,文章里提到的“突破与挑战并存”确实点到了关键。 远场语音识别在小规模、理想环境下表现好,和真正大规模落地时的表现,完全是两码事!文章提到中国有庞大应用场景,这绝对是优势——海量的真实用户和环境数据是打磨技术最好的磨刀石。规模越大,遇到的环境噪音、方言口音、重叠语音这些“奇葩”情况就越多,算法能学到的就越多,这符合数据驱动的增长逻辑。国内厂商能快速追赶,这块土壤功不可没。 不过,规模也带来巨大挑战。文章里说的“声学环境复杂性与语音多样性”在用户量激增时会指数级放大。想象一下,一个算法部署到几百万不同装修、不同背景音的客厅里,或者跑在高速行驶、车窗开闭的车上,这复杂度比实验室高太多了。这时候,比拼的不仅是核心识别准确率,更是系统的鲁棒性、自适应能力和处理长尾问题的能力。哪家能更高效地利用大规模真实场景数据持续迭代优化,解决这些“边角”但高频影响体验的问题,哪家才能真正称得上“强”。 说白了,远场语音识别已经不是单纯的技术秀场了。它现在拼的是规模化落地的工程能力、数据闭环的效率以及对海量用户体验的精细化运营。谁能把大规模部署的负效应(噪声、干扰、长尾问题)转化为模型持续进化的燃料,谁才能真正在智能家居、车载这些核心入口站稳脚跟。挺期待看国内厂商怎么在这场规模战中玩出更多花样来。
看完这篇文章,真心觉得远场语音识别技术这几年发展太快了!作为特别关注技术底层的爱好者,尤其是内存占用这块,我忍不住想聊聊。 文章提到国内外都在飞速发展,特别是国内借着应用场景多和算法创新在追赶,这点我很认同。像科大讯飞、百度、阿里这些大厂的技术,在实际产品里体验确实越来越好了。不过,文章也点出了关键难点:复杂的声学环境(各种噪音、回声)和咱们国家丰富的方言口音,这确实是块硬骨头。 站在内存优化的角度看,我觉得技术的“强”不仅在于识别率高低,更在于它能在多“轻量”的设备上高效运行。远场识别往往需要在本地设备上完成一部分预处理(比如回声消除、波束成形),或者在端侧运行轻量模型,这对内存管理提出了极高要求。谁能在保证识别精度的同时,把模型压缩得更小,内存占用压得更低,功耗控制得更好,让技术能在便宜的IoT设备、老型号的手机甚至车机上流畅跑起来,谁才是真厉害。国外谷歌、亚马逊的积淀深,但国内企业在优化适配本土复杂环境和硬件成本控制上,感觉下了更多功夫,挺有特色的。 总之,这技术前景是真好,但挑战也实实在在。期待看到更多关于底层算法效率和资源优化的突破,毕竟落地到千万普通设备上,省内存、跑得动才是王道!
这篇文章挺有意思的,一下抓住了远场语音识别这个热门技术。作为平时老琢磨接口设计的人,看到“核心入口”这个描述就特别有共鸣——远场语音识别本质上就是个关键的API接口嘛,用户对着空气说话就是输入,识别出来的指令就是输出。 文章点出了国内依靠应用场景和算法在快速追赶,这点我认同。国内像科大讯飞、百度这些企业确实做得风生水起,尤其在中文特定场景下体验不错。不过说“哪家强”,感觉文章没给明确答案,这也合理,因为真的要看具体场景,就像评判API要看实际调用效果一样。国外比如亚马逊的Alexa、谷歌助手在基础技术和多语种支持上积累深,国内则在本地化和复杂场景(比如带点口音、背景有电视声)优化上很拼。 文章末尾提到“声学环境复杂性与语…”这个点,我觉得特别关键!这简直是远场语音识别的“痛点参数”。麦克风阵列怎么排布(硬件接口)、噪音怎么滤(预处理)、口音方言怎么适配(参数调整),这些都是巨大挑战,直接影响这个“语音API”的鲁棒性和用户体验。能把这些问题处理好,才是真强。感觉这块国内外都还在不断突破中,谁能把复杂环境的识别率做得更稳更准,谁就能在体验上拉开差距,成为更强大的“入口”。这个领域确实像文章说的,突破和挑战并存,挺让人期待的。