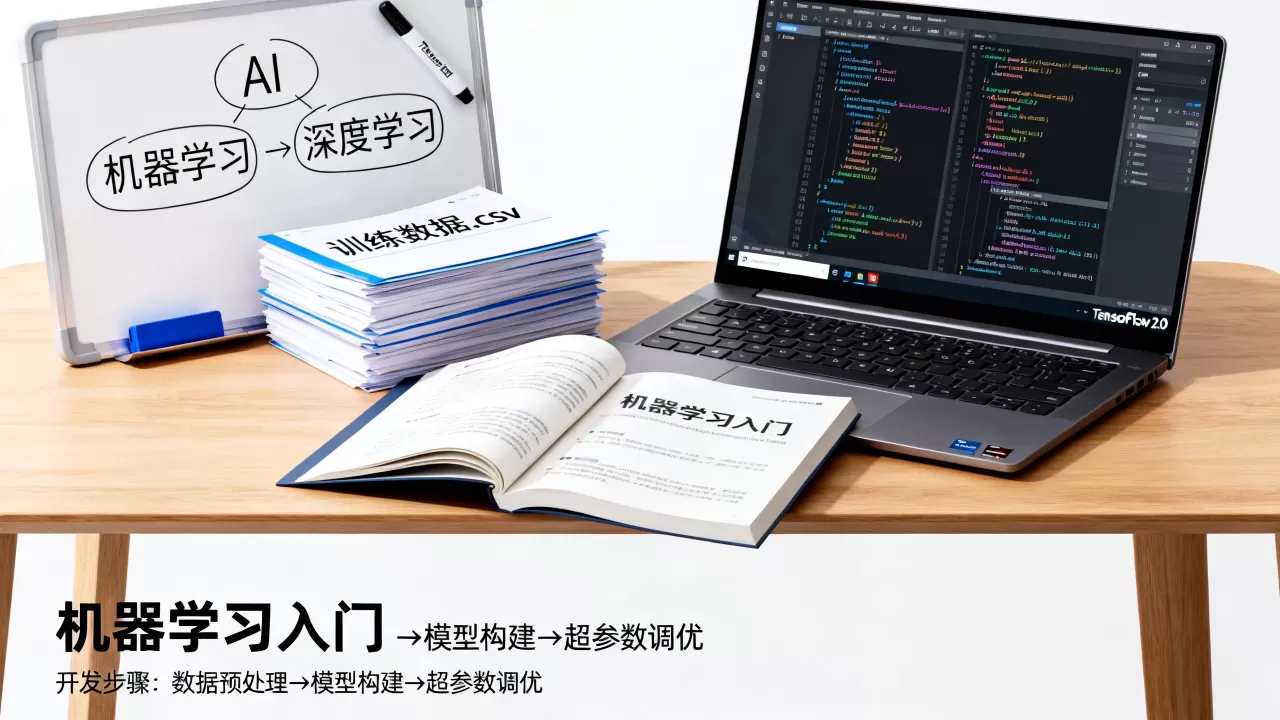
人工智能是宏观领域,机器学习是其核心分支,而深度学习则是机器学习利用多层神经网络处理复杂数据的进阶技术,开发模型需经历数据清洗、架构选择、训练调优及部署上线四个关键阶段。
很多人容易把这三个概念混为一谈,就像把“汽车”、“发动机”和“涡轮增压技术”当成同一个东西,它们有着清晰的层级关系,人工智能(AI)是一个巨大的伞状概念,涵盖了所有让机器模拟人类智能的技术,在这个大伞下,机器学习(ML)是主要手段,它让计算机通过数据而非显式编程来学习规律,而深度学习(DL)则是机器学习的一个子集,它模仿人脑神经元结构,通过深层神经网络处理图像、语音等非结构化数据,是目前推动AI爆发的核心引擎。
厘清概念:AI、机器学习与深度学习的真实关系
要开发模型,首先得明白我们在处理什么,业内专家指出,理解这三者的包含关系是避免技术选型错误的第一步。
人工智能的广义范畴
AI不仅仅是聊天机器人或自动驾驶,它包括专家系统、规则引擎、知识图谱等,在2026年的今天,大多数企业应用的AI已经不再是简单的规则匹配,而是基于数据的预测和生成。
机器学习的算法基石
机器学习是AI实现智能化的主要路径,它依赖于算法从历史数据中识别模式,常见的算法包括决策树、随机森林、支持向量机等,这些算法在结构化数据(如表格、数据库)处理上表现优异,且计算成本相对较低。
深度学习的神经网络突破
深度学习属于机器学习,但它特指使用多层人工神经网络的算法,当数据量巨大且维度复杂时,传统机器学习往往需要大量人工特征工程,而深度学习能自动提取特征,这就是为什么在图像识别、自然语言处理领域,深度学习成为绝对主流。
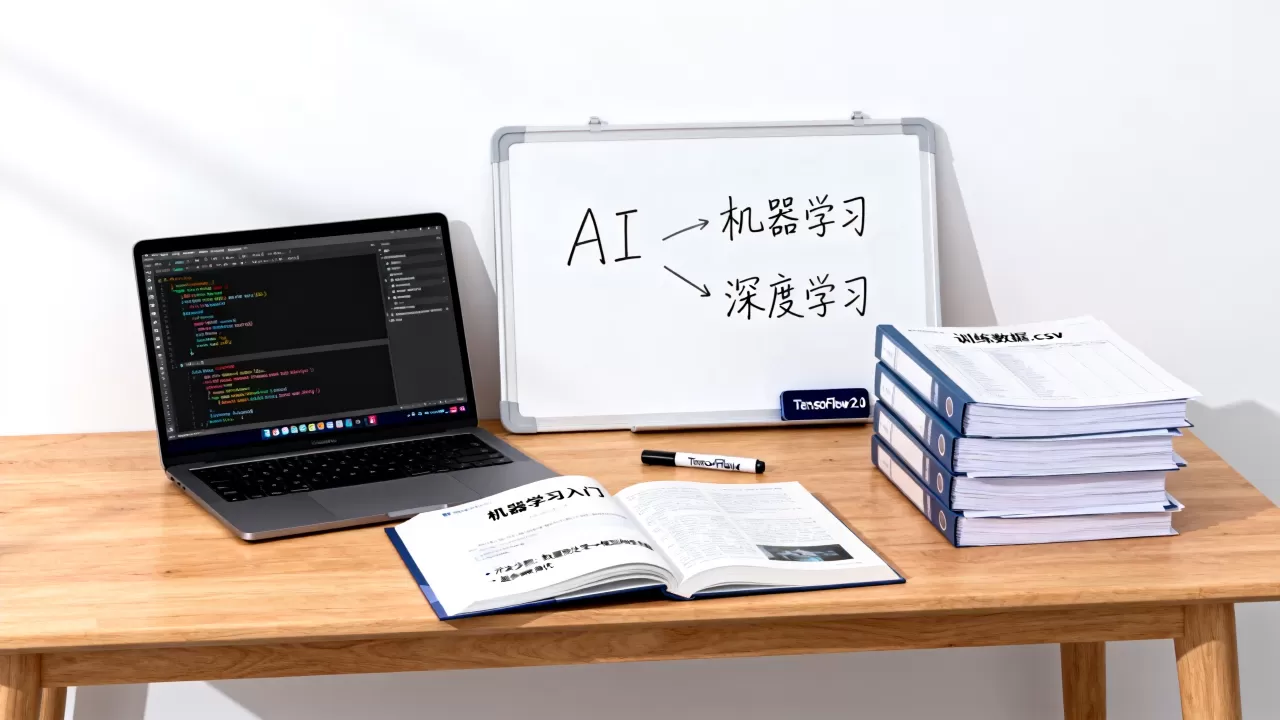
开发深度学习模型的核心流程拆解
开发一个可用的深度学习模型并非一蹴而就,它更像是一个严谨的工程流水线,以下是标准化的实操步骤。
第一步:数据准备与预处理
数据是模型的燃料,没有高质量的数据,再先进的算法也是徒劳。
数据收集与标注
你需要确定数据来源,如果是计算机视觉任务,可能需要从公开数据集下载,或自行拍摄采集,标注环节至关重要,对于分类任务,需要人工或半自动工具对图片打上标签;对于目标检测,则需要绘制边界框。
数据清洗与增强
原始数据往往充满噪声,缺失值填充、异常值剔除是基础操作,为了提升模型的泛化能力,数据增强(Data Augmentation)必不可少,在图像训练中,通过旋转、翻转、调整亮度等手段,人为扩充数据集规模,防止模型过拟合。
第二步:模型架构选择与构建
选择合适的网络结构是开发中的关键决策。
经典架构参考
– CNN(卷积神经网络):处理图像、视频的首选,如ResNet、EfficientNet等变体,擅长提取空间特征。
– RNN/LSTM/Transformer:处理序列数据,如文本、语音,Transformer架构及其衍生模型(如BERT、GPT系列)已成为自然语言处理的事实标准。
– GAN(生成对抗网络):用于生成逼真图像或数据增强。
框架选型
目前主流框架为PyTorch和TensorFlow,PyTorch因其动态图机制和灵活的调试体验,在科研和快速原型开发中更受欢迎;TensorFlow则在生产环境部署和移动端支持上具有优势,开发者应根据团队技术栈和项目需求选择。
第三步:模型训练与超参数调优
训练过程是模型“学习”的阶段,需要监控多项指标。
损失函数与优化器
损失函数衡量预测值与真实值的差距,分类任务常用交叉熵损失,回归任务常用均方误差,优化器负责更新权重,Adam和AdamW是当前的主流选择,它们能自适应调整学习率。
防止过拟合策略
当模型在训练集表现极好但在测试集表现差时,即为过拟合,解决手段包括:
– Dropout:随机丢弃部分神经元,强制模型学习鲁棒特征。
– 早停法(Early Stopping):当验证集误差不再下降时,提前终止训练。
– 正则化:在损失函数中加入L1或L2正则项,限制权重大小。
第四步:评估、部署与监控
模型训练完成不代表项目结束,落地应用才是终点。
性能评估指标
不能仅看准确率,对于不平衡数据,需关注精确率(Precision)、召回率(Recall)和F1分数,在时序预测中,RMSE(均方根误差)和MAE(平均绝对误差)更为直观。
模型部署方案
将模型转化为API服务是常见做法,可使用Flask、FastAPI封装模型,或通过TorchServe、TensorFlow Serving进行专用部署,对于边缘设备,需将模型量化或剪枝,转换为ONNX或TFLite格式,以降低推理延迟和内存占用。
常见误区与实战避坑指南
在实际开发中,许多初学者容易陷入误区,导致项目进度延误或效果不佳。
数据越多越好
虽然大数据是深度学习的优势,但低质量的大量数据反而有害,清洗少量高质量数据,往往比直接使用海量噪声数据效果更好,建议先在小样本上跑通流程,验证可行性后再扩展数据规模。
盲目追求最新模型
并非所有场景都需要Transformer或超大参数模型,对于简单的表格数据,XGBoost或LightGBM可能比深度学习更快、更准、更易解释,应根据业务复杂度选择“够用且高效”的模型,而非“最强”的模型。
忽视模型的可解释性
在金融、医疗等高风险领域,黑盒模型难以被接受,使用SHAP值或LIME工具分析模型决策依据,不仅能帮助调试,还能增强用户信任。
未来趋势:自动化与低代码开发
随着AI技术的普及,开发门槛正在降低,AutoML(自动化机器学习)工具能够自动完成特征工程、模型选择和超参数调优,让非专家也能构建基础模型,大语言模型(LLM)的兴起,使得通过自然语言描述需求即可生成代码或配置模型成为可能。
对于开发者而言,掌握底层原理依然重要,但学会利用自动化工具提升效率,将是2026年及以后的核心竞争力,企业应关注如何将AI能力集成到现有业务流中,而非单纯追求技术新颖性。
Q&A:关于深度学习模型开发的常见疑问
深度学习模型开发需要多少算力支持?
算力需求取决于模型规模和训练数据量,小型模型在单张消费级GPU(如RTX 3090/4090)上即可训练;中型模型可能需要多卡并行或云端GPU实例;大型预训练模型则需集群加速,据统计,多数中小型企业项目可通过云服务商按需租用算力,无需自建机房,从而降低初始投入成本。
如何判断模型是否过拟合?
观察训练集和验证集的损失曲线,如果训练损失持续下降,而验证损失在某一时刻后开始上升,且两者差距拉大,则表明过拟合,此时应检查是否增加了正则化强度、减少模型复杂度或增加数据增强力度。
深度学习模型开发周期通常多长?
开发周期差异巨大,原型验证阶段可能只需几天到一周;完整的项目从数据准备到部署上线,通常需1-3个月,若涉及复杂的数据标注和反复的模型迭代,时间可能延长至半年以上,行业共识认为,数据准备往往占据总工时的40%-60%,是决定项目进度的关键瓶颈。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/332102.html