个人小型数据库实验报告的核心在于通过MySQL或SQLite等轻量级工具,在本地环境完成从建表、数据录入到复杂查询的全流程验证,从而掌握关系型数据库的基本操作逻辑与SQL语法规范。
在数字化办公与个人知识管理的背景下,构建一个专属的小型数据库已成为许多技术人员、学生及数据爱好者的刚需,这不仅是学习数据库原理的最佳实践,更是解决日常信息碎片化存储痛点的有效手段,本文将深入剖析个人小型数据库的实验过程,涵盖环境搭建、表结构设计、数据操作及性能优化等关键环节,帮助读者建立清晰的实操认知。

实验环境搭建与基础配置
选择适合个人的数据库引擎
对于个人用户而言,选择数据库引擎需权衡性能、便携性与学习成本,业内专家指出,MySQL因其广泛的社区支持和丰富的教程资源,成为初学者入门的首选;而SQLite则凭借无需服务器配置、单文件存储的特性,更适合嵌入式开发或轻量级个人应用。
- MySQL:适合需要模拟真实生产环境、学习复杂SQL语法及多用户并发处理的场景。
- SQLite:适合个人笔记管理、小型爬虫数据存储或作为移动应用的本地存储后端。
- PostgreSQL:适合对数据完整性要求极高、需要处理复杂地理信息或JSON数据的进阶用户。
本地开发环境的部署路径
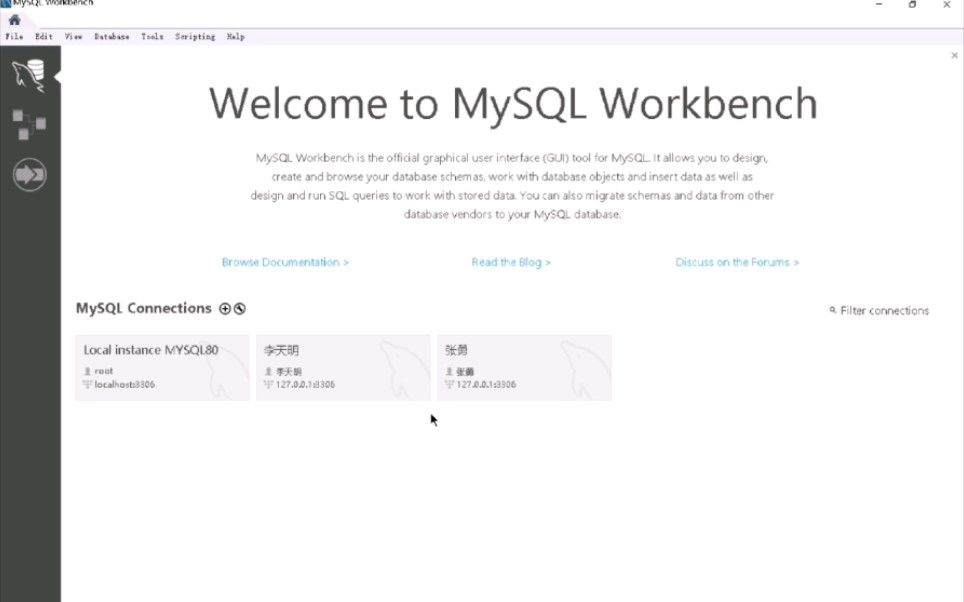
以MySQL为例,搭建本地环境通常涉及以下具体步骤,确保实验环境的纯净与稳定:
- 下载安装包:访问MySQL官方社区版页面,选择对应操作系统的安装包,Windows用户可选择MSI安装包,Mac用户可使用Homebrew命令
brew install mysql,Linux用户则通过包管理器安装。 - 初始化配置:运行安装程序时,务必设置强密码并记住root用户凭证,对于Windows用户,建议勾选“Add MySQL to PATH”以便在命令行直接调用。
- 图形化管理工具:虽然命令行功能强大,但图形界面能显著提升实验效率,推荐安装DBeaver或Navicat Lite,它们支持多数据库类型,便于直观查看表结构和数据。
表结构设计与数据建模
个人知识库的表结构设计实战
在“个人小型数据库实验报告”中,设计合理的表结构是核心环节,假设我们要构建一个“个人阅读笔记库”,需遵循第三范式(3NF)以减少数据冗余。
用户表(users)设计
| 字段名 | 类型 | 约束 | 说明 |
|---|---|---|---|
| user_id | INT | PRIMARY KEY, AUTO_INCREMENT | 用户唯一标识 |
| username | VARCHAR(50) | UNIQUE, NOT NULL | 用户名 |
| created_at | TIMESTAMP | DEFAULT CURRENT_TIMESTAMP | 创建时间 |
书籍表(books)设计
| 字段名 | 类型 | 约束 | 说明 |
|---|---|---|---|
| book_id | INT | PRIMARY KEY, AUTO_INCREMENT | 书籍唯一标识 |
| author | VARCHAR(100) | NOT NULL | 作者 |
| isbn | VARCHAR(13) | UNIQUE | ISBN编号 |
笔记表(notes)设计
此表通过外键关联用户与书籍,实现多对多关系的记录。
CREATE TABLE notes (
    note_id INT PRIMARY KEY AUTO_INCREMENT,
    user_id INT,
    book_id INT,
    content TEXT,
    rating TINYINT,
    FOREIGN KEY (user_id) REFERENCES users(user_id),
    FOREIGN KEY (book_id) REFERENCES books(book_id)
);
数据录入与完整性校验
数据录入并非简单的复制粘贴,而是对数据一致性的初步验证,在实验中,应模拟真实场景,录入不同格式的数据,并观察数据库的反馈。
- 批量导入:使用CSV文件通过
LOAD DATA INFILE命令快速导入大量测试数据,检验导入速度与错误处理机制。 - 约束测试:尝试插入违反唯一约束或外键约束的数据,观察数据库是否拒绝执行,以此验证表结构的健壮性。
SQL查询优化与性能分析
基础查询与聚合统计
掌握SELECT语句的高级用法是实验的重点,通过聚合函数,可以快速得出个人知识库的统计信息。
- 多表连接查询:使用
JOIN语句关联用户、书籍与笔记表,获取每位用户的阅读偏好分布。 - 分组统计:使用
GROUP BY结合COUNT()和AVG(),分析不同作者的书籍数量及平均评分。
索引创建与查询加速
随着数据量增加,查询效率成为关键,在个人小型数据库中,虽然数据量不大,但理解索引原理对后续扩展至关重要。
- 单列索引:在
books.title和users.username字段上创建索引,加速模糊查询和精确匹配。 - 复合索引:在
notes表的(user_id, created_at)上创建复合索引,优化按用户和时间排序的查询场景。
行业共识认为,索引并非越多越好,过多的索引会增加写入负担并占用存储空间,在实验报告中,需对比添加索引前后的查询执行计划(EXPLAIN),直观展示性能提升效果。
实验总结与常见问题排查
典型错误与解决方案
在个人小型数据库实验过程中,初学者常遇到以下问题,需结合具体报错信息进行排查:
- 连接拒绝:检查MySQL服务是否启动,防火墙是否放行3306端口,以及远程连接权限是否配置正确。
- 字符集乱码:确保数据库、表及连接字符集统一设置为
utf8mb4,避免中文数据出现乱码。 - 外键约束失败:插入数据时若提示外键约束失败,需检查父表是否存在对应记录,或子表字段类型是否与父表完全一致。
实验心得与进阶方向
通过本次个人小型数据库实验,不仅掌握了SQL语言的基本语法,更深刻理解了关系型数据库的设计哲学,数据建模的规范性、查询优化的必要性以及数据完整性的重要性,构成了数据库应用的三大支柱。
对于希望进一步提升的用户,建议探索以下进阶方向:
- 自动化备份:编写Shell或Python脚本,定期自动备份数据库文件,确保数据安全。
- API接口开发:结合Flask或Django框架,为个人数据库提供RESTful API,实现前后端分离的个人应用开发。
- NoSQL对比实验:尝试使用MongoDB存储非结构化数据,对比其与关系型数据库在不同场景下的优劣,拓宽技术视野。
个人小型数据库实验报告常见问题解答
个人小型数据库实验报告中如何选择合适的数据库引擎?
选择数据库引擎应基于具体应用场景,若需模拟企业级环境或学习复杂事务处理,MySQL是最佳选择,因其生态完善且资料丰富,若追求极致便携、无需服务器配置,或用于嵌入式设备、个人笔记存储,SQLite更为合适,其单文件特性便于迁移与管理,对于需要处理复杂JSON数据或地理信息的场景,PostgreSQL则是更专业的选择。
个人小型数据库实验报告中数据导入失败怎么办?
数据导入失败通常由字符集不匹配、文件格式错误或权限不足引起,首先检查CSV文件的编码是否为UTF-8,确保无BOM头,验证字段分隔符与数据库导入命令中的设置是否一致,确认数据库用户具有读取文件所在目录的权限,或尝试将文件复制到数据库服务器的安全目录(如MySQL的secure_file_priv指定路径)后再执行导入。
个人小型数据库实验报告中如何验证查询性能?
验证查询性能主要依赖数据库提供的执行计划分析工具,在MySQL中,使用 EXPLAIN 关键字置于SELECT语句之前,可输出查询的执行细节,包括是否使用索引、扫描行数及连接类型,通过对比添加索引前后的执行计划,观察type字段是否从ALL(全表扫描)提升为ref或range,即可直观评估索引对查询效率的提升效果。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/316294.html